
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
12 min de leitura
2 visualizações
Como transformar uma chamada síncrona frágil em trabalho reprocessável, sem duplicar custo nem perder avaliação
Chamar um modelo dentro do POST /tickets funciona até o dia em que não funciona.
O provedor fica lento e a latência do endpoint sobe junto. Um deploy do provedor derruba a avaliação e você perde a classificação de todos os tickets daquela janela — sem chance de recuperar, porque a informação nunca foi persistida como trabalho pendente. E quando alguém adiciona retry para melhorar a taxa de sucesso, a mesma avaliação passa a ser cobrada duas ou três vezes.
O padrão que resolve os três problemas de uma vez é antigo e conhecido: outbox. A novidade não é o padrão — é que, com LLM, a idempotência deixa de ser uma questão de elegância e vira controle de custo direto.
Em um pipeline CRUD, processar a mesma mensagem duas vezes gera uma linha duplicada que você corrige. Em um pipeline de IA, gera uma segunda fatura.
FOR UPDATE SKIP LOCKED evita que duas réplicas avaliem o mesmo item.Compare os dois desenhos no mesmo cenário: 200 mil tickets por mês, avaliação a US$ 0,011, provedor com 99,5% de disponibilidade e uma janela de 40 minutos de indisponibilidade no mês.
| Síncrono no request | Outbox + worker | |
|---|---|---|
latência do POST /tickets | 180 ms + latência do modelo | 180 ms |
| tickets sem avaliação após incidente | ~1.850, permanentemente | 0, após reprocessamento |
| custo com retry ingênuo (3x) | até US$ 6.600 | US$ 2.200 |
| avaliar de novo após melhorar o prompt | impossível sem script novo | operação de rotina |
A linha que mais importa é a terceira. Retry sem idempotência não é só um risco de consistência — é um multiplicador de fatura.
A regra central do outbox: o dado principal e a intenção de trabalho nascem juntos ou não nascem.
CREATE TABLE ticket (
    id           uuid PRIMARY KEY,
    subject      text NOT NULL,
    message      text NOT NULL,
    created_at   timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE evaluation_outbox (
    id               bigserial PRIMARY KEY,
    ticket_id        uuid NOT NULL REFERENCES ticket(id),
    idempotency_key  text NOT NULL UNIQUE,
    status           text NOT NULL DEFAULT 'pending',
    attempts         int  NOT NULL DEFAULT 0,
    available_at     timestamptz NOT NULL DEFAULT now(),
    locked_by        text,
    locked_until     timestamptz,
    last_error       text,
    created_at       timestamptz NOT NULL DEFAULT now()
);

-- índice que sustenta o claim: só o que está pronto para rodar
CREATE INDEX idx_outbox_claimable
    ON evaluation_outbox (available_at)
    WHERE status = 'pending';

CREATE TABLE evaluation_result (
    idempotency_key  text PRIMARY KEY,
    ticket_id        uuid NOT NULL REFERENCES ticket(id),
    is_urgent        double precision,
    department       text,
    urgency_score    double precision,
    model_version    text NOT NULL,
    prompt_version   text NOT NULL,
    policy_version   text NOT NULL,
    computed_at      timestamptz NOT NULL DEFAULT now()
);
Repare que evaluation_result tem a chave de idempotência como chave primária. Essa é a estrutura que torna a checagem "já avaliei isso?" uma consulta de índice único, e não uma varredura.
A escrita:
def create_ticket(conn, subject: str, message: str) -> Ticket:
    ticket_id = uuid4()
    key = idempotency_key(subject, message)

    with conn.transaction():                       # atômico: os dois ou nenhum
        conn.execute(
            "INSERT INTO ticket (id, subject, message) VALUES (%s, %s, %s)",
            (ticket_id, subject, message),
        )
        conn.execute(
            """INSERT INTO evaluation_outbox (ticket_id, idempotency_key)
               VALUES (%s, %s)
               ON CONFLICT (idempotency_key) DO NOTHING""",
            (ticket_id, key),
        )
    return Ticket(id=ticket_id, subject=subject, message=message, evaluation=None)
O ON CONFLICT DO NOTHING já resolve o caso do usuário que clicou duas vezes: dois tickets, um único trabalho de avaliação.
Aqui está a decisão que mais gente erra.
Se a chave de idempotência for um UUID aleatório ou incluir timestamp, ela é única por definição — e portanto inútil. Ela precisa ser determinística sobre aquilo que de fato determina o resultado.
import hashlib
import json

PROMPT_VERSION = "triage-v3"
MODEL_VERSION = "gpt-6-luna@medium"

def idempotency_key(subject: str, message: str) -> str:
    """Determinística sobre tudo que muda o resultado. Nada além disso."""
    payload = {
        "subject": subject.strip(),
        "message": message.strip(),
        "prompt": PROMPT_VERSION,
        "model": MODEL_VERSION,
    }
    blob = json.dumps(payload, sort_keys=True, ensure_ascii=False)
    return hashlib.sha256(blob.encode()).hexdigest()[:32]
O que entra e o que fica de fora tem consequência direta:
| Campo | Entra? | Por quê |
|---|---|---|
| conteúdo do estado | sim | muda o resultado |
| versão do prompt | sim | muda o resultado |
| modelo e nível de esforço | sim | muda o resultado e o custo |
ticket_id | não | dois tickets idênticos devem reaproveitar |
| timestamp | não | destrói a idempotência |
user_id | depende | só se a policy variar por usuário |
Deixar ticket_id de fora é a escolha que produz o ganho mais visível: em bases com muita duplicata — formulários reenviados, integrações que reentregam —, uma fatia relevante do volume nunca chega ao modelo.
E incluir a versão do prompt no hash dá algo de graça: mudar o prompt invalida o cache automaticamente. A versão nova gera chaves novas, e o reprocessamento acontece sem nenhuma migração.
Com múltiplos workers, o erro clássico é SELECT ... WHERE status='pending' seguido de UPDATE. Entre os dois comandos, outro worker leu a mesma linha.
FOR UPDATE SKIP LOCKED resolve isso em uma única ida ao banco:
CLAIM_SQL = """
UPDATE evaluation_outbox
SET status = 'processing',
    locked_by = %(worker)s,
    locked_until = now() + interval '5 minutes',
    attempts = attempts + 1
WHERE id IN (
    SELECT id FROM evaluation_outbox
    WHERE status = 'pending'
      AND available_at <= now()
    ORDER BY available_at
    FOR UPDATE SKIP LOCKED
    LIMIT %(batch)s
)
RETURNING id, ticket_id, idempotency_key, attempts;
"""

def claim(conn, worker_id: str, batch: int = 10) -> list[OutboxRow]:
    rows = conn.execute(CLAIM_SQL, {"worker": worker_id, "batch": batch}).fetchall()
    return [OutboxRow(*r) for r in rows]
SKIP LOCKED faz o worker pular linhas já travadas em vez de esperar por elas. Dez réplicas rodando o mesmo comando pegam dez lotes disjuntos, sem coordenação externa.
O locked_until cobre o worker que morre no meio do trabalho. Um varredor devolve o item à fila quando o lock expira:
UPDATE evaluation_outbox
SET status = 'pending', locked_by = NULL, locked_until = NULL
WHERE status = 'processing' AND locked_until < now();
Esse varredor é o que garante entrega pelo menos uma vez. Quem garante que "pelo menos uma vez" não vira "cobrado duas vezes" é o passo seguinte.
def process(conn, row: OutboxRow, client, deadline_s: float = 30.0) -> None:
    # 1. o resultado já existe para esta chave? então não chame o modelo.
    cached = conn.execute(
        "SELECT * FROM evaluation_result WHERE idempotency_key = %s",
        (row.idempotency_key,),
    ).fetchone()

    if cached is not None:
        metrics.increment("outbox.dedup_hit")
        finish(conn, row.id, status="done")
        return

    # 2. só agora custa dinheiro
    try:
        raw = client.evaluate(
            state=load_state(conn, row.ticket_id),
            questions=TRIAGE_QUESTIONS,
            timeout=deadline_s,
        )
    except TransientError as error:
        reschedule(conn, row, error)              # volta para a fila
        return
    except PermanentError as error:
        dead_letter(conn, row, error)             # não adianta repetir
        return

    evaluation = validate(raw)
    if evaluation is None:
        dead_letter(conn, row, "contract_violation")
        return

    # 3. persistir resultado e fechar o item na mesma transação
    with conn.transaction():
        conn.execute(
            """INSERT INTO evaluation_result
               (idempotency_key, ticket_id, is_urgent, department, urgency_score,
                model_version, prompt_version, policy_version)
               VALUES (%s, %s, %s, %s, %s, %s, %s, %s)
               ON CONFLICT (idempotency_key) DO NOTHING""",
            (row.idempotency_key, row.ticket_id, evaluation.is_urgent,
             evaluation.department, evaluation.urgency_score,
             MODEL_VERSION, PROMPT_VERSION, POLICY_VERSION),
        )
        finish(conn, row.id, status="done")
O bloco 1 é a diferença entre um pipeline que reprocessa de graça e um que reprocessa pagando. Ele transforma "pelo menos uma vez" na entrega em "exatamente uma vez" no efeito cobrável, que é a propriedade que realmente interessa.
A métrica outbox.dedup_hit merece painel próprio. Ela mostra quanto dinheiro a idempotência está economizando, e costuma surpreender.
Nem toda falha merece nova tentativa. Misturar as duas categorias é o que enche a fila de trabalho inútil.
TRANSIENT = (TimeoutError, RateLimited, ProviderUnavailable, ConnectionError)
MAX_ATTEMPTS = 5

def reschedule(conn, row: OutboxRow, error: Exception) -> None:
    if row.attempts >= MAX_ATTEMPTS:
        dead_letter(conn, row, f"max attempts: {error}")
        return

    # backoff exponencial com jitter determinístico por chave
    base = min(2 ** row.attempts, 300)
    jitter = int(row.idempotency_key[:4], 16) % 30       # espalha o rebanho
    delay = base + jitter

    conn.execute(
        """UPDATE evaluation_outbox
           SET status = 'pending',
               available_at = now() + make_interval(secs => %s),
               locked_by = NULL, locked_until = NULL, last_error = %s
           WHERE id = %s""",
        (delay, str(error)[:500], row.id),
    )

def dead_letter(conn, row: OutboxRow, reason: str) -> None:
    conn.execute(
        "UPDATE evaluation_outbox SET status = 'dead', last_error = %s WHERE id = %s",
        (reason[:500], row.id),
    )
    metrics.increment("outbox.dead_letter", tags={"reason": classify(reason)})
O jitter derivado da própria chave, em vez de random, mantém o comportamento reprodutível — útil quando você precisa explicar por que cem itens voltaram exatamente no mesmo segundo.
E a fila dead não é um cemitério. Ela é uma lista de bugs esperando triagem. Um alerta simples basta:
SELECT classify(last_error) AS motivo, count(*), max(created_at)
FROM evaluation_outbox
WHERE status = 'dead' AND created_at > now() - interval '1 day'
GROUP BY 1 ORDER BY 2 DESC;
Melhorou o prompt. Trocou o modelo. Ajustou os critérios. Agora você quer reavaliar os últimos trinta dias.
Com chave derivada do conteúdo e da versão, isso é uma inserção:
def reprocess(conn, since: datetime, new_prompt_version: str) -> int:
    """Reenfileira avaliações sob uma versão nova de prompt."""
    rows = conn.execute(
        "SELECT id, subject, message FROM ticket WHERE created_at >= %s", (since,)
    ).fetchall()

    inserted = 0
    for ticket_id, subject, message in rows:
        key = idempotency_key_with(subject, message, prompt=new_prompt_version)
        result = conn.execute(
            """INSERT INTO evaluation_outbox (ticket_id, idempotency_key, available_at)
               VALUES (%s, %s, now() + (random() * interval '30 minutes'))
               ON CONFLICT (idempotency_key) DO NOTHING
               RETURNING id""",
            (ticket_id, key),
        ).fetchone()
        inserted += 1 if result else 0
    return inserted
Dois detalhes deliberados: o available_at espalhado em trinta minutos evita que 200 mil itens batam no provedor ao mesmo tempo, e o ON CONFLICT garante que rodar o script duas vezes não duplica nada.
Como a versão antiga continua em evaluation_result, você pode comparar as duas antes de promover — que é exatamente o modo shadow aplicado a dados históricos.
| Métrica | Sinal |
|---|---|
profundidade da fila pending | worker não acompanha a produção |
| idade do item mais antigo | melhor sinal de atraso que a profundidade |
dedup_hit por hora | quanto a idempotência está economizando |
| tentativas médias até sucesso | acima de 1,5 indica erro sistêmico |
dead_letter por motivo | fila de bugs, não cemitério |
| itens com lock expirado | workers morrendo no meio do trabalho |
A idade do item mais antigo é a métrica mais honesta. Uma fila de 50 mil itens processando rápido é saudável; uma fila de 200 itens parada há seis horas não é.
Sejamos justos com a complexidade que isso adiciona. Outbox não vale a pena quando:
Para tudo que é enriquecimento assíncrono de um dado que já foi persistido, ele é quase sempre a escolha certa.
ticket_id, timestamp e aleatoriedade estão fora da chave.FOR UPDATE SKIP LOCKED.Outbox não é sobre elegância arquitetural. É sobre três propriedades concretas: o endpoint principal para de depender da latência do modelo, o trabalho perdido em um incidente vira trabalho pendente, e a mesma avaliação para de ser cobrada duas vezes.
A terceira é a que muda o cálculo em relação a pipelines tradicionais. Em CRUD, reprocessar é um incômodo. Com LLM, é uma segunda fatura — e a única defesa é uma chave derivada do conteúdo, consultada antes da chamada.
Se você guarda essa chave, o resto do padrão se monta sozinho: retry fica seguro, reprocessamento vira rotina, e melhorar o prompt deixa de ser uma decisão irreversível.
Os exemplos usam PostgreSQL 16 e psycopg 3.
FOR UPDATE SKIP LOCKEDexiste desde o Postgres 9.5; em outros bancos, verifique o equivalente antes de copiar o padrão.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis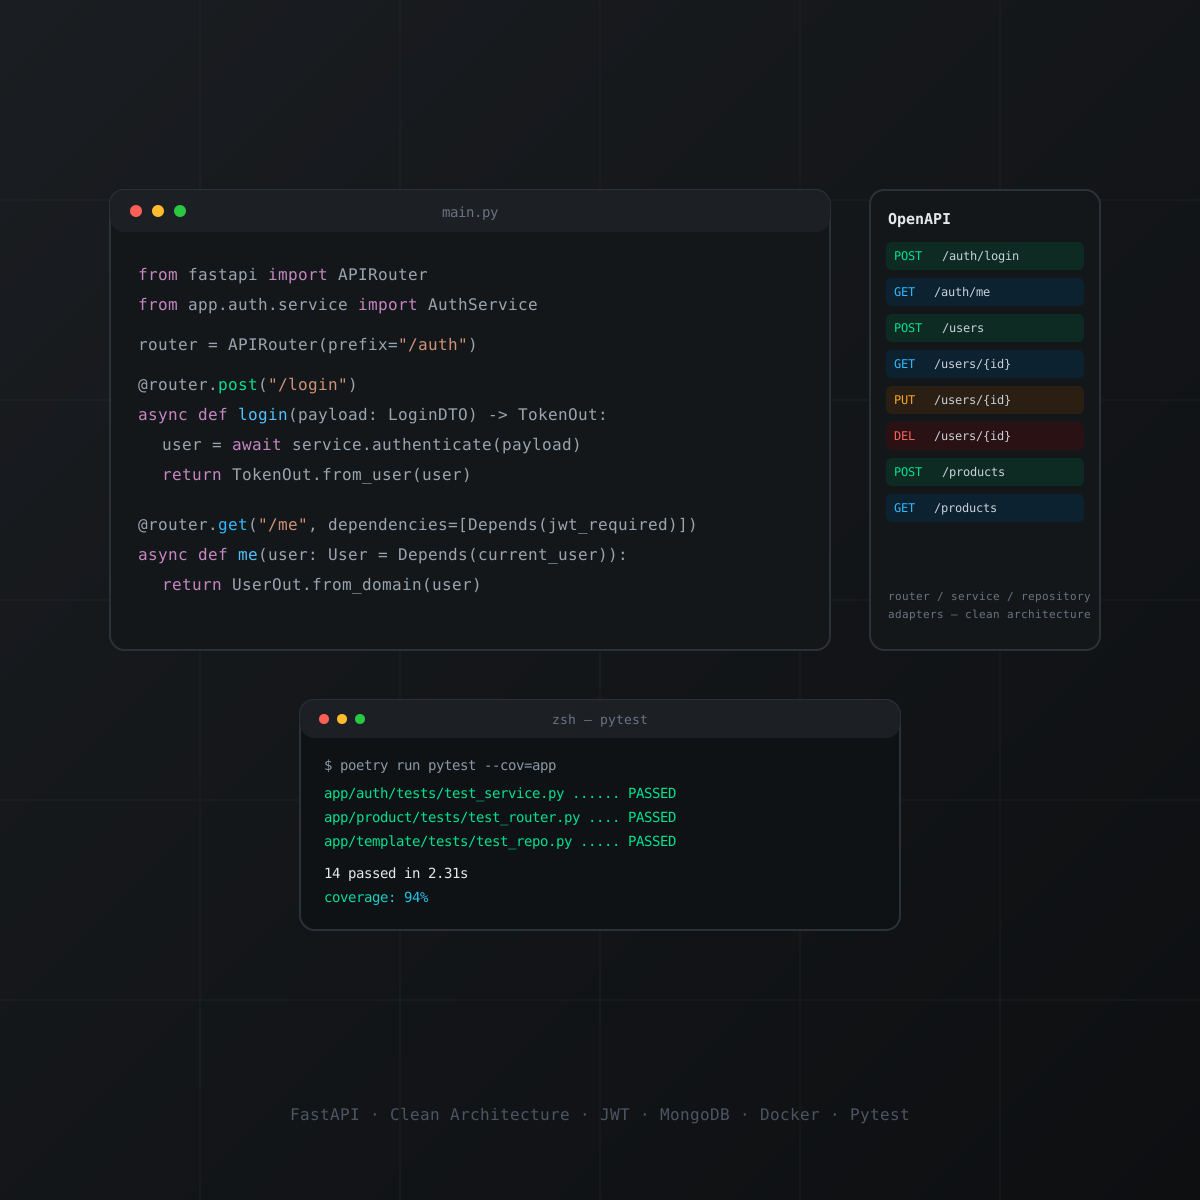
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto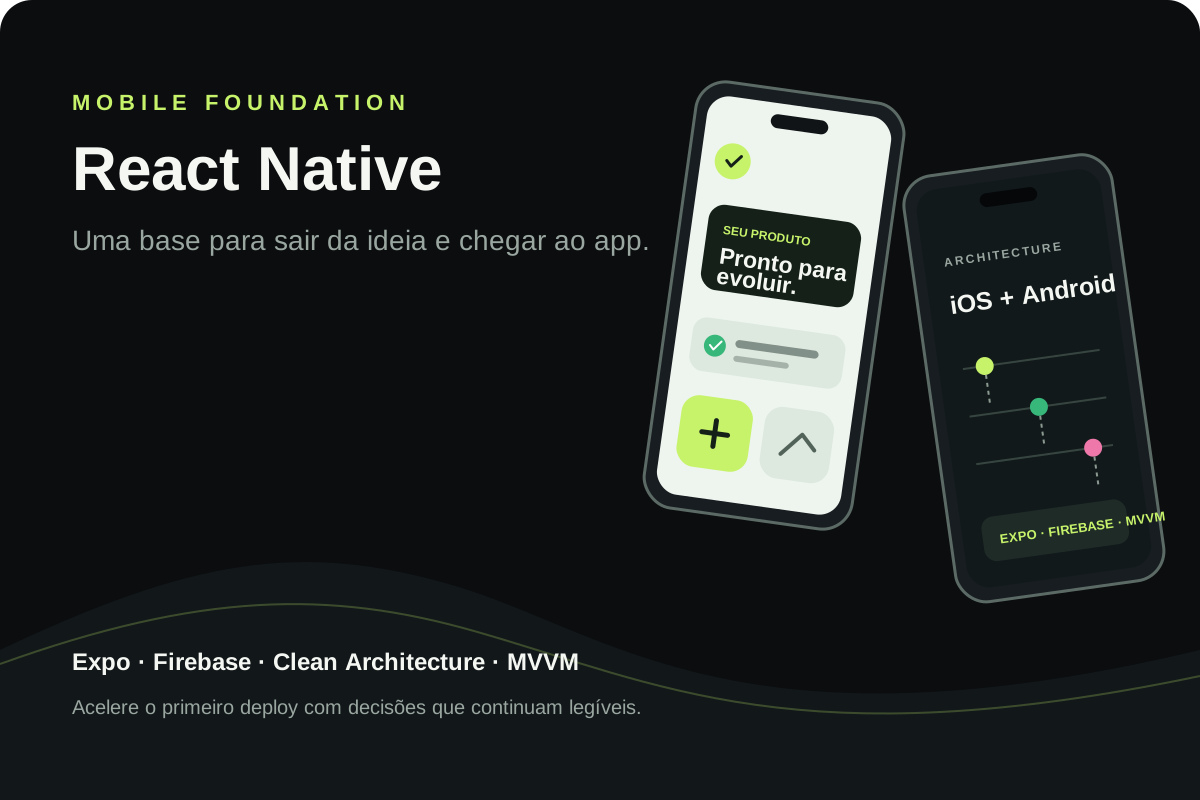
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Se você não consegue desligar a IA sem derrubar a funcionalidade principal, o boundary está no lugar errado. Este artigo mostra como descobrir isso antes do incidente.

Com 1,05M de tokens de janela, a tentação é óbvia: joga tudo dentro. A conta de custo, a curva de atenção e a pergunta “de onde veio essa informação?” explicam por que isso raramente funciona.

Seis meses depois, alguém pergunta por que o sistema classificou aquele caso assim. Se a resposta depende de lembrar qual prompt estava no ar, você não tem sistema auditável — tem folclore.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
