
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
10 min de leitura
3 visualizações
A janela ficou enorme e barata, e mesmo assim jogar tudo dentro dela continua sendo a escolha errada na maioria dos casos
Toda geração de modelos com janela maior reacende a mesma previsão: "agora o RAG morreu, é só jogar tudo no contexto".
Em setembro de 2026, com 1,05 milhão de tokens virando padrão de mercado e preço de entrada em US$ 0,10 por milhão, a previsão parece finalmente razoável. Cabe muita coisa, e cabe barato.
Só que "cabe" e "funciona" são perguntas diferentes. Três coisas continuam verdadeiras: você paga pelo contexto a cada requisição, o prefill custa tempo antes do primeiro token, e a atenção não é uniforme ao longo da janela.
Este artigo faz as contas e chega numa conclusão menos empolgante e mais útil: a arquitetura que vence quase sempre usa os dois.
def compare_cost(
    corpus_tokens: int,
    requests_per_day: int,
    price_in_per_1m: float = 0.10,
    cached_price_per_1m: float = 0.01,
    cache_hit_rate: float = 0.0,
    rag_chunk_tokens: int = 6_000,
    embedding_price_per_1m: float = 0.02,
) -> dict:
    # contexto longo: paga o corpus inteiro toda vez
    billed = corpus_tokens * (1 - cache_hit_rate) * price_in_per_1m
    cached = corpus_tokens * cache_hit_rate * cached_price_per_1m
    long_daily = (billed + cached) / 1e6 * requests_per_day

    # rag: paga a indexação uma vez, depois só os trechos recuperados
    index_once = corpus_tokens / 1e6 * embedding_price_per_1m
    rag_daily = rag_chunk_tokens / 1e6 * price_in_per_1m * requests_per_day

    return {
        "contexto_longo_dia": round(long_daily, 2),
        "rag_dia": round(rag_daily, 2),
        "rag_indexacao_unica": round(index_once, 4),
        "razao": round(long_daily / rag_daily, 1) if rag_daily else None,
    }
Corpus de 800 mil tokens, 30 mil requisições por dia, sem cache:
compare_cost(800_000, 30_000)
# {'contexto_longo_dia': 2400.0, 'rag_dia': 18.0,
#  'rag_indexacao_unica': 0.016, 'razao': 133.3}
US$ 2.400 por dia contra US$ 18. A indexação inteira custou menos de dois centavos, uma única vez.
A razão de 133× não é um detalhe de otimização. É a diferença entre uma funcionalidade viável e uma inviável.
Se o corpus é o mesmo para todas as requisições, o cache de entrada com 90% de desconto muda bastante:
compare_cost(800_000, 30_000, cache_hit_rate=0.95)
# {'contexto_longo_dia': 348.0, 'rag_dia': 18.0, 'razao': 19.3}
De 133× para 19×. Melhor, e ainda longe de empatar.
E o cache só funciona sob condições específicas: prefixo idêntico byte a byte, estável no tempo, compartilhado entre requisições. Se o corpus varia por usuário — que é o caso da maioria dos produtos —, a taxa de acerto despenca e você volta para os US$ 2.400.
Custo aparece na fatura no fim do mês. Latência aparece na cara do usuário agora.
Processar o contexto antes de gerar o primeiro token — o prefill — escala com o tamanho da janela:
| Contexto | Prefill típico | Tempo até o primeiro token |
|---|---|---|
| 8 k | ~0,2 s | rápido |
| 100 k | ~1,5 s | perceptível |
| 500 k | ~7 s | ruim para interativo |
| 1 M | ~15 s | inviável para chat |
Os números variam por modelo, hardware e otimização de cache, mas a forma da curva não muda: contexto grande empurra o primeiro token para longe.
RAG inverte a distribuição. Você paga uma busca vetorial — tipicamente dezenas de milissegundos — e entra no modelo com uma janela pequena. O tempo até o primeiro token fica quase constante, independente do tamanho do corpus.
Para qualquer coisa conversacional, essa é frequentemente a razão decisiva, antes mesmo do custo.
O terceiro fator é o menos intuitivo e o mais teimoso.
Modelos recuperam melhor informação posicionada no começo e no fim da janela do que no meio. Janelas maiores não eliminaram o efeito; elas apenas deram mais espaço para o miolo crescer.
Isso significa que "está no contexto" não é o mesmo que "o modelo vai usar". Um documento crítico enterrado no token 400.000 pode ser efetivamente invisível para a resposta.
Um teste barato mede isso no seu corpus, em vez de confiar em benchmark de terceiro:
def needle_test(client, corpus_chunks, needle: str, question: str, positions=(0.0, 0.25, 0.5, 0.75, 1.0)):
    """Insere um fato em posições diferentes e mede a taxa de recuperação."""
    results = {}
    for pos in positions:
        idx = int(len(corpus_chunks) * pos)
        salted = corpus_chunks[:idx] + [needle] + corpus_chunks[idx:]
        answer = client.complete("\n".join(salted) + f"\n\n{question}")
        results[f"{pos:.0%}"] = needle_fact_present(answer)
    return results

# resultado típico: forte nas pontas, fraco no miolo
# {'0%': True, '25%': True, '50%': False, '75%': True, '100%': True}
Rode isso com o seu conteúdo real antes de decidir jogar tudo na janela. Se o miolo falha, contexto longo não é uma solução de recuperação — é uma aposta.
Com RAG, a resposta vem com endereço:
{
  "answer": "O prazo de reembolso é de 30 dias corridos.",
  "sources": [
    {"doc": "politica-reembolso-v4.pdf", "chunk": 12, "score": 0.89},
    {"doc": "faq-financeiro.md", "chunk": 3, "score": 0.71}
  ]
}
Com contexto longo, você tem a resposta e a suposição de que ela veio da parte certa dos 800 mil tokens.
Em suporte ao cliente, jurídico, saúde ou finanças, isso não é um detalhe de produto. É a diferença entre uma resposta utilizável e uma que ninguém pode assinar embaixo.
Há um meio-termo razoável: pedir citação explícita mesmo em contexto longo, com IDs de seção no material. Funciona parcialmente, e continua sem oferecer a garantia estrutural que a recuperação dá — o modelo pode citar uma seção e ter usado outra.
Não é uma lista vazia. Existem casos em que RAG é a escolha errada:
O corpus é pequeno e cabe inteiro. Menos de ~50 mil tokens, estável. Montar pipeline de embeddings, índice e reranking para isso é over-engineering.
A tarefa exige o documento inteiro. Resumir um contrato de 200 páginas, encontrar contradições entre cláusulas distantes, rastrear um argumento ao longo de um livro. Recuperação por trecho quebra justamente a relação entre partes distantes que a tarefa precisa.
O raciocínio atravessa muitos saltos. Perguntas que exigem combinar cinco fatos espalhados costumam falhar com top-k, porque o trecho relevante para o quinto salto não se parece com a pergunta original.
É uma tarefa única, não um produto. Análise pontual de um corpus que você nunca mais vai consultar. Custo de indexação não se amortiza.
Conversa longa. O histórico da sessão é naturalmente linear e relevante por inteiro. Resumir turnos antigos ainda ajuda, mas recuperação por similaridade raramente melhora.
A escolha real quase nunca é binária. É quanto recuperar antes de entrar no modelo.
Com janela grande e barata, você pode ser generoso na recuperação — o que remove a parte mais frágil do RAG clássico, que é acertar o top_k pequeno.
def hybrid_context(query: str, index, budget_tokens: int = 60_000) -> list[Chunk]:
    """Recupera generosamente e deixa a janela grande absorver a imprecisão."""
    # 1. busca híbrida: semântica + léxica cobre falhas diferentes
    dense = index.search_dense(query, k=80)
    sparse = index.search_bm25(query, k=80)
    merged = reciprocal_rank_fusion(dense, sparse)

    # 2. rerank para ordenar bem o começo da janela
    ranked = reranker.rank(query, merged[:60])

    # 3. preencher até o orçamento, não até um k fixo
    selected, used = [], 0
    for chunk in ranked:
        if used + chunk.tokens > budget_tokens:
            break
        selected.append(chunk)
        used += chunk.tokens

    # 4. o mais relevante no início e no fim — evita o miolo fraco
    return interleave_by_relevance(selected)
Quatro escolhas deliberadas aqui:
Busca híbrida. Densa erra em nomes próprios, códigos e termos raros; léxica erra em paráfrase. Juntas cobrem falhas diferentes.
Orçamento em tokens, não top_k. Trechos têm tamanhos diferentes. Orçamento em tokens é a unidade que realmente restringe.
60 mil em vez de 6 mil. Com contexto grande e barato, ser generoso é acessível — e a precisão da recuperação deixa de ser o ponto único de falha.
Posicionamento consciente. Colocar o mais relevante nas pontas contorna, em vez de ignorar, a degradação do miolo.
Esse desenho fica com custo por requisição na casa de US$ 0,006 — uma ordem de grandeza abaixo do contexto cheio — e recall muito acima do RAG com top_k=5.
| Situação | Escolha | Por quê |
|---|---|---|
| corpus < 50k tokens, estável | contexto longo | pipeline não se paga |
| corpus grande, consultas pontuais | RAG ou híbrido | paga o corpus uma vez |
| precisa citar a fonte | RAG | garantia estrutural |
| resumo ou análise do documento inteiro | contexto longo | trecho quebra a relação |
| raciocínio multi-salto | híbrido generoso | top-k pequeno perde saltos |
| chat interativo, p99 apertado | RAG | prefill domina a latência |
| corpus por usuário | RAG | cache não ajuda |
| corpus compartilhado e estável | contexto longo + cache | 90% de desconto muda a conta |
| domínio regulado | RAG | auditabilidade não é opcional |
top_k fixo.A janela de 1 milhão de tokens não tornou o RAG obsoleto. Ela mudou o tamanho ótimo do que você recupera.
Antes, com janelas de 8 mil, o RAG precisava ser cirúrgico: top_k=3 e reze. Essa precisão era o ponto frágil de todo o sistema. Agora você pode recuperar sessenta mil tokens de material provavelmente relevante e deixar o modelo filtrar — o que é muito mais robusto do que acertar os três trechos certos.
A conta continua clara: contexto longo cobra por requisição, índice cobra uma vez. A 133× de diferença no cenário deste artigo, "jogar tudo dentro" não é simplicidade, é uma decisão de custo que alguém vai questionar.
E se o seu domínio exige responder "de onde veio isso?", a discussão sobre custo e latência nem chega a acontecer.
Os preços usados são um snapshot de 22 de setembro de 2026. Os tempos de prefill são ordens de grandeza típicas e variam bastante por modelo, hardware e otimização; meça no seu ambiente antes de decidir.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis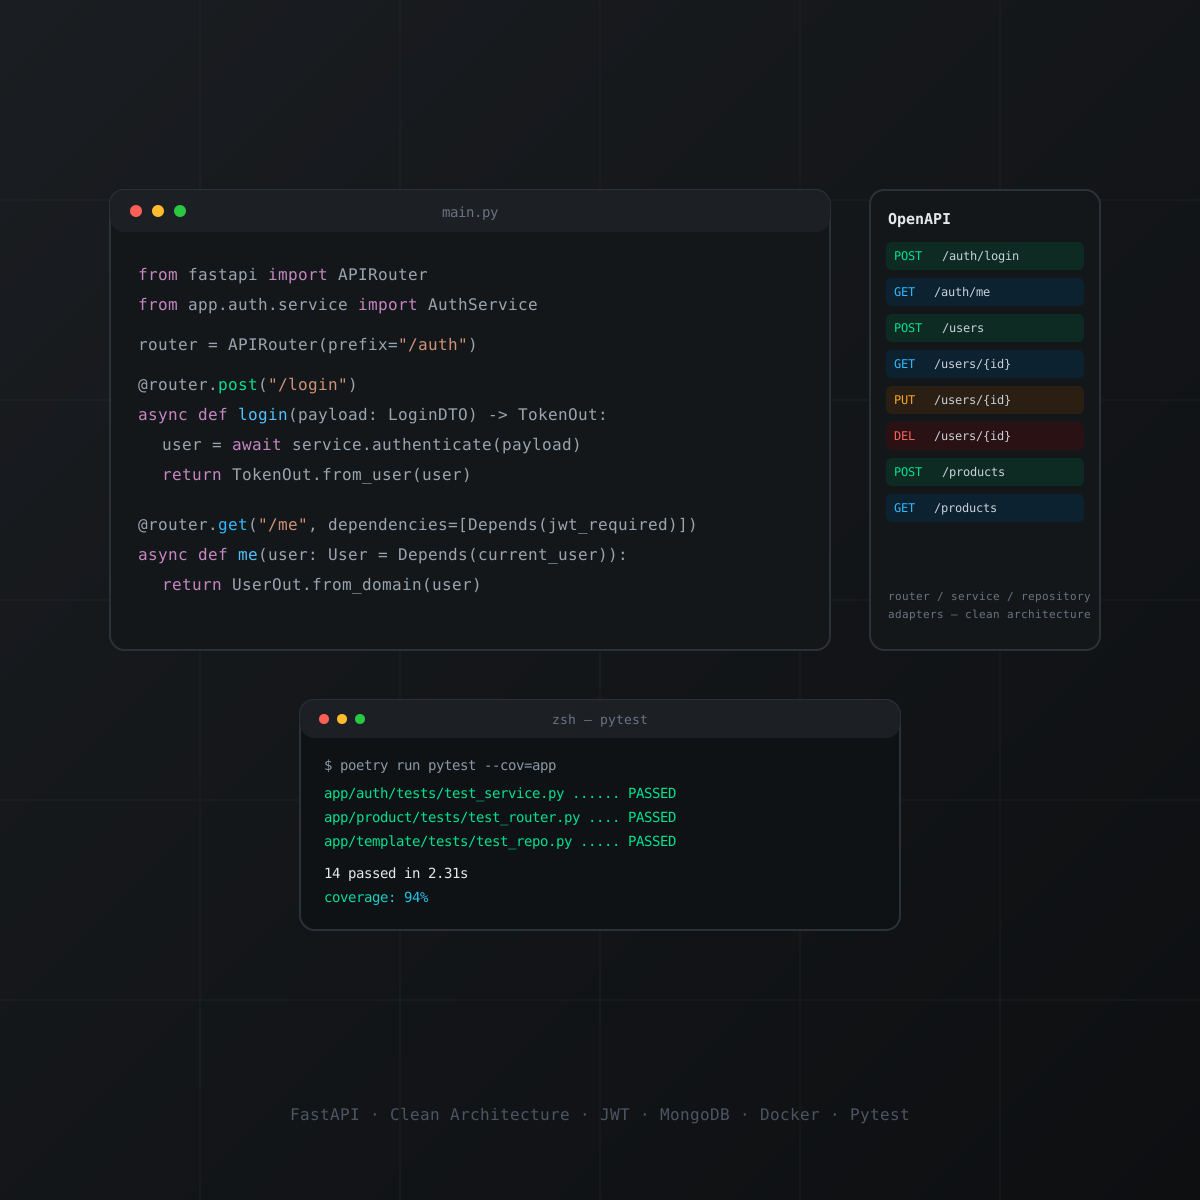
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto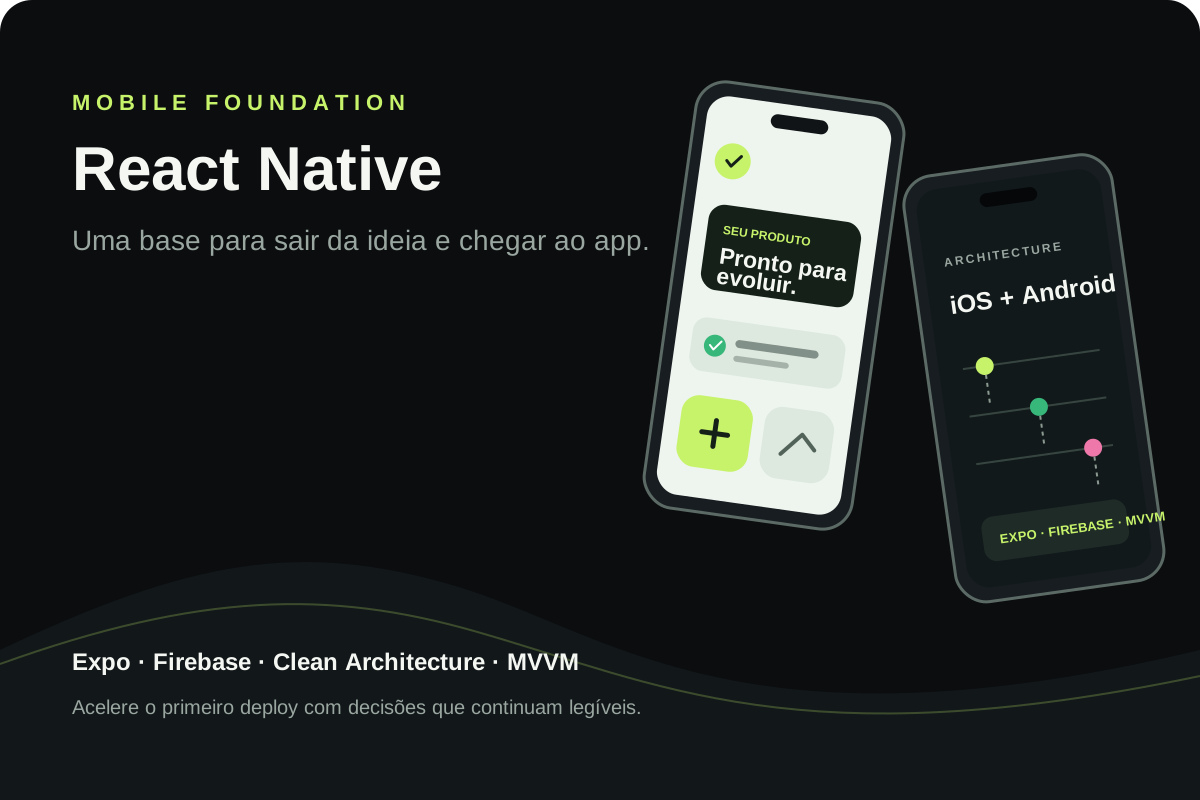
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
Este artigo cobre RAG (Retrieval-Augmented Generation) do zero ao avançado: o que é, como funciona cada camada do pipeline, como escolher entre chunking strategies, embedding models, vector databases e retrieval approaches, como avaliar qualidade, quando usar RAG versus fine-tuning, e como operar um sistema RAG em produção sem criar incidentes caros.

Preço por token é o número do fornecedor. Custo por tarefa concluída é o seu. Entre os dois existem retries, tarefas que falham, contexto que cresce e um nível de esforço que ninguém varre.

Se você não consegue desligar a IA sem derrubar a funcionalidade principal, o boundary está no lugar errado. Este artigo mostra como descobrir isso antes do incidente.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
