
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
10 min de leitura
2 visualizações
Circuit breaker, fallback tipado e a pergunta que revela se o seu boundary está no lugar certo
Existe uma pergunta que separa integrações de IA maduras das improvisadas, e ela cabe em uma linha:
Se o provedor de modelo ficar indisponível por duas horas, o que para de funcionar?
Se a resposta for "a triagem automática fica desligada e os tickets entram sem classificação", você tem um produto resiliente. Se for "o POST /tickets retorna 500", você tem uma dependência crítica que ninguém decidiu conscientemente criar.
A segunda resposta é a mais comum, e quase nunca é intencional. Ela aparece porque o modelo foi adicionado dentro do caminho da requisição, e nada no código diz o que fazer quando ele não responde.
Este artigo é sobre construir a primeira resposta de propósito.
A mesma API pode ser enriquecimento em um fluxo e crítica em outro. A classificação é por uso.
| Classe | Exemplo | Falha para | Dado principal |
|---|---|---|---|
| enriquecimento | triagem de ticket, tags automáticas, sumário | aberto | entra sem o enriquecimento |
| assistência | sugestão de resposta, autocomplete, rascunho | aberto, silencioso | usuário trabalha sem sugestão |
| crítico | moderação, detecção de fraude, autorização | fechado | bloqueia ou exige humano |
A regra por trás disso é antiga e continua valendo: falhe aberto quando a ausência do recurso é um inconveniente; falhe fechado quando a ausência é um risco.
Um erro frequente é tratar moderação como enriquecimento. Se o classificador de conteúdo cai e o sistema publica tudo por padrão, você não construiu degradação graciosa — construiu um bypass de segurança com aparência de resiliência.
from enum import Enum

class Criticality(str, Enum):
    ENRICHMENT = "enrichment"     # ausência é inconveniente
    ASSISTANCE = "assistance"     # ausência é invisível
    CRITICAL = "critical"         # ausência é risco

FALLBACK_POLICY = {
    Criticality.ENRICHMENT: "proceed_without",
    Criticality.ASSISTANCE: "proceed_silent",
    Criticality.CRITICAL: "require_human",
}
Coloque isso em configuração, ao lado da feature. Quando alguém adicionar uma chamada nova, a classe é uma decisão explícita, não um esquecimento.
timeout=30 é o número que as pessoas escrevem quando não mediram nada. Ele é longo demais para o usuário e curto demais para o pior caso legítimo.
O timeout correto sai da distribuição real:
timeout = p95_observado × 1.5, limitado pelo orçamento de latência do endpoint
Se o p95 da avaliação é 700 ms e o POST /tickets tem orçamento total de 1,5 s, o timeout fica em ~1,05 s — e não 30 s. A chamada que passar disso não vale a pena esperar: o usuário já foi embora.
import httpx

class Timeouts:
    """Timeouts derivados de medição, não de hábito."""
    CONNECT = 1.0          # handshake deve ser rápido ou não vai acontecer
    READ = 1.05            # p95 (700ms) x 1.5
    TOTAL = 2.0            # teto absoluto incluindo retry

    @classmethod
    def httpx(cls) -> httpx.Timeout:
        return httpx.Timeout(connect=cls.CONNECT, read=cls.READ, write=1.0, pool=1.0)
Separe connect de read. Falha de conexão é quase sempre rápida e indica indisponibilidade; leitura lenta indica sobrecarga. Tratar os dois com o mesmo número esconde qual dos dois está acontecendo.
E defina um deadline total que inclua os retries. Sem ele, três tentativas com backoff transformam um timeout de 1 s em 7 s de espera.
import time

class Deadline:
    def __init__(self, budget_s: float):
        self.expires_at = time.monotonic() + budget_s

    @property
    def remaining(self) -> float:
        return max(0.0, self.expires_at - time.monotonic())

    def expired(self) -> bool:
        return self.remaining <= 0.0
Quando o provedor está fora, cada requisição paga o timeout inteiro antes de falhar. Com tráfego, isso vira fila: threads presas, pool esgotado, e a lentidão contamina endpoints que nem usam IA.
O circuit breaker corta isso. Depois de N falhas consecutivas, ele para de tentar por um período e falha imediatamente.
import time
from enum import Enum

class State(str, Enum):
    CLOSED = "closed"        # operação normal
    OPEN = "open"            # falhando rápido, sem chamar
    HALF_OPEN = "half_open"  # testando uma requisição

class CircuitBreaker:
    def __init__(self, threshold: int = 5, recovery_s: float = 30.0):
        self.threshold = threshold
        self.recovery_s = recovery_s
        self.failures = 0
        self.opened_at = 0.0
        self.state = State.CLOSED

    def allow(self) -> bool:
        if self.state is State.OPEN:
            if time.monotonic() - self.opened_at >= self.recovery_s:
                self.state = State.HALF_OPEN     # deixa uma passar para testar
                return True
            return False
        return True

    def record_success(self) -> None:
        self.failures = 0
        self.state = State.CLOSED

    def record_failure(self) -> None:
        self.failures += 1
        if self.state is State.HALF_OPEN or self.failures >= self.threshold:
            self.state = State.OPEN
            self.opened_at = time.monotonic()
            metrics.increment("llm.circuit_opened")
Dois detalhes que costumam sair errado:
Só conte como falha o que é falha de disponibilidade. Timeout, 5xx, 429 e erro de conexão contam. Uma resposta válida que não passou na validação semântica não conta — ela indica problema de contrato, não de saúde do provedor, e abrir o circuito por isso mascara o bug real.
O estado precisa ser compartilhado em múltiplas instâncias. Um breaker em memória de processo significa que dez réplicas abrem o circuito dez vezes, cada uma pagando suas cinco falhas. Em escala, use Redis com TTL.
Este é o erro mais sutil da lista, e o que mais gera bug em produção.
Quando a avaliação falha, muita gente devolve None, {} ou uma string vazia — e o restante do sistema, que esperava um objeto tipado, quebra três camadas adiante.
O fallback precisa ser indistinguível em forma do caminho feliz. Só o conteúdo muda, e existe um campo dizendo que ele é degradado.
from dataclasses import dataclass

@dataclass(frozen=True)
class Evaluation:
    is_urgent: float | None
    department: str | None
    urgency_score: float | None
    source: str                    # "model" | "heuristic" | "unavailable"
    degraded: bool = False

    @classmethod
    def unavailable(cls) -> "Evaluation":
        return cls(None, None, None, source="unavailable", degraded=True)

    @classmethod
    def from_heuristic(cls, subject: str, message: str) -> "Evaluation":
        text = f"{subject} {message}".lower()
        urgent = any(w in text for w in ("fora do ar", "urgente", "parou", "bloqueado"))
        return cls(
            is_urgent=0.8 if urgent else 0.2,
            department="technical" if "erro" in text else None,
            urgency_score=2.0 if urgent else 0.5,
            source="heuristic",
            degraded=True,
        )
O campo source é o que torna a degradação observável. Sem ele, um painel de qualidade mistura decisões do modelo com decisões de heurística e ninguém percebe que 40% do tráfego rodou degradado durante o incidente.
A heurística não precisa ser boa. Ela precisa ser honesta sobre ser heurística. Uma regra de palavras-chave que acerta 60% dos urgentes é infinitamente melhor que nada, desde que a interface mostre que aquela classificação não veio do modelo.
class TriageService:
    def __init__(self, client, breaker: CircuitBreaker, criticality: Criticality):
        self.client = client
        self.breaker = breaker
        self.criticality = criticality

    def evaluate(self, subject: str, message: str, deadline: Deadline) -> Evaluation:
        if not self.breaker.allow():
            metrics.increment("llm.skipped_circuit_open")
            return self._degrade(subject, message)

        if deadline.expired():
            metrics.increment("llm.skipped_deadline")
            return self._degrade(subject, message)

        try:
            raw = self.client.evaluate(
                state={"subject": subject, "message": message},
                timeout=min(Timeouts.READ, deadline.remaining),
            )
        except (ProviderUnavailable, TimeoutError) as error:
            self.breaker.record_failure()
            logger.bind(error=str(error)).warning("provider indisponível")
            return self._degrade(subject, message)

        self.breaker.record_success()

        evaluation = validate(raw)
        if evaluation is None:                      # contrato violado
            metrics.increment("llm.contract_violation")
            return self._degrade(subject, message)  # não conta para o breaker
        return evaluation

    def _degrade(self, subject: str, message: str) -> Evaluation:
        if self.criticality is Criticality.CRITICAL:
            raise RequiresHumanReview("julgamento indisponível para fluxo crítico")
        return Evaluation.from_heuristic(subject, message)
Leia o fluxo de cima para baixo: circuito, deadline, chamada, contrato. Cada porta tem uma métrica própria, e a distinção entre skipped_circuit_open, skipped_deadline e contract_violation é o que permite diagnosticar um incidente sem ler log.
Feature flag para IA não é luxo de time grande. É o único jeito de desligar sem deploy.
def triage_enabled(tenant_id: str) -> bool:
    if flags.get("triage.kill_switch"):            # desliga global, imediato
        return False
    if tenant_id in flags.get("triage.blocklist", []):
        return False
    return hash_bucket(tenant_id) < flags.get("triage.rollout_pct", 100)
Três níveis, três velocidades: kill switch global para incidente, blocklist por tenant para o cliente que reclamou, percentual para rollout. O kill switch precisa ser lido a cada requisição — flag em cache de dez minutos não serve durante um incidente.
Testes unitários com fake que lança erro cobrem o código. Eles não cobrem o sistema.
O teste que prova é um exercício, e dura quinze minutos:
503.POST /tickets continuou retornando 201? A latência p95 subiu quanto? O circuito abriu? As métricas de degradação apareceram? Algum log vazou credencial?@pytest.mark.drill
def test_degradacao_sob_indisponibilidade(client, unavailable_provider):
"""Exercício: provider fora do ar não derruba o endpoint principal."""
responses = [client.post("/tickets", json=SAMPLE) for _ in range(20)]
assert all(r.status_code == 201 for r in responses), "endpoint principal caiu"
assert all(r.json()["evaluation"]["degraded"] for r in responses)
assert all(r.json()["evaluation"]["source"] == "heuristic" for r in responses)
assert breaker.state is State.OPEN, "circuito não abriu após falhas repetidas"
# as últimas requisições não devem ter pago timeout
assert max(r.elapsed.total_seconds() for r in responses[-5:]) < 0.1
A última asserção é a mais importante e a mais esquecida: depois que o circuito abre, as requisições precisam falhar rápido. Se elas ainda estão pagando 1 s de timeout, o breaker não está no caminho certo.
connect separado de read.source e degraded.Resiliência em produtos com IA não é uma propriedade do modelo. É uma propriedade do código em volta dele.
A pergunta do começo — o que para de funcionar se o provedor sumir por duas horas — tem uma versão mais dura e mais útil: você consegue desligar a IA agora, em produção, sem derrubar a funcionalidade principal?
Se a resposta exige deploy, o kill switch não existe. Se ela exige pensar, a classificação de criticidade não foi feita. E se a resposta for "não sei", o exercício de quinze minutos em staging vai descobrir por você — de preferência antes que o incidente descubra primeiro.
Os valores de timeout, limiar de circuito e janela de recuperação são exemplos. Derive os seus da latência medida e do orçamento do endpoint.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis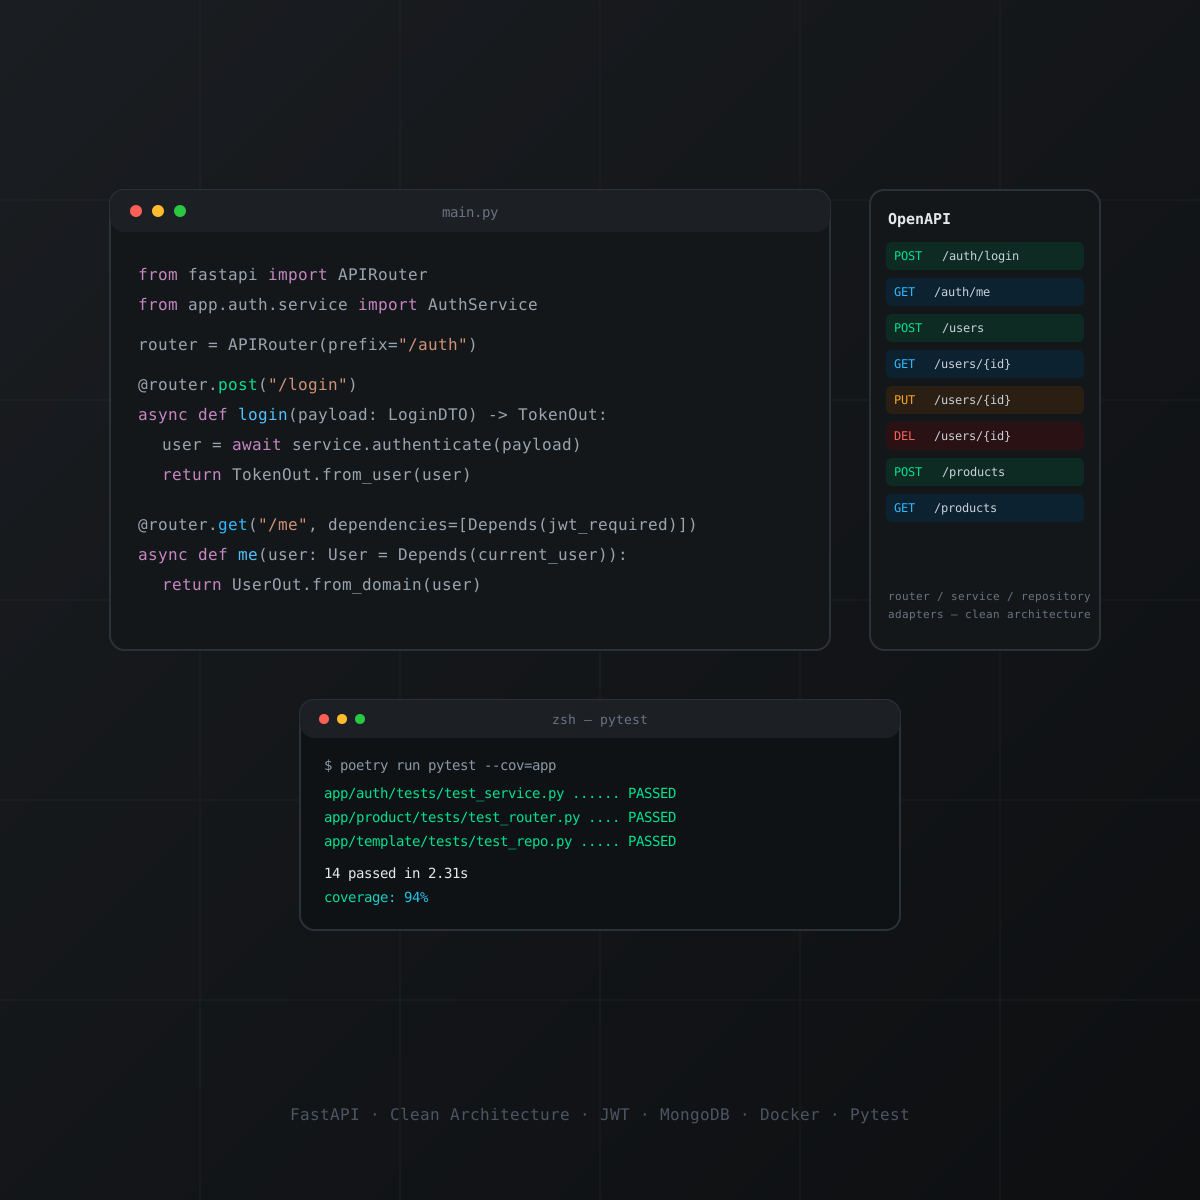
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto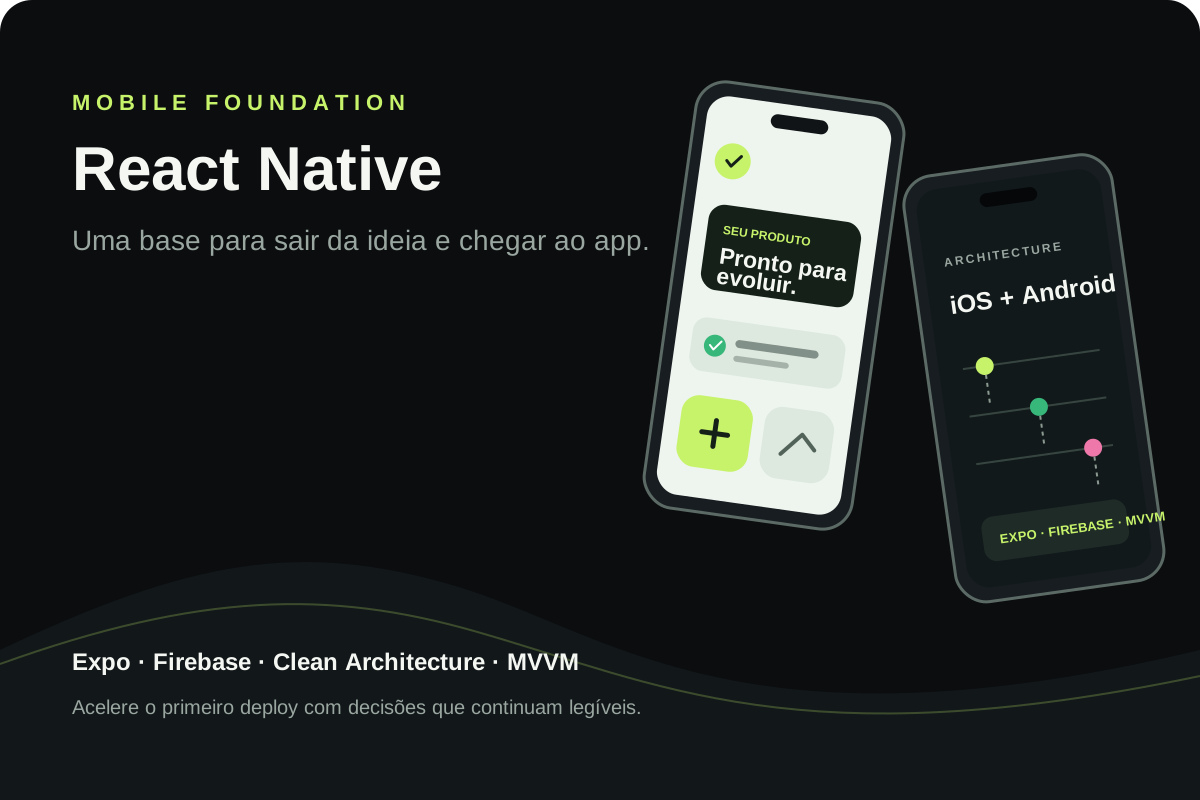
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Com 1,05M de tokens de janela, a tentação é óbvia: joga tudo dentro. A conta de custo, a curva de atenção e a pergunta “de onde veio essa informação?” explicam por que isso raramente funciona.

Em CRUD, reprocessar uma mensagem duas vezes é um incômodo. Com LLM, é uma segunda fatura. Idempotência deixa de ser elegância arquitetural e vira controle de custo.

Seis meses depois, alguém pergunta por que o sistema classificou aquele caso assim. Se a resposta depende de lembrar qual prompt estava no ar, você não tem sistema auditável — tem folclore.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
