
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
10 min de leitura
5 visualizações
Aliases que mudam sob seus pés, prompts sem histórico e o registro de decisão que transforma auditoria em consulta
A pergunta chega sempre da mesma forma, e sempre tarde demais:
"Por que o sistema recusou este caso em março?"
Você abre o banco. Encontra decision: rejected, confidence: 0.71, e um timestamp. Nada sobre qual prompt estava no ar, qual versão do modelo o alias apontava naquele dia, ou qual limiar a policy usava.
Você reconstrói de memória. Alguém lembra que o prompt mudou "por volta de fevereiro". O provedor não expõe mais a versão que estava ativa. A resposta final é uma reconstrução plausível — e uma reconstrução plausível não é uma auditoria.
O problema não é falta de log. É que o log guardou o resultado e não guardou o contexto que o produziu.
model-latest) é conveniência de upgrade e inimigo de reprodutibilidade. Fixe a versão.Toda decisão é uma função de cinco entradas. Mudou qualquer uma, a saída pode mudar.
| Eixo | Muda com que frequência | Como identificar |
|---|---|---|
| entrada | a cada requisição | hash do estado normalizado |
| prompt | semanas | hash do template + versão semântica |
| modelo | fora do seu controle | ID exato, não alias |
| policy | dias a semanas | versão do arquivo de cortes |
| código | a cada deploy | commit SHA |
O eixo que mais surpreende é a policy. Times versionam prompt com cuidado, guardam o modelo, e deixam o limiar de confiança como uma constante que alguém ajusta em um PR sem changelog. Só que mudar confidence >= 0.65 para 0.70 altera o comportamento do sistema tanto quanto trocar de modelo — e não deixa rastro nenhum.
A pior versão disso é o prompt dentro de uma variável de ambiente. Ele muda sem revisão, sem histórico e sem relação com o código que o consome.
Trate prompt como arquivo versionado com identidade derivada do conteúdo:
import hashlib
from dataclasses import dataclass
from pathlib import Path

PROMPTS_DIR = Path(__file__).parent / "prompts"

@dataclass(frozen=True)
class Prompt:
    name: str
    version: str          # semântica, escrita por humano: "triage-v3"
    template: str
    content_hash: str     # derivada, detecta edição sem bump de versão

    @classmethod
    def load(cls, name: str, version: str) -> "Prompt":
        path = PROMPTS_DIR / name / f"{version}.md"
        template = path.read_text()
        return cls(
            name=name,
            version=version,
            template=template,
            content_hash=hashlib.sha256(template.encode()).hexdigest()[:12],
        )

    @property
    def id(self) -> str:
        return f"{self.name}/{self.version}@{self.content_hash}"
O content_hash existe para pegar o caso mais comum de drift silencioso: alguém edita triage-v3.md para "só corrigir uma vírgula" e não sobe a versão. A versão semântica continua v3, o hash muda, e o registro mostra que houve duas coisas diferentes chamadas v3.
Um teste barato transforma isso em barreira:
def test_prompts_congelados():
    """Prompt publicado não muda sem bump de versão."""
    frozen = json.loads((PROMPTS_DIR / "lockfile.json").read_text())
    for prompt_id, expected_hash in frozen.items():
        name, version = prompt_id.split("/")
        actual = Prompt.load(name, version).content_hash
        assert actual == expected_hash, (
            f"{prompt_id} foi editado sem bump de versão "
            f"(esperado {expected_hash}, atual {actual})"
        )
model-latest resolve um problema real: você recebe melhorias sem tocar em código. E cria outro: o comportamento do seu sistema muda sem deploy do seu lado.
A escolha não é ideológica, é por ambiente:
MODEL_BY_ENV = {
    "dev":     "provider/model-latest",    # quer o novo cedo
    "staging": "provider/model-latest",    # detecta mudança antes da produção
    "prod":    "provider/model-1.13.0",    # fixo, promovido conscientemente
}
Staging no alias e produção fixa é o arranjo que dá o melhor dos dois: a mudança aparece primeiro onde não machuca, e a promoção para produção é um PR com eval anexado.
E mesmo com versão fixa, registre a versão efetiva que o provedor reportou:
def evaluate(self, state, questions) -> Evaluation:
    response = self.client.post(..., json={"model": self.model_id, ...})
    body = response.json()

    effective = body.get("model") or response.headers.get("x-model-version")
    if effective and effective != self.model_id:
        logger.bind(requested=self.model_id, effective=effective).warning(
            "provedor serviu versão diferente da solicitada"
        )
    return Evaluation(..., model_effective=effective or self.model_id)
Provedor servindo versão diferente da pedida é raro, e é exatamente o tipo de evento que você quer descobrir por log, não por comportamento estranho três semanas depois.
# policies/triage-v5.yaml
version: triage-v5
effective_from: 2026-09-15
author: anderson
rationale: >
  Corte de urgência baixado de 0.50 para 0.35 após eval de 22/09.
  Custo de FN estimado em 30x o custo de FP pelo time de suporte.
thresholds:
  urgent_probability: 0.35
  min_confidence: 0.65
  department_min_probability: 0.55
actions:
  above_urgent: page_on_call
  below_confidence: human_review
  default: normal_queue
O campo rationale é o que transforma o arquivo em documento de auditoria. Seis meses depois, ele responde "por que 0.35?" sem depender de ninguém lembrar da reunião.
Carregue a policy como objeto versionado e passe a versão adiante:
@dataclass(frozen=True)
class Policy:
    version: str
    urgent_probability: float
    min_confidence: float

    def decide(self, ev: Evaluation) -> tuple[str, str]:
        """Retorna (ação, regra que disparou) — a regra vira parte do registro."""
        if ev.confidence < self.min_confidence:
            return "human_review", "min_confidence"
        if ev.is_urgent >= self.urgent_probability:
            return "page_on_call", "above_urgent"
        return "normal_queue", "default"
Devolver qual regra disparou junto da ação é um detalhe pequeno com efeito grande. Ele responde não só "o que o sistema fez" mas "por qual caminho", que é a pergunta real de quem audita.
Uma tabela, imutável, escrita uma vez.
CREATE TABLE decision_record (
    id                uuid PRIMARY KEY,
    subject_type      text NOT NULL,          -- 'ticket'
    subject_id        uuid NOT NULL,
    decided_at        timestamptz NOT NULL DEFAULT now(),

    -- os cinco eixos
    input_hash        text NOT NULL,
    prompt_id         text NOT NULL,          -- triage/v3@a1b2c3d4e5f6
    model_requested   text NOT NULL,
    model_effective   text NOT NULL,
    policy_version    text NOT NULL,
    code_sha          text NOT NULL,

    -- o que o modelo disse
    raw_answer        jsonb NOT NULL,
    confidence        double precision,

    -- o que o sistema fez
    action            text NOT NULL,
    rule_fired        text NOT NULL,
    degraded          boolean NOT NULL DEFAULT false,
    source            text NOT NULL,          -- model | heuristic | human

    -- o que um humano fez depois
    human_override    text,
    overridden_at     timestamptz,
    override_reason   text
);

CREATE INDEX idx_decision_subject ON decision_record (subject_id, decided_at DESC);
CREATE INDEX idx_decision_prompt  ON decision_record (prompt_id, decided_at);
CREATE INDEX idx_decision_policy  ON decision_record (policy_version, decided_at);
Três decisões de schema que valem explicação.
input_hash em vez do input. Você quer poder verificar se a entrada era a mesma sem guardar PII indefinidamente. O hash prova identidade; o dado original vive na tabela de origem, sujeito à sua política de retenção.
Override humano na mesma linha. Colocar human_override aqui, e não em outra tabela, torna trivial a consulta que mais importa para qualidade: onde o modelo e o humano discordaram.
Imutável. O único UPDATE permitido é o do override. Decisão nova gera linha nova. Sem isso, o histórico é reescrito e a auditoria perde sentido.
def record_decision(conn, ctx: DecisionContext) -> None:
    conn.execute(
        """INSERT INTO decision_record
           (id, subject_type, subject_id, input_hash, prompt_id,
            model_requested, model_effective, policy_version, code_sha,
            raw_answer, confidence, action, rule_fired, degraded, source)
           VALUES (%s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s, %s)""",
        (uuid4(), ctx.subject_type, ctx.subject_id, ctx.input_hash,
         ctx.prompt.id, ctx.model_requested, ctx.model_effective,
         ctx.policy.version, CODE_SHA, Json(ctx.raw), ctx.confidence,
         ctx.action, ctx.rule_fired, ctx.degraded, ctx.source),
    )
A tabela paga o custo do dia em que ela é consultada.
Reprodução literal:
SELECT prompt_id, model_effective, policy_version, code_sha, raw_answer, rule_fired
FROM decision_record
WHERE subject_id = %s ORDER BY decided_at;
Cinco identificadores e a resposta bruta. Você reconstrói o cenário exato, sem depender de memória.
Detectar mudança de distribuição por versão:
SELECT prompt_id, model_effective, policy_version,
       count(*)                          AS decisoes,
       avg((action = 'page_on_call')::int) AS taxa_urgente,
       avg(confidence)                   AS confianca_media
FROM decision_record
WHERE decided_at > now() - interval '60 days'
GROUP BY 1, 2, 3
ORDER BY min(decided_at);
Essa consulta é o painel de regressão mais barato que existe. Quando a taxa muda entre duas linhas, você já sabe qual eixo mudou junto.
Medir a qualidade pelo override humano:
SELECT policy_version,
       count(*) FILTER (WHERE human_override IS NOT NULL)::float / count(*) AS taxa_override,
       mode() WITHIN GROUP (ORDER BY rule_fired)
         FILTER (WHERE human_override IS NOT NULL)                          AS regra_mais_revertida
FROM decision_record
WHERE decided_at > now() - interval '30 days'
GROUP BY 1;
A regra mais revertida é o melhor candidato a ajuste que você vai encontrar — e ela sai de dado, não de opinião.
Quando a versão nova entra, as decisões antigas permanecem com o prompt_id antigo. É isso que permite comparar em vez de substituir.
def promote(new_version: str, canary_pct: int = 10) -> None:
    """Promoção gradual: canário antes de todo o tráfego."""
    flags.set("triage.prompt_version.canary", new_version)
    flags.set("triage.prompt_version.canary_pct", canary_pct)

def prompt_for(subject_id: str) -> Prompt:
    canary = flags.get("triage.prompt_version.canary")
    if canary and hash_bucket(subject_id) < flags.get("triage.prompt_version.canary_pct", 0):
        return Prompt.load("triage", canary)
    return Prompt.load("triage", flags.get("triage.prompt_version", "v3"))
Com 10% no canário por três dias, a consulta de distribuição acima compara as duas versões no mesmo tráfego, no mesmo período — que é a comparação que um eval offline não consegue fazer.
Rollback documentado em wiki tem a mesma eficácia que backup nunca restaurado.
@pytest.mark.drill
def test_rollback_de_prompt(flags, decisions):
    """Exercício: reverter prompt e confirmar que o registro reflete a reversão."""
    flags.set("triage.prompt_version", "v3")
    before = run_traffic(50)
    assert all(d.prompt_id.startswith("triage/v3") for d in before)

    flags.set("triage.prompt_version", "v2")        # rollback
    after = run_traffic(50)

    assert all(d.prompt_id.startswith("triage/v2") for d in after)
    assert decisions.count() == 100, "decisões antigas foram sobrescritas"
A última asserção é a que mais importa: rollback não pode apagar o que já foi decidido. Se o registro tem 50 linhas em vez de 100, alguém implementou UPDATE onde devia ter INSERT.
Exercite os três: prompt, policy e modelo. Cada um por um caminho diferente — flag, arquivo e configuração — e cada um pode estar quebrado sozinho.
rationale.input_hash substitui o input bruto para respeitar retenção.A diferença entre um sistema auditável e um sistema com logs é a diferença entre reproduzir e reconstruir.
Reconstruir é o que você faz quando guardou o resultado: junta memória, git blame e boa vontade, e produz uma narrativa plausível. Reproduzir é o que você faz quando guardou os cinco eixos: uma consulta devolve exatamente o cenário daquele dia.
O custo é uma tabela e alguns campos a mais por decisão. O retorno aparece inteiro de uma vez, no dia em que alguém pergunta por que o sistema decidiu aquilo em março — e você responde em trinta segundos, com evidência, em vez de trinta minutos de arqueologia.
Os exemplos usam PostgreSQL e Python. O conteúdo de
raw_answerpode conter dados do usuário: aplique a mesma política de retenção e minimização que você aplica à tabela de origem.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis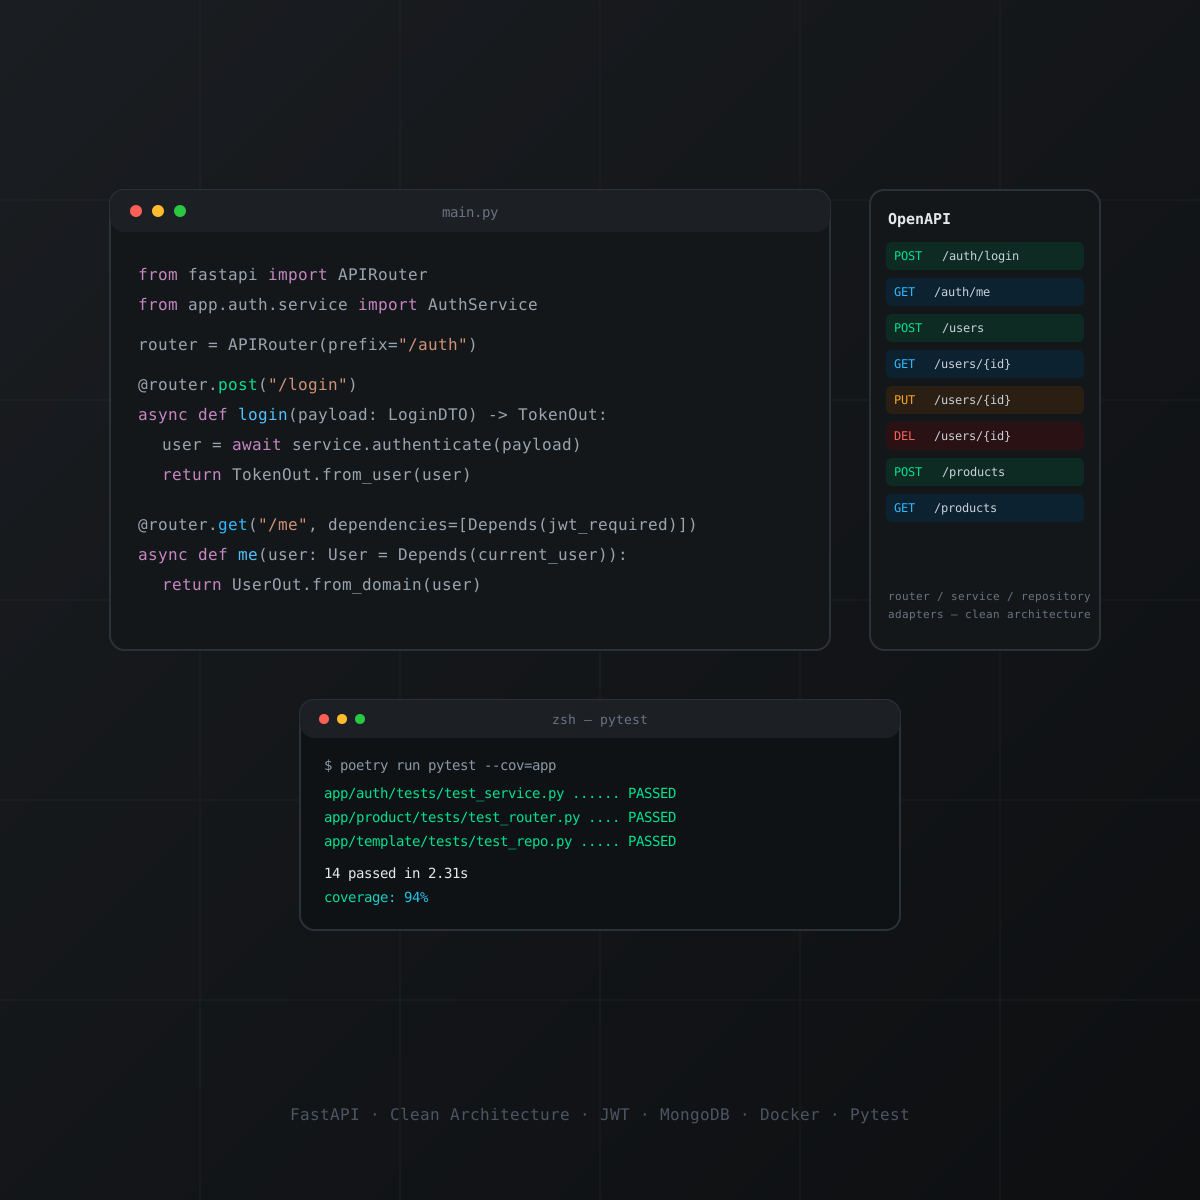
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto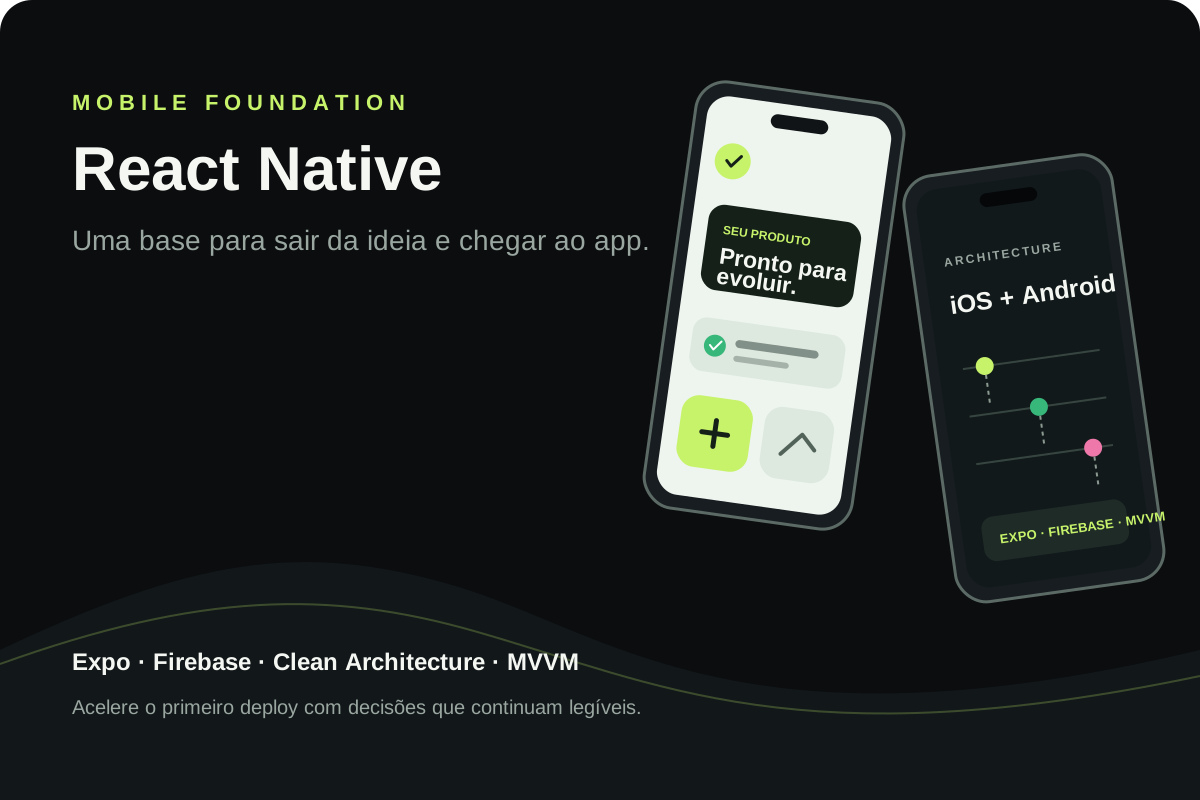
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Preço por token é o número do fornecedor. Custo por tarefa concluída é o seu. Entre os dois existem retries, tarefas que falham, contexto que cresce e um nível de esforço que ninguém varre.

Se você não consegue desligar a IA sem derrubar a funcionalidade principal, o boundary está no lugar errado. Este artigo mostra como descobrir isso antes do incidente.

O fake determinístico devolve exatamente o que você escreveu nele. Por isso ele nunca reprova. O teste que importa é o que confronta sua suposição com a resposta real do provedor.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
