
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
11 min de leitura
2 visualizações
Por que a fatura da sua aplicação de IA não se parece com a tabela de preços do provedor — e como medir o que realmente importa
Uma equipe estimou o custo da funcionalidade nova assim: 3.000 tokens de entrada, 500 de saída, US$ 2 por milhão na entrada e US$ 10 na saída. Dá US$ 0,011 por chamada. Multiplicado por 200 mil chamadas no mês: US$ 2.200.
A fatura veio US$ 7.900.
Ninguém mentiu na tabela de preços. O erro estava em medir a coisa errada. Preço por token é uma propriedade do fornecedor. Custo por tarefa concluída é uma propriedade do seu sistema — e entre os dois existem retries, tarefas que falham depois de consumir tokens, contexto que cresce a cada turno e um parâmetro de esforço que multiplica a conta sem aparecer em lugar nenhum.
Este artigo mostra a matemática, os quatro lugares onde o dinheiro vaza, e um instrumento pequeno o suficiente para você colocar em produção hoje.
O custo real de uma tarefa é:
custo_por_sucesso = (custo_das_tentativas_bem_sucedidas
                   + custo_das_tentativas_falhas
                   + custo_do_trabalho_descartado)
                  / tarefas_concluídas_com_sucesso
Três termos, e a maioria dos cálculos de guardanapo inclui só o primeiro.
Vamos colocar números. Suponha um fluxo de extração com taxa de sucesso de 82%, política de até 2 retries, e custo de US$ 0,011 por tentativa.
def cost_per_success(
    unit_cost: float,
    success_rate: float,
    max_attempts: int = 3,
) -> dict[str, float]:
    """Custo esperado por tarefa concluída, dado retry até max_attempts."""
    p = success_rate
    expected_attempts = 0.0
    prob_eventual_success = 0.0

    for attempt in range(1, max_attempts + 1):
        prob_reaches = (1 - p) ** (attempt - 1)   # chega nesta tentativa
        expected_attempts += prob_reaches
        prob_eventual_success += prob_reaches * p

    total_cost = expected_attempts * unit_cost
    return {
        "tentativas_esperadas": expected_attempts,
        "taxa_sucesso_final": prob_eventual_success,
        "custo_por_tarefa": total_cost,
        "custo_por_sucesso": total_cost / prob_eventual_success,
    }

if __name__ == "__main__":
    for rate in (0.95, 0.82, 0.60, 0.35):
        r = cost_per_success(0.011, rate)
        print(
            f"sucesso={rate:.0%} "
            f"tentativas={r['tentativas_esperadas']:.2f} "
            f"final={r['taxa_sucesso_final']:.1%} "
            f"custo/sucesso=US$ {r['custo_por_sucesso']:.4f}"
        )
Saída:
sucesso=95% tentativas=1.05 final=100.0% custo/sucesso=US$ 0.0116
sucesso=82% tentativas=1.22 final=99.4% custo/sucesso=US$ 0.0135
sucesso=60% tentativas=1.96 final=93.6% custo/sucesso=US$ 0.0230
sucesso=35% tentativas=2.55 final=72.5% custo/sucesso=US$ 0.0386
Observe a assimetria: a taxa de sucesso caiu para pouco mais de um terço e o custo por sucesso triplicou. Qualidade não é só uma métrica de produto. É a maior alavanca de custo que você tem.
E repare no caso de 35%: mesmo com três tentativas, 27,5% das tarefas nunca concluem. Esse trabalho foi pago e jogado fora.
A conta acima supõe que as falhas são independentes. Quando o modelo está sobrecarregado, o schema mudou ou o prompt tem um bug, elas não são: a segunda tentativa falha pelo mesmo motivo da primeira.
Nesse regime, o retry não compra probabilidade de sucesso — compra só fatura.
RETRYABLE = {408, 429, 500, 502, 503, 504}

def should_retry(status: int, attempt: int, body_valid: bool) -> bool:
    # Erro de contrato não melhora com repetição: o prompt ou o schema está errado.
    if not body_valid:
        return False
    # 4xx de cliente (exceto 408/429) são determinísticos.
    if status not in RETRYABLE:
        return False
    return attempt < 3
A regra é simples e frequentemente violada: só repita o que tem chance real de dar certo na repetição. Resposta que viola o contrato é bug de integração, não flutuação. Repetí-la é pagar três vezes pelo mesmo erro.
Some a isso um deadline total. Sem ele, backoff exponencial com jitter pode transformar uma indisponibilidade de trinta segundos em minutos de tokens queimados em requisições que ninguém mais está esperando.
Em um agente multi-turno, cada turno reenvia o histórico. Se o turno n carrega todos os anteriores, o total de tokens de entrada não é linear — é quadrático.
def agent_input_tokens(turns: int, tokens_per_turn: int, system: int) -> int:
    """Total de tokens de ENTRADA cobrados ao longo de uma sessão sem truncamento."""
    total = 0
    for n in range(1, turns + 1):
        total += system + tokens_per_turn * n
    return total

for turns in (5, 10, 20, 40):
    t = agent_input_tokens(turns, tokens_per_turn=800, system=1200)
    print(f"{turns:>2} turnos → {t:>7,} tokens de entrada")
 5 turnos →  18,000 tokens de entrada
10 turnos →  56,000 tokens de entrada
20 turnos → 192,000 tokens de entrada
40 turnos → 704,000 tokens de entrada
Dobrar os turnos quase quadruplica o custo de entrada. Contexto de 1 milhão de tokens não resolve isso — ele apenas adia o momento em que você percebe.
Duas defesas que funcionam:
Cache de entrada. Prefixos estáveis — prompt de sistema, definições de ferramentas, few-shots — costumam ter desconto na faixa de 90% quando reenviados. Coloque tudo que é estável no começo e nunca reordene; qualquer byte alterado no prefixo invalida o cache.
Truncamento com sumário. Mantenha os k turnos recentes na íntegra e substitua o resto por um resumo curto e estruturado. O resumo custa uma chamada, mas corta o crescimento quadrático.
def build_context(history: list[dict], keep: int = 6) -> list[dict]:
    if len(history) <= keep:
        return history
    old, recent = history[:-keep], history[-keep:]
    summary = summarize(old)   # uma chamada barata, modelo pequeno
    return [{"role": "system", "content": f"Resumo anterior: {summary}"}, *recent]
Este é o mais caro e o menos monitorado. Modelos de fronteira em 2026 expõem um parâmetro de esforço de raciocínio — low, medium, high, xhigh, max — e ele altera o custo da mesma tarefa em ordens de grandeza.
Nos dados que a OpenAI publicou junto com o GPT-6 Luna em 22 de setembro de 2026, no benchmark DeepSWE v1.1:
| Esforço | Score | Custo por tarefa |
|---|---|---|
| low | 2,4% | US$ 0,006 |
| medium | 44,5% | US$ 0,052 |
| high | 59,3% | US$ 0,084 |
| xhigh | 61,3% | US$ 0,11 |
| max | 66,6% | US$ 0,22 |
Do mínimo ao máximo, o custo varia 37×. E a curva não é uniforme: de high para max, o custo dobra para ganhar 7 pontos.
Pior: o esforço não é monotônico. No Agents' Last Exam, o mesmo modelo marca 46,8% em medium e 43,6% em high. Você paga mais e recebe menos.
A conclusão operacional é direta. Rodar tudo em max por padrão é a configuração mais cara possível, e nem sempre a melhor. Varra o esforço no seu conjunto de avaliação e escolha o ponto onde a curva satura:
def sweep_effort(tasks, model, levels=("low", "medium", "high", "xhigh", "max")):
    rows = []
    for level in levels:
        results = [run(model, t, effort=level) for t in tasks]
        ok = sum(r.success for r in results)
        cost = sum(r.cost_usd for r in results)
        rows.append({
            "effort": level,
            "success_rate": ok / len(tasks),
            "cost_per_success": cost / ok if ok else float("inf"),
        })
    return rows
O ponto de saturação é onde cost_per_success para de cair. Frequentemente ele não é max.
O vazamento mais barato de consertar é o que não exige medição sofisticada: chamadas que uma regra determinística resolveria.
Antes de cada chamada, pergunte se um if, uma regex, um enum ou uma consulta ao banco responderia. Se sim, o custo marginal correto é zero. Um roteador de duas linhas na frente do modelo costuma cortar uma fração relevante do volume:
def needs_model(ticket: Ticket) -> bool:
    if ticket.source == "billing_webhook":      # origem já determina o time
        return False
    if len(ticket.message) < 20:                # curto demais para julgar
        return False
    return True
Nada disso funciona sem registro. Este decorator é o mínimo viável: ele grava custo, sucesso e metadados por tarefa, em uma linha estruturada que qualquer coletor consome.
import time
import uuid
from contextlib import contextmanager
from dataclasses import dataclass, field

# Preços por milhão de tokens. Snapshot datado, não constante do universo.
PRICING = {
    "gpt-6-luna": {"in": 0.10, "out": 0.50, "cached_in": 0.01},
    "gpt-6-sol":  {"in": 2.00, "out": 10.00, "cached_in": 0.20},
    "opus-5.5":   {"in": 4.00, "out": 20.00, "cached_in": 0.40},
}

@dataclass
class TaskCost:
    task_id: str
    model: str
    effort: str
    attempts: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    success: bool = False
    tags: dict = field(default_factory=dict)

    @property
    def usd(self) -> float:
        p = PRICING[self.model]
        billable_in = self.input_tokens - self.cached_tokens
        return (
            billable_in * p["in"]
            + self.cached_tokens * p["cached_in"]
            + self.output_tokens * p["out"]
        ) / 1_000_000

@contextmanager
def measure(model: str, effort: str = "medium", **tags):
    task = TaskCost(task_id=str(uuid.uuid4()), model=model, effort=effort, tags=tags)
    started = time.monotonic()
    try:
        yield task
    finally:
        logger.bind(
            task_id=task.task_id,
            model=task.model,
            effort=task.effort,
            attempts=task.attempts,
            usd=round(task.usd, 6),
            success=task.success,
            latency_ms=round((time.monotonic() - started) * 1000, 1),
            **task.tags,
        ).info("llm_task")
Uso:
with measure("gpt-6-luna", effort="medium", feature="ticket_triage") as task:
    for attempt in range(1, 4):
        task.attempts = attempt
        response = client.evaluate(state, questions)
        task.input_tokens += response.usage.input_tokens
        task.cached_tokens += response.usage.cached_input_tokens
        task.output_tokens += response.usage.output_tokens
        if validate(response):
            task.success = True
            break
Repare que os tokens são acumulados em todas as tentativas, e success só vira True quando a validação passa. É essa contabilidade que produz o número honesto.
Com esses logs, os três painéis que importam saem de uma consulta:
SELECT
  feature,
  model,
  effort,
  COUNT(*)                                   AS tarefas,
  SUM(usd)                                   AS custo_total,
  AVG(success::int)                          AS taxa_sucesso,
  SUM(usd) / NULLIF(SUM(success::int), 0)    AS custo_por_sucesso,
  AVG(attempts)                              AS tentativas_medias
FROM llm_task
WHERE ts > now() - interval '7 days'
GROUP BY 1, 2, 3
ORDER BY custo_total DESC;
Alerta de fatura chega depois que o dinheiro saiu. Um teto aplicado no caminho da requisição chega antes.
class BudgetExceeded(RuntimeError):
    pass

class Budget:
    """Teto diário por feature, com reserva otimista antes da chamada."""

    def __init__(self, store, daily_limit_usd: float):
        self.store = store
        self.limit = daily_limit_usd

    def reserve(self, feature: str, estimate_usd: float) -> None:
        spent = self.store.incr(f"budget:{feature}:{today()}", estimate_usd)
        if spent > self.limit:
            self.store.incr(f"budget:{feature}:{today()}", -estimate_usd)
            raise BudgetExceeded(f"{feature} excedeu US$ {self.limit:.2f} hoje")

    def settle(self, feature: str, estimate_usd: float, actual_usd: float) -> None:
        self.store.incr(f"budget:{feature}:{today()}", actual_usd - estimate_usd)
Reserve antes, acerte depois. O contador vive em storage compartilhado, não em memória de processo — caso contrário, dez réplicas gastam dez vezes o teto.
E defina o comportamento no estouro por feature, não globalmente. Triagem de ticket pode degradar para fila manual; um fluxo de cobrança talvez precise falhar fechado.
| Métrica | Por que | Alerta quando |
|---|---|---|
| custo por sucesso | decide modelo e esforço | sobe sem mudança de deploy |
| taxa de sucesso | maior alavanca de custo | cai abaixo do baseline do eval |
| tentativas médias | detecta retry improdutivo | passa de ~1,3 |
| % de entrada em cache | mede higiene de prefixo | cai após mudança de prompt |
| tokens de entrada por tarefa | detecta contexto crescendo | cresce com o tempo de sessão |
| custo por feature | prioriza otimização | uma feature domina a fatura |
| tarefas abandonadas | trabalho pago e descartado | qualquer valor não trivial |
success é definido por validação, não por HTTP 200.Preço por token é o número que o fornecedor controla. Custo por sucesso é o número que você controla — e ele responde a decisões de engenharia: qualidade do prompt, política de retry, disciplina de contexto, nível de esforço e a coragem de não chamar o modelo.
A inversão útil é esta: quando o custo por sucesso sobe, o problema quase nunca é o preço da API. É a taxa de sucesso caindo, o contexto crescendo, ou um retry repetindo um erro determinístico.
Meça os três números por tarefa. O resto é consequência.
Os preços e os dados de custo por tarefa por nível de esforço citados são um snapshot de 22 de setembro de 2026, publicados pelos fabricantes. Condições comerciais mudam; trate a tabela
PRICINGcomo configuração datada e confirme antes de decidir.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto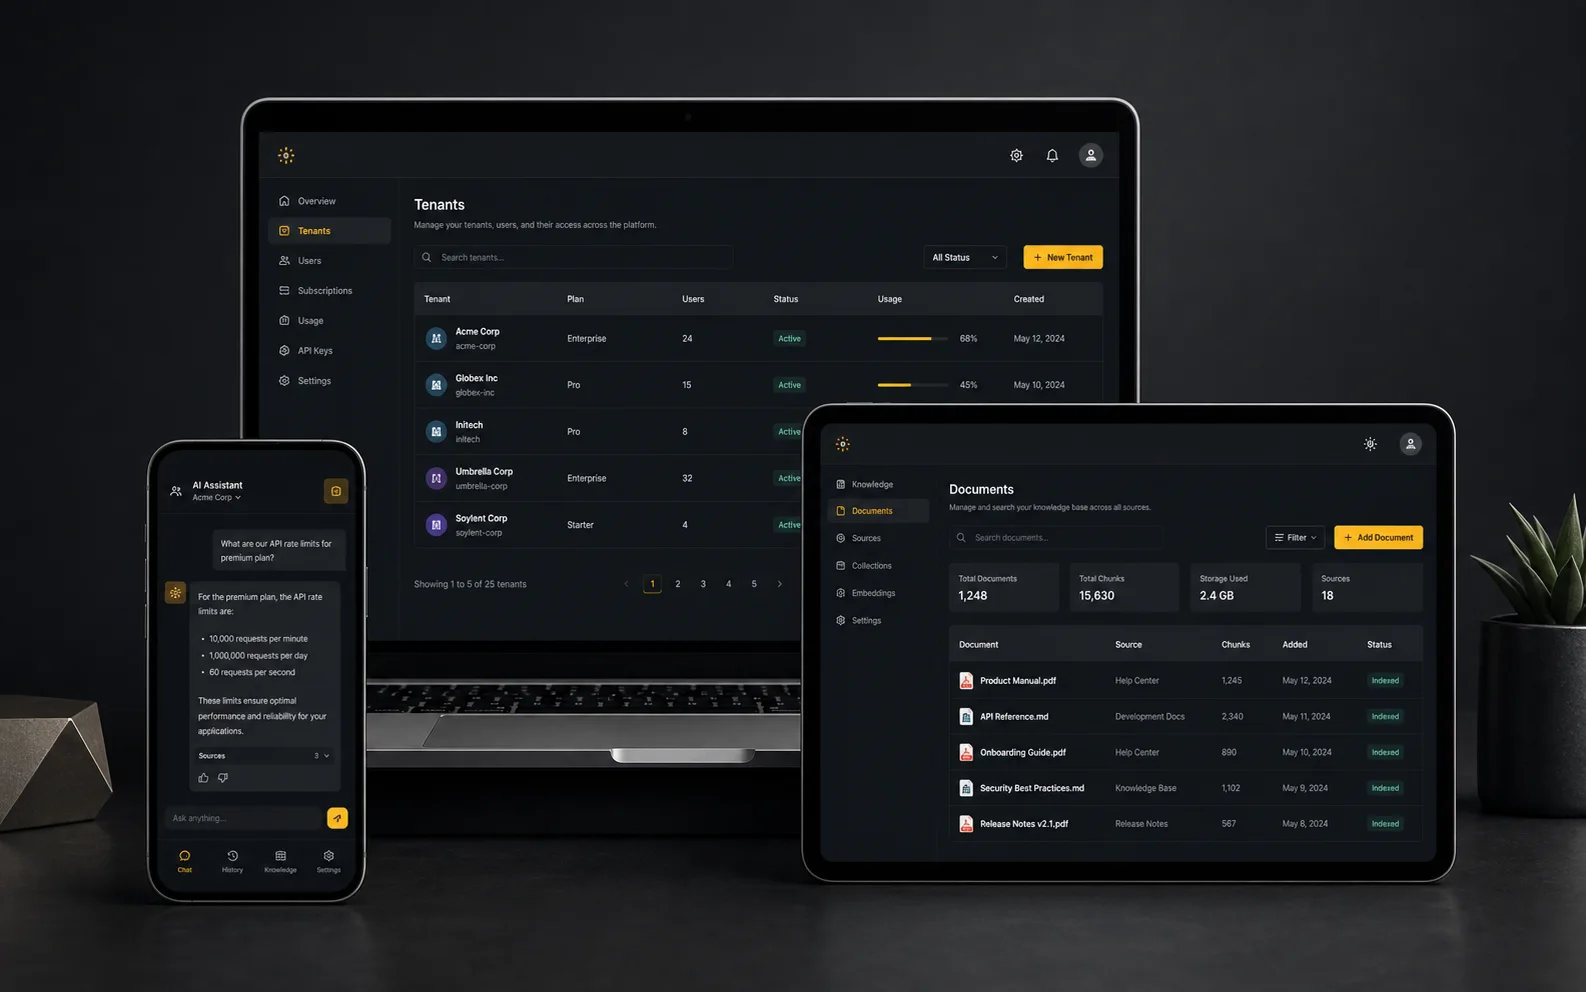
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto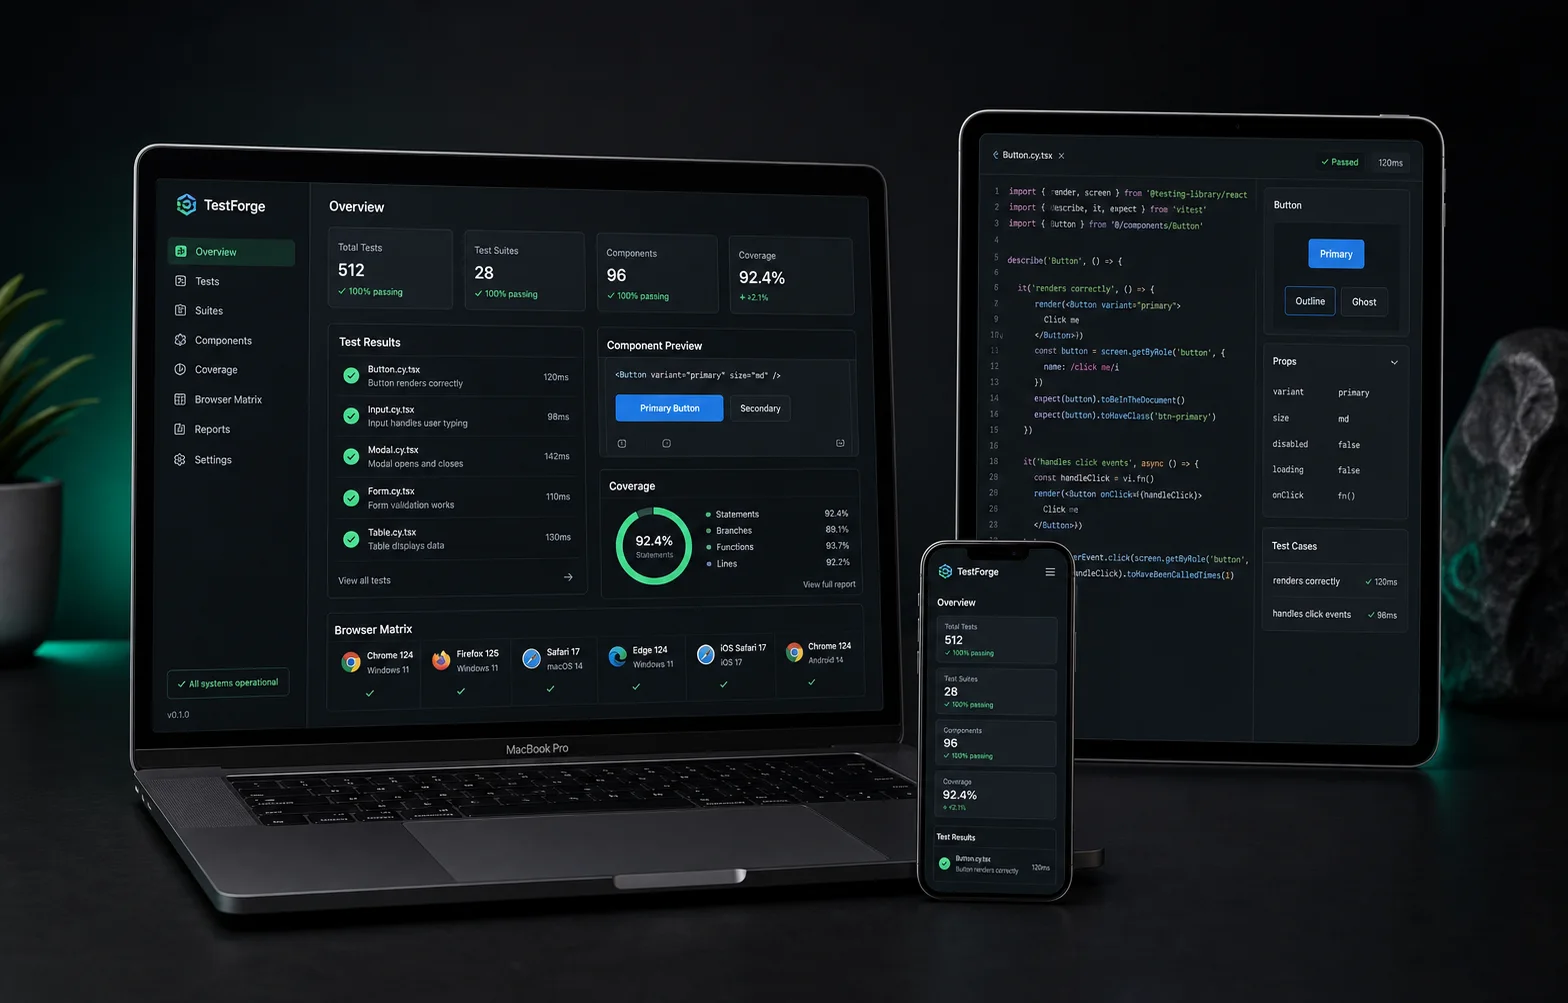
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto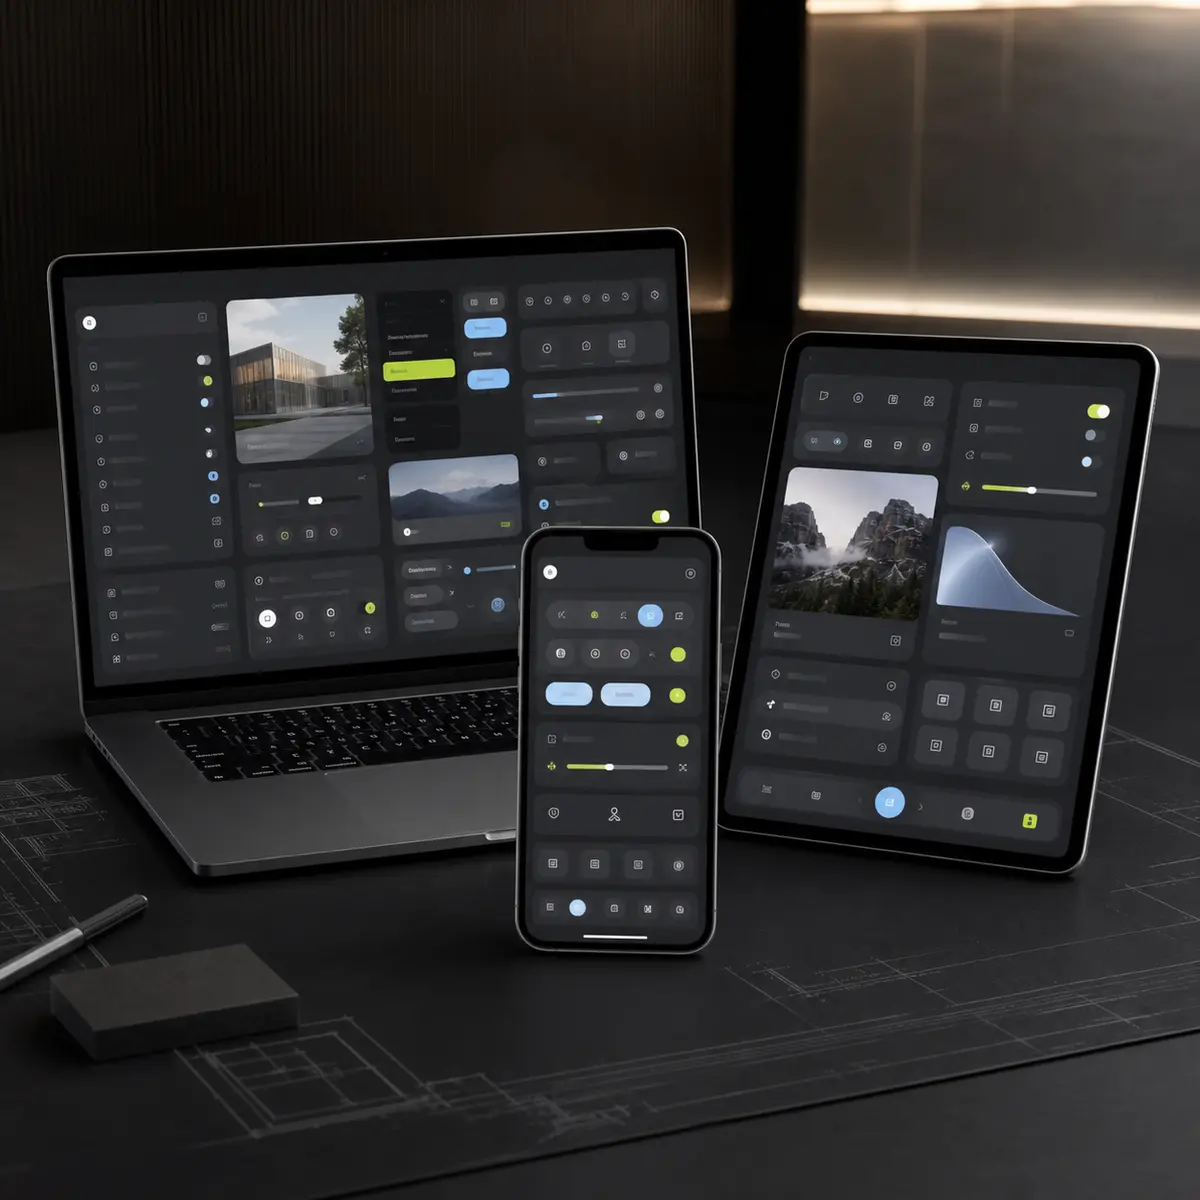
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Seis meses depois, alguém pergunta por que o sistema classificou aquele caso assim. Se a resposta depende de lembrar qual prompt estava no ar, você não tem sistema auditável — tem folclore.

Com 1,05M de tokens de janela, a tentação é óbvia: joga tudo dentro. A conta de custo, a curva de atenção e a pergunta “de onde veio essa informação?” explicam por que isso raramente funciona.

Leaderboards medem o domínio de outra pessoa. O eval que decide o seu produto cabe em 40 casos rotulados e uma tarde de trabalho — desde que você não cometa os quatro erros clássicos.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
