
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
10 min de leitura
3 visualizações
Posição, verbosidade, auto-preferência e o problema de usar o modelo avaliado como avaliador
Rotular mil exemplos à mão custa semanas. Pedir para um modelo avaliar custa alguns dólares e uma tarde. A tentação é óbvia, e o padrão virou onipresente: LLM-as-a-Judge.
Ele funciona. Só não funciona do jeito que a maioria das implementações supõe.
Um juiz LLM não é um medidor neutro. Ele tem preferências sistemáticas — por respostas em certa posição, por respostas mais longas, por respostas que se parecem com as dele. Essas preferências não são ruído aleatório que some com mais amostras. São viés, e viés sobrevive à média.
A boa notícia é que cinco dos seis vieses conhecidos têm correção mecânica, barata e testável. O sexto exige aceitar um limite.
Esta é a etapa pulada com mais frequência, e sem ela nada do resto importa.
Antes de rodar o juiz em mil exemplos, rode em cinquenta rotulados por pessoas e meça a concordância.
from statistics import mean

def judge_agreement(human_labels: list[str], judge_labels: list[str],
                    human_a: list[str], human_b: list[str]) -> dict:
    """Compara o juiz com humanos, e humanos entre si — o teto realista."""
    judge_vs_human = mean(h == j for h, j in zip(human_labels, judge_labels))
    human_vs_human = mean(a == b for a, b in zip(human_a, human_b))
    return {
        "juiz_vs_humano": round(judge_vs_human, 3),
        "humano_vs_humano": round(human_vs_human, 3),
        "razao_do_teto": round(judge_vs_human / human_vs_human, 3),
    }
A leitura correta não é "o juiz acertou 82%". É "o juiz atingiu 82% onde dois humanos atingem 86%" — ou seja, 95% do teto. Esse é um juiz utilizável.
Se a concordância entre humanos for 0,60, o problema não é o juiz. É a rubrica, e nenhum modelo vai consertar uma definição ambígua.
Em comparação par a par, juízes preferem sistematicamente uma das posições. O efeito é robusto e independe do conteúdo.
A correção é mecânica:
def compare_pairwise(judge, question: str, answer_a: str, answer_b: str) -> str:
    """Roda nas duas ordens. Discordância vira empate, não voto."""
    first = judge.compare(question, answer_a, answer_b)    # A na frente
    second = judge.compare(question, answer_b, answer_a)   # B na frente

    if first == "A" and second == "B":
        return "A"          # venceu nas duas ordens
    if first == "B" and second == "A":
        return "B"
    return "tie"            # inconsistente = sem sinal
Repare no return "tie": divergência entre as duas ordens não é um voto fraco, é ausência de sinal. Tratá-la como empate é mais honesto do que desempatar por critério arbitrário.
A taxa de empates virou, de graça, uma métrica de qualidade do juiz. Acima de ~25%, o juiz não está discriminando — está chutando com verniz de análise.
Resposta mais longa recebe nota mais alta, mesmo quando o conteúdo é equivalente. O juiz confunde elaboração com qualidade.
Duas correções, combináveis:
def length_controlled(judge, question: str, answers: list[str]) -> list[float]:
    """Instrução explícita + verificação estatística do resíduo."""
    scores = [judge.score(question, a, LENGTH_NEUTRAL_RUBRIC) for a in answers]
    lengths = [len(a.split()) for a in answers]

    corr = pearson(lengths, scores)
    if abs(corr) > 0.4:
        logger.warning(f"juiz correlacionado com comprimento: r={corr:.2f}")
    return scores
A instrução na rubrica ajuda, mas não elimina:
Avalie apenas a correção e a completude factual.
Uma resposta curta e correta deve receber nota MAIOR que uma resposta
longa que inclui a informação correta cercada de conteúdo irrelevante.
Não premie elaboração, hedging ou repetição.
Meça a correlação sempre. Se r passar de 0,4, seu juiz está medindo tamanho — e você pode melhorar o "desempenho" do seu sistema apenas fazendo o modelo falar mais.
Juízes preferem texto gerado pelo mesmo modelo, ou pela mesma família. É o viés com a consequência mais grave, porque ele inverte comparações.
A correção é uma regra de desenho, não um truque de prompt:
FORBIDDEN_PAIRS = {
    # avaliado -> juízes que não podem julgá-lo
    "gpt-6-sol":  {"gpt-6-sol", "gpt-6-luna", "gpt-6-astra"},
    "opus-5.5":   {"opus-5.5", "opus-5", "fable-5.1"},
}

def pick_judge(candidates_under_test: set[str], pool: list[str]) -> str:
    forbidden = set().union(*(FORBIDDEN_PAIRS.get(m, {m}) for m in candidates_under_test))
    eligible = [j for j in pool if j not in forbidden]
    if not eligible:
        raise ValueError("nenhum juiz elegível: use avaliação humana")
    return eligible[0]
Excluir a família, e não só o modelo exato, importa: modelos treinados de forma parecida compartilham preferências de estilo.
Quando não houver juiz elegível — porque você está comparando os dois melhores modelos disponíveis —, a resposta honesta é a que o código dá: avaliação humana. Não existe truque de prompt que resolva isso.
Peça uma nota de 1 a 5 e observe a distribuição. Ela vai se empilhar em 4 e 5.
Um juiz que dá 4,2 de média para tudo não separa nada. O problema não é o modelo ser otimista — é a rubrica não ter âncoras negativas concretas.
Compare:
# rubrica fraca
1 = ruim, 3 = ok, 5 = excelente

# rubrica com âncoras
5 = factualmente correta, completa, sem informação não solicitada
4 = correta e completa, com alguma informação irrelevante
3 = correta mas incompleta: omite um ponto que a pergunta pedia
2 = parcialmente incorreta: contém ao menos uma afirmação falsa
1 = majoritariamente incorreta, ou não responde à pergunta
A versão com âncoras espalha a distribuição porque cada nota tem um critério verificável — "contém ao menos uma afirmação falsa" é observável; "ruim" não é.
Monitore a distribuição como parte do eval:
def check_distribution(scores: list[float]) -> dict:
    from collections import Counter
    dist = Counter(round(s) for s in scores)
    total = len(scores)
    top_heavy = (dist[4] + dist[5]) / total
    return {
        "distribuicao": {k: round(v / total, 3) for k, v in sorted(dist.items())},
        "concentracao_no_topo": round(top_heavy, 3),
        "suspeito": top_heavy > 0.80,      # juiz não está discriminando
    }
Markdown bem formatado, listas numeradas e negrito aumentam a nota independentemente do conteúdo. O juiz lê apresentação e conclui competência.
A correção depende do que você está avaliando:
import re

def normalize_for_judging(text: str) -> str:
    """Remove pistas de formatação quando o alvo é conteúdo, não apresentação."""
    text = re.sub(r"\*\*(.+?)\*\*", r"\1", text)      # negrito
    text = re.sub(r"^#{1,6}\s+", "", text, flags=re.M)  # cabeçalhos
    text = re.sub(r"^\s*[-*]\s+", "", text, flags=re.M) # marcadores
    text = re.sub(r"\n{2,}", "\n", text)
    return text.strip()
Se o formato faz parte do que você mede — resposta ao usuário final, por exemplo —, não normalize. Avalie em duas dimensões separadas, com rubricas distintas para conteúdo e apresentação, e nunca em uma nota única que mistura as duas.
O mesmo juiz, o mesmo par, a mesma rubrica, duas execuções: respostas diferentes.
Isso não é viés no sentido dos anteriores. É variância, e ela estabelece um teto para o quanto você pode confiar em qualquer número que o juiz produza.
Meça antes de confiar:
def self_consistency(judge, samples, n: int = 3) -> dict:
    """Mesmo juiz, mesma entrada, n execuções."""
    agreements = []
    for s in samples:
        verdicts = [judge.compare(s.question, s.a, s.b) for _ in range(n)]
        most_common = max(set(verdicts), key=verdicts.count)
        agreements.append(verdicts.count(most_common) / n)
    return {
        "consistencia_media": round(mean(agreements), 3),
        "casos_instaveis": sum(1 for a in agreements if a < 0.67),
    }
Temperatura zero reduz a variância, mas não a elimina. A mitigação prática é votação por maioria de três execuções, aceitando o custo de triplicar.
E existe um uso melhor para a inconsistência do que descartá-la: casos instáveis são casos difíceis. Se o juiz não consegue decidir duas vezes igual, aquele exemplo é um excelente candidato a rotulagem humana. Use a instabilidade como fila de triagem, não como ruído.
@dataclass
class JudgeConfig:
    model: str
    temperature: float = 0.0
    rubric: str = ANCHORED_RUBRIC
    swap_positions: bool = True
    normalize_format: bool = True
    votes: int = 3
    max_length_correlation: float = 0.4

def evaluate(config: JudgeConfig, cases: list[Case]) -> EvalReport:
    judge = get_judge(config.model)
    results = []

    for case in cases:
        a = normalize_for_judging(case.answer_a) if config.normalize_format else case.answer_a
        b = normalize_for_judging(case.answer_b) if config.normalize_format else case.answer_b

        votes = [compare_pairwise(judge, case.question, a, b) for _ in range(config.votes)]
        verdict = majority(votes)
        results.append(Result(case=case, verdict=verdict, unanimous=len(set(votes)) == 1))

    report = EvalReport(results)
    report.validate(
        max_tie_rate=0.25,
        max_length_corr=config.max_length_correlation,
        min_human_agreement=0.75,
    )
    return report
O método validate é o que impede o relatório de mentir em silêncio. Se a taxa de empates estourou, se a correlação com comprimento é alta, ou se a concordância com humanos caiu, o eval falha em vez de publicar um número bonito.
Sejamos concretos sobre os limites:
LLM-as-a-Judge é uma ferramenta boa com uma documentação implícita ruim. Ela é adotada como se fosse um medidor, quando na verdade é um avaliador com preferências — e preferências não desaparecem com mais amostras.
Cinco dos seis vieses têm correção mecânica: trocar posições, controlar comprimento, escolher juiz de outra família, ancorar a rubrica, normalizar formato. Nenhuma delas é cara. Todas são mensuráveis.
O sexto — auto-consistência — não tem correção completa, e é por isso que a calibração contra humanos não é opcional. Sem saber a concordância do seu juiz com pessoas do seu domínio, você não tem um eval automático. Você tem um gerador de números com aparência de rigor.
A pergunta que resume tudo: se o seu juiz aprovasse uma resposta ruim, você descobriria? Se a resposta depende de alguém reparar por acaso, o eval ainda não está pronto.
Os vieses descritos são efeitos reportados de forma consistente na literatura de avaliação com LLMs. Os limiares sugeridos — 25% de empates,
rde 0,4, 0,75 de concordância — são pontos de partida operacionais, não constantes: recalibre com o seu domínio e a sua rubrica.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis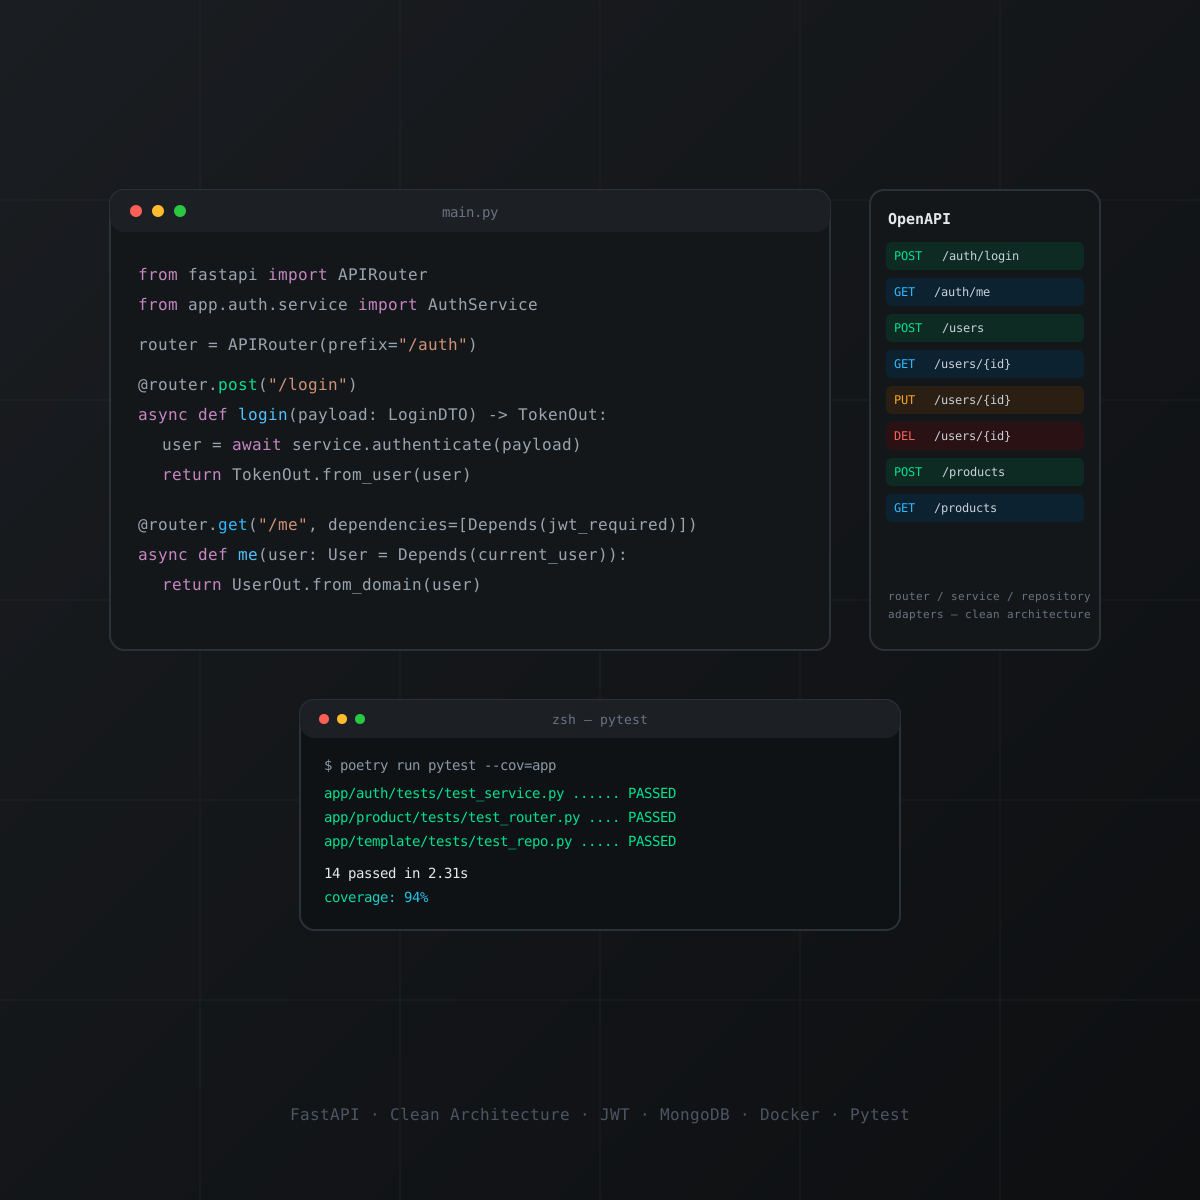
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto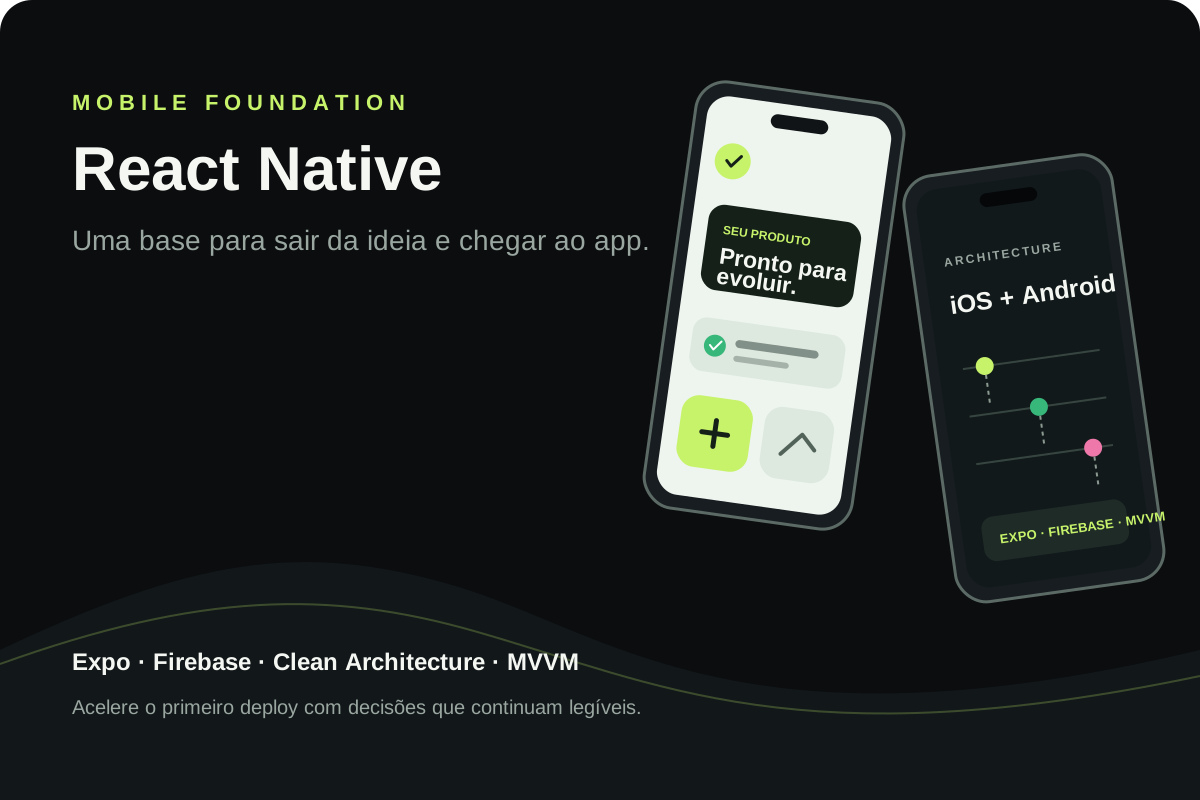
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Leaderboards medem o domínio de outra pessoa. O eval que decide o seu produto cabe em 40 casos rotulados e uma tarde de trabalho — desde que você não cometa os quatro erros clássicos.

Preço por token é o número do fornecedor. Custo por tarefa concluída é o seu. Entre os dois existem retries, tarefas que falham, contexto que cresce e um nível de esforço que ninguém varre.

OpenAI cortou preço pela metade, Anthropic lançou no mesmo dia e os modelos chineses lideram o ranking aberto. O problema: os três grupos quase não compartilham benchmarks. Este artigo lê os números que existem e nomeia os que faltam.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
