
Anderson LimaSoftware Engineer & Architect
22 de setembro de 2026
19 min de leitura
Três lançamentos em um dia, seis benchmarks que quase não se cruzam e a pergunta que ninguém responde direito: quais modelos chineses estão acompanhando?
Em 22 de setembro de 2026, a OpenAI lançou dois modelos e a Anthropic lançou um. No mesmo dia. GPT-6 Sol e GPT-6 Luna chegaram a US$ 2/US$ 10 e US$ 0,10/US$ 0,50 por milhão de tokens — metade do preço de entrada da geração anterior. Claude Opus 5.5 chegou a US$ 4/US$ 20.
A leitura fácil é a do placar: quem ganhou. A leitura útil é outra, e ela começa com um incômodo. Se você tentar colocar esses modelos na mesma tabela dos melhores modelos chineses — Kimi K3, Qwen3.8 Max, DeepSeek V4 Pro, GLM-5.3 —, descobre que quase não existe benchmark em comum. Os laboratórios americanos migraram para AutomationBench, FrontierCode 1.1, DeepSWE e Terminal-Bench 4.0. Os laboratórios chineses continuam publicando SWE-bench Verified e Terminal-Bench 2.x.
Não dá para somar essas colunas. E é exatamente por isso que a pergunta “quem está na frente” vem sendo respondida com mais confiança do que os dados permitem.
Este artigo faz três coisas: lê os números que a OpenAI e a Anthropic publicaram, mostra onde eles contradizem a manchete, e mapeia honestamente onde os modelos chineses estão — inclusive admitindo o que não é possível comparar.
high do que em medium no Agents' Last Exam. Teste, não presuma.Três semanas antes de Sol e Luna, a OpenAI lançou o topo de linha da geração: GPT-6 Astra, no início de setembro de 2026, a US$ 10/US$ 50. Sol e Luna trazem os ganhos do Astra para baixo na tabela de preço — é assim que a própria OpenAI descreve o lançamento.
| Especificação | GPT-6 Sol | GPT-6 Luna | GPT-6 Astra |
|---|---|---|---|
| Lançamento | 22/09/2026 | 22/09/2026 | início de setembro/2026 |
| Preço (entrada/saída por 1M) | US$ 2 / US$ 10 | US$ 0,10 / US$ 0,50 | US$ 10 / US$ 50 |
| Entrada em cache | US$ 0,20 | US$ 0,01 | — |
| Contexto | 1.050.000 tokens | 1.050.000 tokens | 1.050.000 tokens |
| Saída máxima | 128.000 tokens | 128.000 tokens | 128.000 tokens |
| Corte de conhecimento | 20/04/2026 | 18/05/2026 | 30/04/2026 |
| Modalidades | texto e imagem na entrada, texto na saída | idem | idem |
| Níveis de esforço | none, low, medium, high, xhigh, max | none, low, medium (padrão), high, xhigh, max | low, medium, high, xhigh, max |
Do lado da Anthropic, a linha relevante para comparação:
| Modelo | Lançamento | Preço (entrada/saída por 1M) |
|---|---|---|
| Claude Opus 5 | 24/07/2026 | US$ 5 / US$ 25 |
| Claude Opus 5.5 | 22/09/2026 | US$ 4 / US$ 20 |
| Claude Fable 5.1 | — | US$ 10 / US$ 50 |
O corte de preço é real e é grande. A entrada do Sol custa exatamente metade da entrada do GPT-5.6 Sol. A saída do Luna caiu 58%, de US$ 1,20 para US$ 0,50. Entrada em cache leva 90% de desconto nos dois.
Guarde uma ressalva comercial: o “metade do preço” é medido contra a tarifa promocional do GPT-5.6 Sol, garantida apenas até 21 de novembro de 2026. Preço de API é condição comercial, não propriedade física do modelo.
Aqui está o detalhe que torna a comparação possível. A OpenAI não incluiu o Opus 5.5 em seus gráficos — ele saiu no mesmo dia. Mas os números que a Anthropic publicou para Opus 5, Fable 5.1, GPT-6 Astra e GPT-5.6 Sol são idênticos aos valores de esforço máximo nos gráficos da OpenAI. Os dois laboratórios parecem estar reportando as mesmas execuções. Isso torna legítimo colocar Opus 5.5 ao lado de Sol nessas duas colunas.
| Benchmark | GPT-6 Sol | GPT-6 Luna | Opus 5.5 | Fable 5.1 | GPT-6 Astra | Opus 5 |
|---|---|---|---|---|---|---|
| AutomationBench | 33,2% | 20,7% | 40,0% | 31,4% | 41,4% | 26,9% |
| FrontierCode 1.1 | 49,3% | 42,4% | 54,4% | 50,3% | 53,3% | 48,0% |
| Terminal-Bench 4.0 | — | — | 66,4% | 55,8% | 57,9% | 52,3% |
| Preço (1M entrada/saída) | $2 / $10 | $0,10 / $0,50 | $4 / $20 | $10 / $50 | $10 / $50 | $5 / $25 |
Três leituras:
Opus 5.5 é o modelo mais forte dessas colunas, e por margem não trivial: cerca de 7 pontos à frente do Sol em AutomationBench, 5 em FrontierCode. No Terminal-Bench 4.0 ele marca 66,4%, acima até do Astra (57,9%), que custa 2,5 vezes mais. A OpenAI não reportou Terminal-Bench 4.0 para Sol ou Luna.
O Astra ainda lidera AutomationBench com 41,4%. O topo de linha continua sendo o topo de linha; Sol não foi feito para destroná-lo.
Sol supera o Opus 5 anterior em ambos os benchmarks, cobrando menos. Contra o Opus 5.5, perde. A geração que ele bate é a que a Anthropic acabou de substituir — no mesmo dia.
O pitch do lançamento é eficiência de custo. Vale ler isso de forma literal, porque em parte dos benchmarks a capacidade não subiu — desceu.
| Benchmark | GPT-6 Sol (melhor) | GPT-5.6 Sol (melhor) | Claude Opus 5 (melhor) |
|---|---|---|---|
| DeepSWE v1.1 | 68,8% | 72,7% | 73,7% |
| OSWorld 2.0 | 64,4% | 66,2% | 70,2% |
Em DeepSWE e OSWorld 2.0, o melhor resultado do GPT-6 Sol fica abaixo do melhor resultado do modelo que ele substitui, e abaixo do Opus 5. O que melhorou foi o custo por tarefa, não o teto.
Isso não é um escândalo. É uma escolha de produto declarada: trazer os ganhos do Astra para pontos de preço mais baixos. Mas muda completamente a pergunta que você deve fazer. Se o seu gargalo é qualidade no limite, esse lançamento não é para você. Se é custo por tarefa em volume, ele pode ser o lançamento mais relevante do trimestre.
Onde Sol de fato avança: no Agents' Last Exam, em esforço máximo, ele marca 56,4% — acima do melhor do Opus 5, 55,9%. E em AutomationBench, em xhigh, marca 33,2% a US$ 0,27 por tarefa, contra 26,9% do Opus 5 em max cobrando 11,1 vezes mais.
O resultado mais instrutivo do dia não é o do modelo caro. É a tabela completa do Luna por nível de esforço — o tipo de dado que raramente aparece em post de lançamento.
| Benchmark | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| AutomationBench 1.0.6 | 1,2% ($0,006) | 9,4% ($0,016) | 14,5% ($0,021) | 12,6% ($0,025) | 20,7% ($0,037) |
| Agents' Last Exam V1 | 36,3% ($0,025) | 46,8% ($0,11) | 43,6% ($0,11) | 47,9% ($0,11) | 50,9% ($0,15) |
| FrontierCode 1.1 Main | 25,7% ($0,021) | 35,5% ($0,053) | 37,3% ($0,067) | 37,1% ($0,073) | 42,4% ($0,11) |
| DeepSWE v1.1 | 2,4% ($0,006) | 44,5% ($0,052) | 59,3% ($0,084) | 61,3% ($0,11) | 66,6% ($0,22) |
| OSWorld 2.0 (offline) | 8,3% ($0,030) | 31,5% ($0,062) | 41,4% ($0,12) | 46,7% ($0,16) | 52,7% ($0,27) |
| Taxa de erro factual (menor é melhor) | 27,7% | 17,5% | 12,5% | 10,2% | 7,6% |
Duas coisas saltam.
O mesmo modelo varia de 2,4% a 66,6% no mesmo benchmark. Em low, Luna é inútil para trabalho agêntico: 2,4% em DeepSWE, 1,2% em AutomationBench, 8,3% em OSWorld. A faixa útil começa em medium. Qualquer manchete sobre “o modelo X marca Y%” sem dizer o nível de esforço está omitindo a variável mais determinante do resultado.
Esforço não é monotônico. Luna pontua pior em high do que em medium no Agents' Last Exam (43,6% contra 46,8%), e pior em xhigh do que em high no AutomationBench (12,6% contra 14,5%). Sol tem o mesmo comportamento: seu pico em AutomationBench e em factualidade é xhigh, não max.
A consequência prática é chata e direta: max por padrão é desperdício de dinheiro com risco de resultado pior. O nível de esforço é um hiperparâmetro do seu workload. Ele precisa ser varrido como qualquer outro.
E, em custo por tarefa, Luna faz algo notável: 50,9% no Agents' Last Exam por US$ 0,15, onde o antecessor precisava de US$ 2,57 para marcar 50,4%. Mesmo resultado, 17 vezes mais barato.
Um número do Opus 5 não tem par na tabela de ninguém: ARC-AGI-3.
Verificado pela ARC Prize Foundation em esforço alto, o Opus 5 marcou 30,16% — cerca de quatro vezes o segundo colocado (GPT-5.6 Sol, 7,78%) e cerca de vinte vezes o Opus 4.8 (1,52%). Ele completou cinco ambientes do Public Demo que nenhum modelo havia resolvido antes. O resultado em esforço máximo não estava disponível no lançamento.
ARC-AGI mede outra coisa: generalização para tarefas fora da distribuição de treino, não competência em engenharia de software. Uma vantagem de 4× ali não se traduz em vantagem em código, e o inverso também vale. É um lembrete de que “melhor modelo” só significa algo depois que você diz melhor em quê.
Vale também registrar a ressalva que a própria Anthropic publicou: o System Card do Opus 5 afirma que ele não é mais capaz no geral que o Fable 5, que mantém a designação oficial de modelo mais capaz e é o recomendado para trabalho agêntico autônomo de vários dias.
Aqui a resposta honesta precisa de duas partes: o que os rankings mostram, e o que nenhum ranking consegue mostrar.
No recorte de laboratórios chineses do BenchAlign v5, verificado em 22 de setembro de 2026:
| # | Modelo | Laboratório | Pesos | Contexto | Score |
|---|---|---|---|---|---|
| 1 | Kimi K3 | Moonshot AI | pendente | 1,05M | 74,0 |
| 2 | Qwen3.8 Max | Alibaba | abertos | 1M | 73,1 |
| 3 | Qwen3.7 Max | Alibaba | proprietário | 1M | 67,1 |
| 4 | GLM-5.3 | Z.ai | abertos | 1M | 67,0 |
| 5 | GLM-5.3-Flash | Z.ai | abertos | 1M | 66,8 |
| 6 | GLM-5.2 | Z.ai | abertos | 1M | 66,8 |
| 7 | Kimi K2.7 Code | Moonshot AI | abertos | 256K | 66,2 |
| 8 | Kimi K2.6 | Moonshot AI | abertos | 256K | 66,1 |
O agregador publica intervalos de 90% junto com os scores, e eles se sobrepõem bastante — a diferença entre o primeiro e o quarto colocado não é decisiva no sentido estatístico. Trate a ordem como orientação, não como pódio.
Nos benchmarks que esses laboratórios de fato reportam:
| Modelo | SWE-bench Verified | SWE-bench Pro | Terminal-Bench | GPQA Diamond |
|---|---|---|---|---|
| DeepSeek V4 Pro Max | 80,6 | 55,4 | 67,9 (TB 2.0) | 90,1 |
| Kimi K2.6 | 80,2 | 58,6 | 66,7 (TB 2.0) | 90,5 |
| GLM-5.2 | — | 62,1 | 81,0 (TB 2.1) | 91,2 |
| Qwen3-Coder-Next | 70,6 (com SWE-Agent) | 42,7–44,3 | 36,2 | — |
Todos esses são números reportados pelos fabricantes, frequentemente com harness próprio e esforço máximo. O caveat que acompanha os resultados agênticos da DeepSeek, por exemplo, é explícito: harness próprio, esforço máximo.
E as licenças importam tanto quanto os scores:
| Modelo | Parâmetros | Licença | Classe de deploy |
|---|---|---|---|
| DeepSeek V4 Pro | 1,6T total / 49B ativos | MIT | cluster |
| DeepSeek V4 Flash | 284B / 13B ativos | MIT | nó multi-GPU |
| Kimi K3 | 2,8T | licença própria Kimi K3 | rack |
| Kimi K2.6 | 1T / 32B ativos | MIT modificada | serving especializado |
| GLM-5.2 | 744B / 40B ativos | MIT | cluster |
| Qwen3-Coder-Next | 80B / 3B ativos | Apache 2.0 | workstation |
| Qwen3.8-27B | 27B | Apache 2.0 | laptop de alta memória |
Esse é o ponto que raramente entra na conversa sobre placar: você pode baixar a maioria desses modelos. Um checkpoint MIT que resolve ~80% do SWE-bench Verified roda na sua infraestrutura, sem chamada externa, sem preço por token, sem alias que muda sob seus pés. O eixo em que a China está claramente na frente não é acurácia — é disponibilidade.
Sobre preço: a DeepSeek passou a cobrar tarifas de pico e fora de pico em 16 de agosto de 2026, dobrando o valor por sete horas por dia. Mesmo assim, a camada Flash começa em torno de US$ 0,22 por milhão de tokens de entrada fora de pico. Compare com o Luna a US$ 0,10 e você verá que a vantagem de preço bruto encolheu bastante nesta semana.
Agora a parte incômoda. Os modelos chineses não aparecem em AutomationBench, FrontierCode 1.1, DeepSWE, Terminal-Bench 4.0 ou Agents' Last Exam — os benchmarks sobre os quais este artigo inteiro discutiu nas seções anteriores.
Os americanos, por sua vez, praticamente pararam de reportar SWE-bench Verified nos lançamentos mais recentes.
Isso cria uma zona cega real:
Há ainda uma assimetria de incentivo digna de nota: benchmarks novos são propostos pelos laboratórios que se saem bem neles. Migrar de SWE-bench Verified — onde vários modelos abertos chineses passaram de 80% — para DeepSWE e FrontierCode não é, por si só, má-fé; benchmarks saturam e precisam ser substituídos. Mas o efeito colateral é que o placar reinicia num tabuleiro onde só um lado já jogou.
Se benchmarks não resolvem, olhe para revealed preference: o que as empresas ocidentais realmente colocam em produção.
O Composer 2, modelo próprio do Cursor lançado em março de 2026, foi construído sobre o Kimi 2.5, checkpoint de pesos abertos da Moonshot AI. O detalhe não estava no post de lançamento; apareceu quando usuários no X identificaram a base. O vice-presidente Lee Robinson confirmou depois, afirmando que “apenas ~1/4 do compute gasto no modelo final veio da base”. O cofundador Aman Sanger reconheceu que “foi uma falha não mencionar a base Kimi no nosso blog desde o início”.
Uma empresa avaliada em dezenas de bilhões de dólares, vendendo para dois terços da Fortune 500, escolheu um checkpoint chinês aberto como base do seu modelo de código. Isso diz mais sobre o estado da paridade do que qualquer tabela deste artigo.
A pergunta “qual o melhor modelo” quase nunca tem resposta útil. Estas têm:
| Se a restrição dura é… | Comece por | Porque |
|---|---|---|
| custo por tarefa em volume alto | GPT-6 Luna em medium/high | 66,6% em DeepSWE por US$ 0,22 no topo; faixa útil começa em medium |
| teto de qualidade em código agêntico | Claude Opus 5.5 | lidera AutomationBench, FrontierCode e Terminal-Bench 4.0 entre os comparáveis |
| generalização fora da distribuição | Claude Opus 5 | 30,16% em ARC-AGI-3, ~4× o segundo colocado |
| trabalho autônomo de vários dias | Claude Fable 5.1 | designação oficial da Anthropic para esse caso |
| dado não pode sair da sua rede | Qwen3.8 Max, DeepSeek V4, GLM-5.2 | pesos abertos, licenças MIT/Apache |
| uma GPU só, ou um laptop | Qwen3-Coder-Next, Qwen3.8-27B | 80B/3B ativos e 27B, Apache 2.0 |
| reprodutibilidade auditável | qualquer checkpoint com revisão fixada | alias hospedado muda sem aviso |
| contexto muito longo | qualquer um da lista | 1M+ virou commodity nesta geração |
E uma regra que vale mais que a tabela: varra o nível de esforço antes de trocar de modelo. A diferença entre medium e max no mesmo modelo é frequentemente maior — em qualidade e em custo — do que a diferença entre dois modelos concorrentes no mesmo nível.
Nenhum número deste artigo foi medido por mim. Nenhum deles foi medido no seu domínio. O eval que decide é o seu, e ele é mais barato de montar do que parece.
max.O item 6 merece ênfase. Nesta semana, três modelos novos mudaram a fronteira de preço e qualidade. Vai acontecer de novo no mês que vem. Uma arquitetura em que trocar de modelo custa um dia de trabalho vale mais do que acertar a escolha de hoje.
Se as oito respostas não estiverem no post de lançamento, você está lendo marketing com aparência de ciência. Isso não invalida o modelo — só invalida a manchete.
Setembro de 2026 entregou três coisas ao mesmo tempo: um corte de preço agressivo da OpenAI, uma resposta de qualidade da Anthropic no mesmo dia, e um ecossistema chinês de pesos abertos que já resolve ~80% do SWE-bench Verified e pode ser baixado.
A leitura de placar diz que Opus 5.5 lidera os benchmarks comparáveis, que Astra lidera AutomationBench, e que Luna redefiniu o custo por tarefa. Tudo isso é verdade e pouco acionável.
A leitura útil é outra. Primeiro: o nível de esforço move mais o resultado do que a escolha de modelo, e quase ninguém reporta isso. Segundo: capacidade e custo deixaram de subir juntos — dois dos seis benchmarks de destaque do GPT-6 Sol estão abaixo do modelo anterior, de propósito. Terceiro: a pergunta sobre os modelos chineses não tem resposta limpa porque os conjuntos de benchmark pararam de se intersectar, e o sinal mais forte disponível não é um score — é o Cursor construindo seu modelo de código sobre um checkpoint da Moonshot.
O que sobra como conselho é modesto e resistente: monte um eval pequeno no seu domínio, varra o esforço, meça custo por tarefa concluída, e construa a integração de modo que trocar o modelo custe um dia. A fronteira vai se mover de novo antes de você terminar de ler o próximo post de lançamento.
Todos os scores, preços e datas foram verificados em 22 de setembro de 2026 e vêm de posts de lançamento dos fabricantes ou de agregadores terceiros, conforme indicado em cada tabela. Eu não executei nenhum benchmark. Preço de API é condição comercial mutável; confirme nas páginas oficiais antes de decidir.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis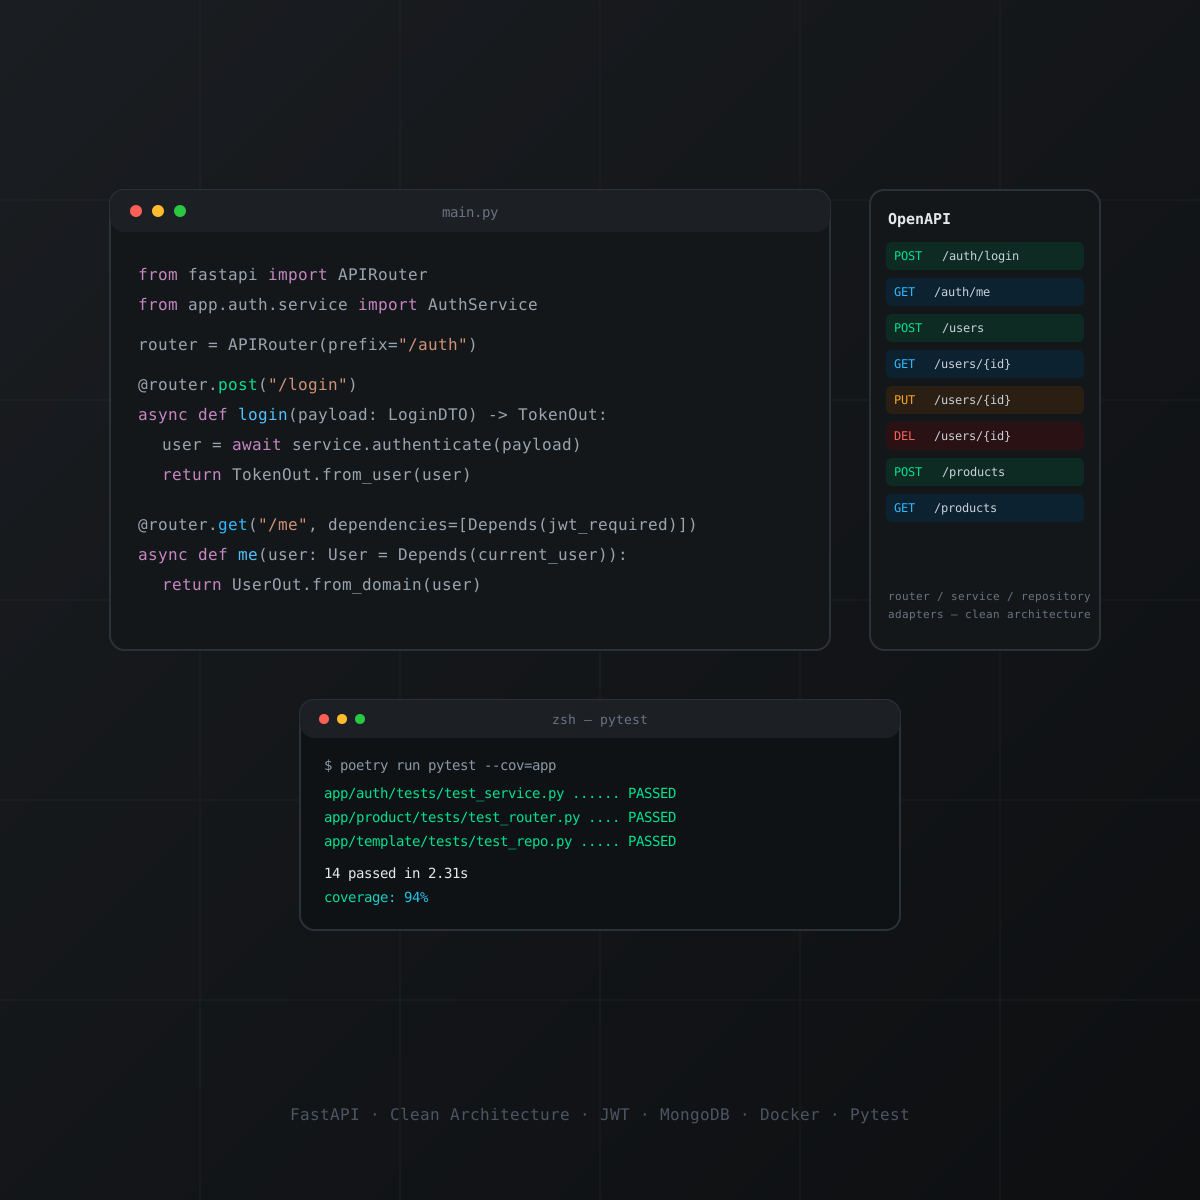
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto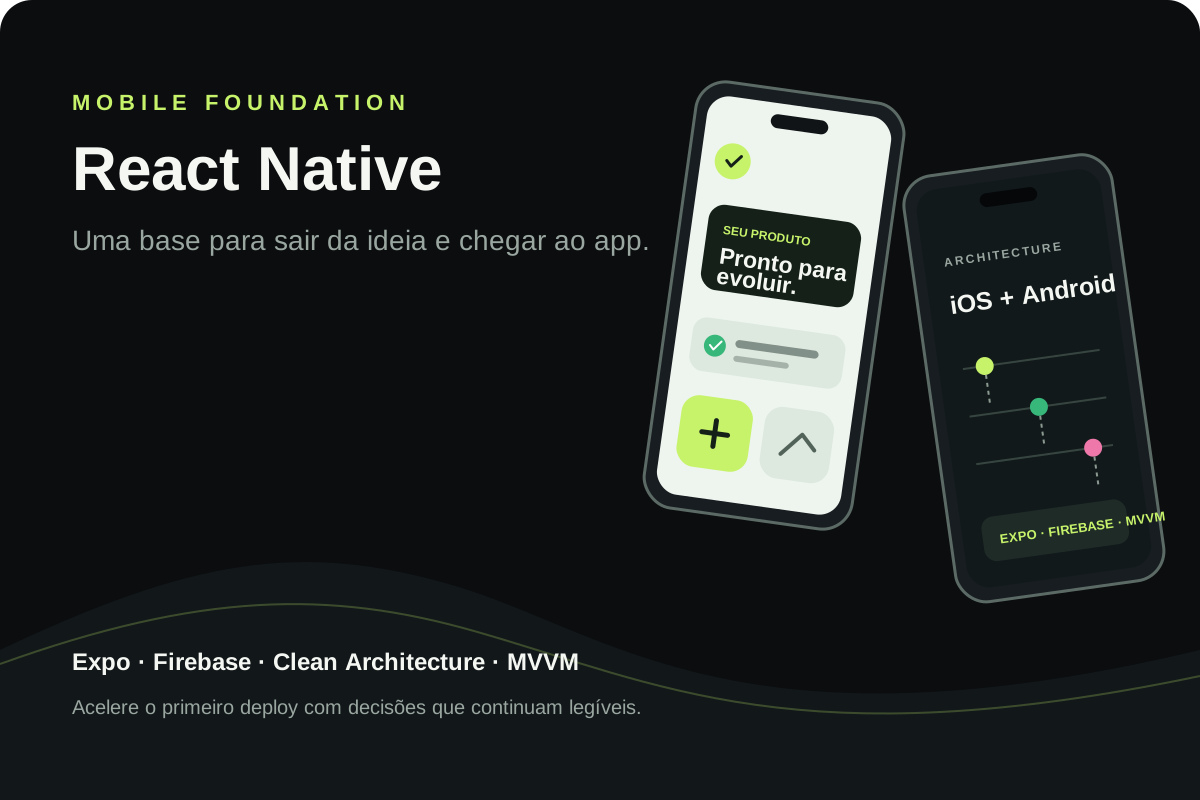
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Antes de comparar benchmark, responda uma pergunta de aritmética: o modelo cabe? A conta de VRAM elimina metade das opções em cinco minutos — e a de ponto de equilíbrio elimina a outra metade.

Preço por token é o número do fornecedor. Custo por tarefa concluída é o seu. Entre os dois existem retries, tarefas que falham, contexto que cresce e um nível de esforço que ninguém varre.

Leaderboards medem o domínio de outra pessoa. O eval que decide o seu produto cabe em 40 casos rotulados e uma tarde de trabalho — desde que você não cometa os quatro erros clássicos.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
