
Anderson LimaSoftware Engineer & Architect
1 de outubro de 2026
20 min de leitura
0 visualizações
DeskPilot v0.3 fecha uma lacuna real do capítulo 05, sobrevive a um provedor fora do ar, tropeça de verdade num restore de backup — e ainda assim não prova product-market fit

Na sexta falha consecutiva do provedor de IA, DeskPilot bloqueia novas sugestões. A fila de tickets ainda responde. O agente, porém, não vê aviso de degradação na interface: esse único detalhe impede o convite a usuários reais. É o resultado de uma falha injetada em teste, não de um incidente de produção.
O backend registra a quinta falha consecutiva de sugestão para esse tenant. Na sexta tentativa, antes de chamar o adaptador outra vez, recusa o pedido — 429, tenant_suspended. O limiar é uma política didática, testada com falha injetada; não há incidente real nem tráfego de produção por trás dele.
O teste automatizado roda contra o DeskPilot v0.3: seis chamadas simuladas de provedor indisponível, cinco registradas como fallback no backend, a sexta bloqueada antes de chamar o adaptador. O backend sabe que degradou; a interface ainda não comunica isso ao agente. Essa distância entre controle técnico e experiência de uso orienta a decisão de lançamento deste capítulo.
Em resumo: o drill local verificou fallback, transação de revisão com auditoria e outbox, isolamento de tenant e recuperação de ticket e auditoria após restore. A reserva de custo não garante teto faturado, a interface não mostra a sugestão e o piloto não foi executado. A decisão atual é não convidar usuários reais até fechar esses gates e os de privacidade e consentimento.
Ownership de produto inclui operar falhas, limitar despesas e proteger confiança antes de aumentar usuários ou automação. Um MVP que passa em todo teste de unidade e nunca foi testado contra um provedor fora do ar, um tenant gastando sem teto ou um restore de backup real não está pronto para convidar um usuário real — está pronto para outro sprint de engenharia.
A decisão que este capítulo prepara o leitor para tomar não é técnica: é o que precisa ser verdadeiro para convidar usuários reais, e em que ponto exato interromper o piloto se algo sair errado. Um gate técnico que fica todo verde não responde essa pergunta sozinho — ele é necessário, nunca suficiente.
Antes de qualquer arquitetura nova, o menor exemplo que sustenta o capítulo inteiro: dois números que hoje moram no mesmo request handler, mas nunca deveriam morar no mesmo score.
// Duas perguntas, dois denominadores diferentes. Nunca uma média das duas.
const ticketFlowSli = ticketFlowCounter.good / ticketFlowCounter.total;
const suggestionQualitySli = suggestionQualityCounter.good / suggestionQualityCounter.total;
No cenário sintético acima, ticketFlowSli poderia permanecer perto de 1,0 porque o caminho de tickets não chama o provedor de IA; suggestionQualitySli cairia. Um painel que combinasse ambos em "sistema 50% degradado" esconderia qual caminho falhou e qual runbook seguir. Os contadores deste exemplo vivem na memória de um processo, sem janela durável nem prova de disponibilidade em produção.
O motivo de dois números em vez de um não é estético. É que cada um responde a uma ação diferente. Se ticket_flow cair, o problema é o banco, a rede, ou um bug de regressão no comando — acionar on-call de infraestrutura. Se suggestion_quality cair, o problema é o provedor de IA ou o orçamento do tenant — acionar verificação de status do provedor e revisão de kill switch, e nunca tocar no fluxo de ticket, que não tem nada a ver com isso. Confundir os dois sinais é confundir dois runbooks — e um runbook errado, seguido com disciplina, ainda produz o resultado errado.
A mesma lógica se aplica ao custo: gastar dinheiro com IA e gastar dinheiro com suporte humano são categorias diferentes, cada uma com seu próprio teto, porque cada uma estoura por um motivo diferente e se resolve com uma ação diferente.
DeskPilot é o produto fictício, real e executável desta série: triagem assistida de suporte B2B. Usuário é o agente de suporte; comprador é o gestor do tenant; afetado é o cliente final. Nada aqui roda em produção — é um exemplo didático completo, com Postgres real e testes reais, para ensinar a decisão de produto, não para vender um SaaS.
O capítulo 05 deixou DeskPilot v0.2: sugestão de categoria e resumo, gerada em modo sombra, validada campo a campo, revisável só por um ator humano autenticado, 55 testes automatizados. O capítulo 06 mediu, sem tocar uma linha desse código, que 81,8% de aceitação de sugestão escondia só 63,6% de fechamento limpo — e junto com essa métrica, deixou uma lacuna registrada, não escondida: o tipo de evento suggestion.reviewed, definido na tracking plan de analytics, nunca era de fato emitido pelo código. A rota POST /tickets/:id/suggestions/review persistia a decisão do agente e não gerava nenhum evento para ela.
Esse é o primeiro código que este capítulo toca. A rota de revisão agora chama uma operação única do repositório. No Postgres, ela trava a sugestão, valida a decisão humana e grava novo estado, evento de auditoria fechado (suggestion.accept, suggestion.edit, suggestion.reject ou suggestion.expire) e suggestion.reviewed no outbox na mesma transação. A entrega posterior de analytics tem retry limitado.
// src/api/server.ts, rota POST /tickets/:id/suggestions/review
const result = await repo.applySuggestionReview({
  tenantId: actor.tenantId,
  ticketId: parts[1],
  actor,
  action,
  nowIso: new Date().toISOString(),
});
// PgRepository: lock + estado + auditoria + outbox em uma transação.
Nenhuma regra de domínio mudou. O que v0.3 adiciona vive em src/ops/: entrega com retry limitado (outbox.ts), orçamento e kill switch por tenant (budget.ts), e matemática de SLI/error budget (sli.ts) — três módulos novos, migrações aditivas (0003_reliability.sql e 0004_budget_reservations.sql) e duas rotas HTTP novas (GET /ops/slo, POST /ops/budget-reset). A revisão agora chama applySuggestionReview: em PgRepository, SELECT ... FOR UPDATE trava a sugestão e revisão, auditoria e enqueue são gravados na mesma transação. Retry da mesma ação pelo mesmo ator retorna replayed: true, sem novo evento. Os testes de fluxo incluem rollback por falha injetada e replay; a implementação em memória preserva o contrato para testes offline.
Três decisões que valem a pena tornar explícitas, porque cada uma tinha uma alternativa razoável que foi rejeitada por um motivo concreto:
O kill switch não se recupera sozinho. Um circuit breaker clássico fecha automaticamente quando o provedor volta a responder — é o desenho descrito em degradacao-graciosa-produtos-ia, um capítulo anterior desta mesma publicação. Este capítulo escolhe o oposto: só um ator autenticado com papel manager ou system pode resetar o switch, nunca um timer.
// src/ops/budget.ts
export async function resetTenantKillSwitch(
  repo: DeskPilotRepository,
  actor: User,
  tenantId: string,
  nowIso: string
): Promise<{ ok: true } | { ok: false; error: string }> {
  if (actor.tenantId !== tenantId) return { ok: false, error: "cross_tenant_denied" };
  if (actor.role !== "manager" && actor.role !== "system") {
    return { ok: false, error: "actor_not_permitted:reset_requires_manager_or_system" };
  }
  // ...reseta suspended, consecutiveFallbacks, registra resetAtIso/resetByActorId
}
Um reset automático reabriria silenciosamente um provedor que talvez ainda esteja quebrado — o mesmo ponto cego que a Falha 1 deste capítulo explora do lado da entrega de eventos. A troca é deliberada: menos automação, mais responsabilidade nomeada. Um humano decide reabrir a torneira, e essa decisão fica registrada (resetByActorId, resetAtIso).
Reserva diária e kill switch são guardas separadas. A reserva de até US$ 0,05 por tentativa acontece sob lock da linha (tenant, dia) em PgRepository; o valor reservado soma ao gasto registrado antes da admissão. No teste com 20 chamadas concorrentes e teto sintético de US$ 0,20, quatro entram. O kill switch continua respondendo a falhas consecutivas do provedor, não a gasto. Essa reserva limita admissões, mas não prova teto rígido do valor faturado: o provedor pode informar custo maior que US$ 0,05 (a fixture high_cost informa US$ 0,42), e uma execução interrompida pode deixar reserva sem reconciliação. Para um piloto com teto contratual, limitar custo no provedor e reconciliar tentativas interrompidas são pendências.
O outbox tem um tipo de evento, um drenador por tenant, nunca FOR UPDATE SKIP LOCKED. O padrão outbox mais completo, com múltiplas réplicas disputando claim atômico sobre a mesma fila, está descrito em idempotencia-outbox-pipelines-ia, outro capítulo desta publicação — e foi lido por inteiro para escrever este. DeskPilot v0.3 simplifica deliberadamente: scripts/drain-outbox.ts roda um processo por vez, um tenant de cada vez, então o problema de concorrência entre réplicas simplesmente não existe aqui. Copiar a solução completa seria complexidade sem o problema que a justifica — exatamente o oposto do que esta série defende desde o capítulo 05.
Sintoma: a entrega de um evento (suggestion.reviewed, para o outbox) que falha continua sendo tentada para sempre — sem teto, sem backoff, sem sinal visível de que está em curso.
Causa: naiveRedeliverForever, mantido no código só para o teste comparar, nunca chamado em nenhum caminho real:
export async function naiveRedeliverForever(repo, sink, event, nowIso) {
  let attempts = 0;
  for (;;) {
    attempts += 1;
    try {
      await sink.deliver(event);
      await repo.markOutboxDelivered(event.id, nowIso);
      return { attempts };
    } catch {
      // sem teto, sem backoff, sem dead-letter: tenta de novo imediatamente
    }
  }
}
O detalhe mais perigoso não é o laço sem fim — é que, enquanto ele roda, o contador attempts da linha na tabela nunca é atualizado, porque essa função nem chama o método que faria isso. Um engenheiro de plantão olhando o painel veria uma linha parada em pending, attempts=0, sem nenhum sinal de que uma tempestade de retry está em curso contra ela.
Resposta: drainOutboxOnce, com uma política explícita de tentativas, backoff exponencial com teto, e dead_letter obrigatório quando o teto é atingido:
export async function drainOutboxOnce(repo, sink, opts) {
  const policy = opts.policy ?? DEFAULT_RETRY_POLICY; // maxAttempts: 5
  const due = await repo.listDueOutboxEvents(opts.tenantId, opts.nowIso, opts.limit);
  for (const event of due) {
    try {
      await sink.deliver(event);
      await repo.markOutboxDelivered(event.id, opts.nowIso);
    } catch (err) {
      const attemptsAfter = event.attempts + 1;
      const terminal = attemptsAfter >= policy.maxAttempts;
      await repo.markOutboxFailed(event.id, {
        nowIso: opts.nowIso,
        nextAttemptAtIso: terminal ? null : backoffFrom(opts.nowIso, attemptsAfter, policy),
        terminal,
        error: (err as Error).message,
      });
    }
  }
}
O teste que prova a diferença roda os dois lado a lado contra o mesmo sink, configurado para falhar dez vezes seguidas: a versão corrigida, com maxAttempts: 3, desiste na terceira tentativa e marca a linha como dead_letter — nunca mais tentada automaticamente. A versão ingênua insiste até a décima primeira chamada, quando o sink finalmente aceita, sem nunca ter dado sinal de dead-letter no caminho. Onze tentativas contra três é a diferença entre um evento perdido de forma visível e recuperável, e um evento perdido de forma invisível.
Sintoma: um painel de operação mostra suggestion_quality_sli: 0,40 e para por aí. Quem está de plantão precisa já saber de memória se esse número é bom ou ruim, e o que fazer a respeito.
Causa: naiveDashboard, também mantido só para comparação:
export function naiveDashboard(input) {
  return {
    ticket_flow_sli: ratio(input.ticketFlow),
    suggestion_quality_sli: ratio(input.suggestionQuality),
  };
}
Dois números, zero contexto.
Resposta: buildDashboard, usado de fato por GET /ops/slo. Cada métrica carrega um status (ok/warning/breach/no_data), a fração de budget de erro já consumida, e — sempre que o status não é ok — uma ação literal, nunca um número solto:
{
  "name": "suggestion_quality",
  "status": "breach",
  "sli": 0.2,
  "burnedFraction": 2.67,
  "action": "runbook:suggestion-quality-breach -- confirm ticket_flow is unaffected, then trip kill switch for the affected tenant(s)..."
}
O texto de action não é decorativo: é o mesmo texto documentado em examples/runbook.md, na tabela de alertas acionáveis, então o painel e o runbook nunca podem divergir silenciosamente um do outro — um é gerado a partir da mesma lógica que valida o outro.
Sintoma: um backup existe — o comando rodou, o arquivo .dump tem bytes — mas ninguém nunca testou se ele volta a ser um sistema funcionando de verdade.
Esta é a única das quatro falhas que este capítulo não precisou simular: ela aconteceu de verdade, nesta sessão, durante o próprio drill que deveria só confirmar que o backup funcionava.
docker exec series-ai-pe07-pg pg_dump -U postgres -d deskpilot -Fc -f /tmp/deskpilot.dump
docker stop series-ai-pe07-pg   # simula perda
docker run -d --rm --name series-ai-pe07-pg-restore -e POSTGRES_PASSWORD=*** \
  -e POSTGRES_DB=deskpilot -p 0:5432 postgres:17.6
docker exec series-ai-pe07-pg-restore pg_restore -U postgres -d deskpilot \
  --no-owner --role=postgres /tmp/deskpilot.dump
pg_restore: error: could not execute query: ERROR:  role "deskpilot_app" does not exist
Command was: GRANT USAGE ON SCHEMA public TO deskpilot_app;
pg_restore: warning: errors ignored on restore: 9
Causa real: pg_dump de um único banco não inclui papéis — eles vivem no nível do cluster, não do banco. Um cluster de restore vazio simplesmente não tem deskpilot_app, o papel de aplicação que src/db/pg-repository.ts usa para conectar. Os dados das tabelas restauraram corretamente — confirmado por uma consulta direta como superusuário —, mas a aplicação não teria conseguido autenticar até esse ponto ser corrigido. Um restore que "parece ter funcionado" porque os dados estão visíveis para o superusuário é exatamente o tipo de falso positivo que só aparece testando de verdade, nunca supondo.
Resposta e verificação: reexecutar node src/db/migrate.ts contra o alvo de restore recria o papel (o bloco do $$ if not exists ... end $$ de migrations/0001_init.sql, inalterado desde o capítulo 03, já era idempotente o suficiente para isso) e reaplica os GRANTs. Depois disso, uma leitura através do papel real da aplicação — não do superusuário — confirmou o ticket recuperado (triaged, version: 1) com seu evento de auditoria intacto (ticket.triage). O runbook agora documenta restore como duas etapas, não uma: pg_restore sempre seguido de migrate.ts antes de apontar a aplicação para o alvo.
Sintoma: uma demonstração interna — dados sintéticos, um ticket bem escolhido, um agente treinado especificamente para a demo — vira "piloto validado" ou "clientes adoram" na boca de alguém, e uma decisão de negócio real (investir, prometer a um cliente, escalar) é tomada em cima disso.
Causa: confundir "o sistema roda sem erro" com "o mercado quer isso" — são perguntas diferentes, respondidas por evidências diferentes. Nenhum teste automatizado, por mais verde que fique, responde a segunda. É o mesmo erro, em escala maior, que o capítulo 06 já nomeou para uma métrica: tratar aceite de sugestão como sucesso de negócio.
Resposta: a matriz de examples/release-checklist.md separa as duas perguntas em linhas diferentes — 13 gates técnicos, e uma linha 15 rotulada "não aplicável a este gate técnico" para PMF, especificamente para que ninguém confunda uma coisa com a outra. examples/pilot-protocol.md abre com "Status: piloto não executado" em negrito, na primeira linha, antes de qualquer outro conteúdo. Nenhum artefato deste pacote contém um número de cliente, receita ou satisfação real — porque nenhum existe.
76 testes automatizados offline (domínio, API, IA e módulos de ops/) e 16 testes contra Postgres real, incluindo RLS pelo papel de aplicação, rollback/replay da revisão e admissões concorrentes. Nos cenários testados, o kill switch bloqueia antes da chamada ao adaptador; o drenador limita tentativas; o painel separa os dois SLIs; as consultas testadas isolam tenants; revisão, auditoria e outbox compartilham transação no Postgres; o restore local recupera ticket e auditoria através da aplicação. Isso não prova teto rígido de custo faturado nem reconciliação de jobs interrompidos.
Isso não prova: que algum tenant real vai usar o sistema dessa forma; que o teto de US$ 5,00/dia ou o limiar de 5 falhas consecutivas são os números certos para um cliente de verdade (são cenários didáticos, nunca uma negociação real); que a UI de revisão humana está pronta — a leitura direta de src/web/app.js nesta sessão confirmou que ela não renderiza nenhum campo de sugestão, nem categoria nem suggestionDetail, mais grave do que o README do capítulo 05 registrava ("só mostra a categoria"). Essa é a lacuna que bloqueia de verdade o gate 8 da matriz go/no-go — não um exercício retórico de "sempre existe algo a melhorar", mas um bloqueador nomeado, com responsável e critério de fechamento.
E, mais uma vez, nenhum desses números mede se uma sugestão de IA de fato ajuda um tenant real — essa é a pergunta que o capítulo 06 já tinha isolado, e que só um piloto real, ainda não executado, pode responder.
Custo: produto, IA e suporte exigem orçamentos separados. checkAndReserveRequest reserva capacidade atomicamente por tenant/dia antes da chamada ao adaptador. Vinte requisições concorrentes com teto sintético de US$ 0,20 admitem quatro reservas de US$ 0,05. O gasto real é registrado após a chamada e pode superar a reserva; uma execução interrompida pode deixá-la pendente. Cobrança real está fora do exemplo. Limite faturado no provedor, alertas e reconciliação de reservas são gates pendentes.
Segurança: o threat model nomeia seis vetores e controles parciais — entrada não confiável (validação de schema), vazamento entre tenants (RLS testada nas duas tabelas novas), injeção (citação de evidência conferida contra o texto autorizado), alteração de dados (versão otimista, chave de comando), permissões (papel ai não autoriza comandos; reset exige manager/system) e abuso de consumo (teto diário, limite de requisições, kill switch). Esses testes não certificam segurança. examples/privacy-data-map.md registra as lacunas: redação automática de logs, exportação/exclusão self-service e revisão legal/contratual.
Reversibilidade: todo container Docker desta sessão foi descartável (--rm, sem volume nomeado) e removido ao final. Toda migração é aditiva — nenhuma tabela, coluna ou política do capítulo 03 ao 05 foi alterada. O kill switch reverte com um ator nomeado, nunca sozinho. O que não reverte fácil é uma decisão de negócio tomada sobre um número inflado — motivo pelo qual a Falha 4 existe nesta lista ao lado de três falhas de infraestrutura.
suggestion.reviewed — lacuna real do capítulo 05/06 — fechado: dois eventos emitidos na rota de revisão, um síncrono (auditoria), um enfileirado (analytics).ticket_flow e suggestion_quality medidos separadamente, nunca combinados em um score.ok carrega uma ação, ligada ao runbook.Básico. Rode node --test test/ops/outbox.test.ts em examples/deskpilot/. Mude DEFAULT_RETRY_POLICY.maxAttempts de 5 para 1 em src/ops/outbox.ts e explique, sem rodar nada, o que muda no teste "dead-letters after the policy's attempt ceiling". Critério de aceite: prever corretamente que a linha vai para dead_letter na primeira falha, sem nenhuma tentativa de retry. Solução comentada: com maxAttempts: 1, attemptsAfter = event.attempts + 1 = 1, e terminal = (1 >= 1) = true já na primeira falha — o teto de uma tentativa remove o retry por completo, o que é válido para um evento onde qualquer atraso é inaceitável, mas geralmente forte demais para um sink que só está lento, não quebrado.
Intermediário. Reproduza o teste de 20 reservas concorrentes para um tenant com teto sintético de US$ 0,20 e reserva de US$ 0,05. Critério de aceite: quatro admissões, 16 recusas e reserved_usd = 0.20 no Postgres. Solução comentada: mutateTenantBudget cria a linha (tenant, dia) se necessário, faz SELECT ... FOR UPDATE e decide/atualiza na mesma transação. Depois injete uma resposta de provedor com custo US$ 0,42: a reserva atômica continua correta, mas o valor faturado extrapola US$ 0,05. Explique por que o teste de admissão não prova teto de cobrança.
Avançado. O drill de backup/restore desta sessão usou pg_dump -Fc de um único banco e descobriu que papéis não vêm junto. Projete (sem implementar) uma segunda estratégia de backup que também capture papéis e suas senhas com segurança, considerando que DESKPILOT_APP_PASSWORD nunca deve aparecer em texto puro num arquivo de dump. Liste pelo menos dois trade-offs da sua estratégia contra o procedimento de duas etapas (pg_restore + migrate.ts) já documentado em examples/runbook.md. Critério de aceite: a estratégia proposta precisa nomear explicitamente como a senha do papel de aplicação seria protegida (nunca "apenas incluir no dump"), e comparar pelo menos complexidade operacional e superfície de exposição de segredo contra a solução mais simples já testada nesta sessão. Solução comentada: uma opção real é pg_dumpall --roles-only para um arquivo separado, com a senha do papel gerada de novo (não extraída do dump) a cada restore — mais simples de proteger, mas exige regenerar e redistribuir a senha da aplicação toda vez, uma operação manual a mais que o procedimento atual (migrate.ts idempotente) já resolve de graça, porque ele recria o papel com a senha do ambiente de destino, nunca com uma senha herdada do backup.
ticket_flow, 70% para suggestion_quality neste pacote) — meta, nunca resultado medido nem SLA negociado.(1 - SLO) × total de eventos — quantos eventos ruins são tolerados antes de a meta ser violada.Este capítulo entrega ao capítulo 08 DeskPilot v0.3 com 76 testes offline e 16 testes de fluxo PostgreSQL registrados; revisão, auditoria e suggestion.reviewed atômicos no Postgres; reserva concorrente de admissão testada; matriz no-go com UI de sugestões bloqueada e teto de custo faturado ainda sem garantia; plano de piloto explicitamente não executado. Nenhum número de cliente, receita ou PMF é herdado, porque nenhum existe — ../product-designer-serie-08/prompt.md parte exatamente dessa ausência.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis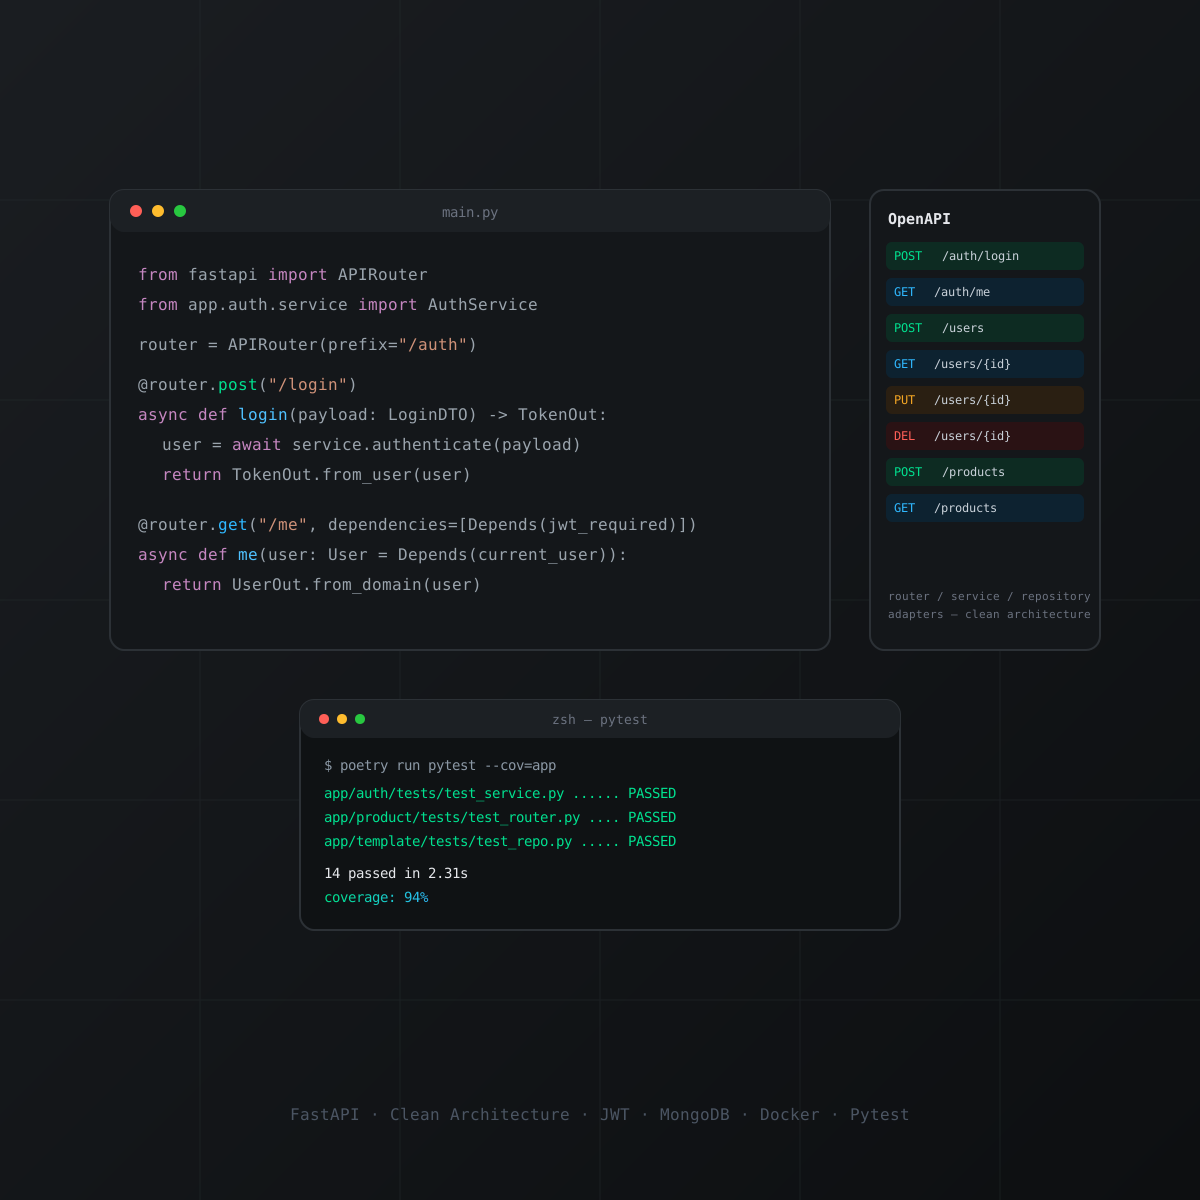
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto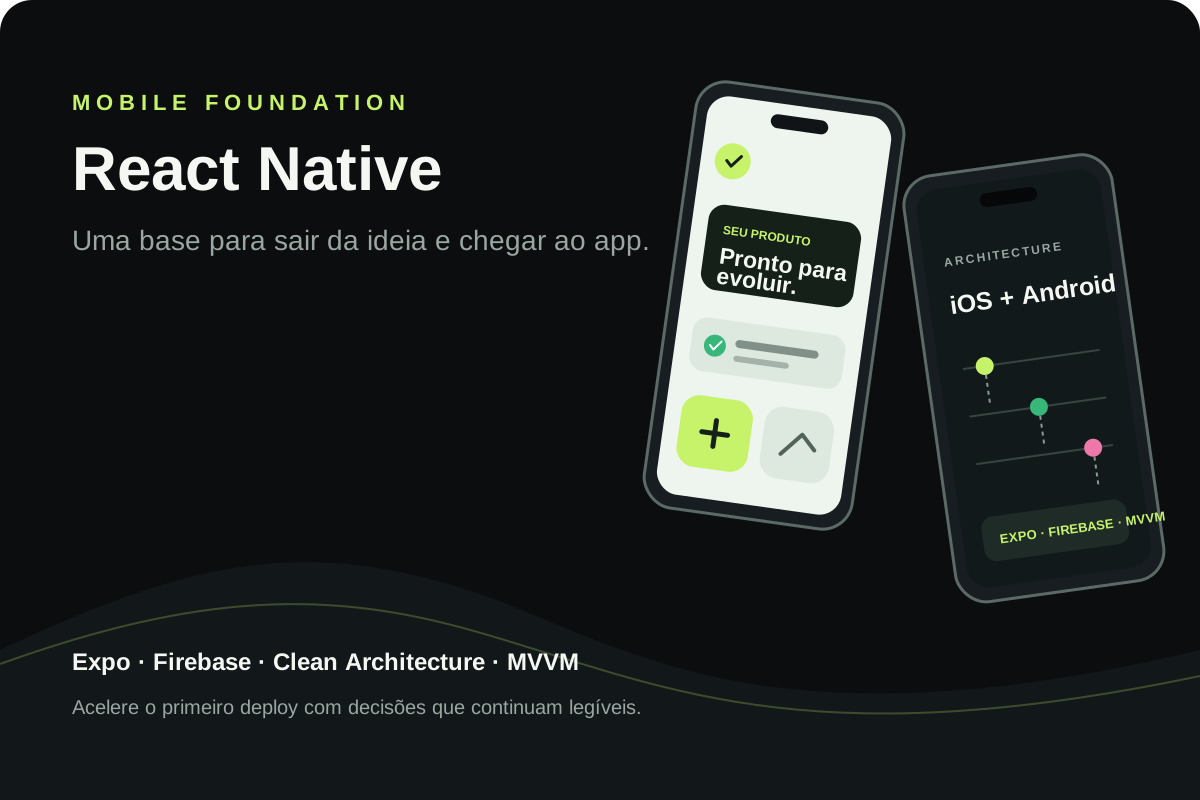
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
DeskPilot's tests were green. A synthetic provider outage, an actual local restore, and a release review exposed what those tests did not establish: whether a support agent can safely use the pilot.

A rule, an AI suggestion, and a human agent's decision, for the same synthetic ticket: only one of them can ever change the ticket's state. From that constraint, DeskPilot gains a typed…

81.8% of DeskPilot's AI suggestions were accepted or edited. That number looks great until someone asks how many of those suggestions led to a reopened ticket, or a missing satisfaction score,…
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.