
Anderson LimaSoftware Engineer & Consultant
4 de outubro de 2026
29 min de leitura
4 visualizações
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto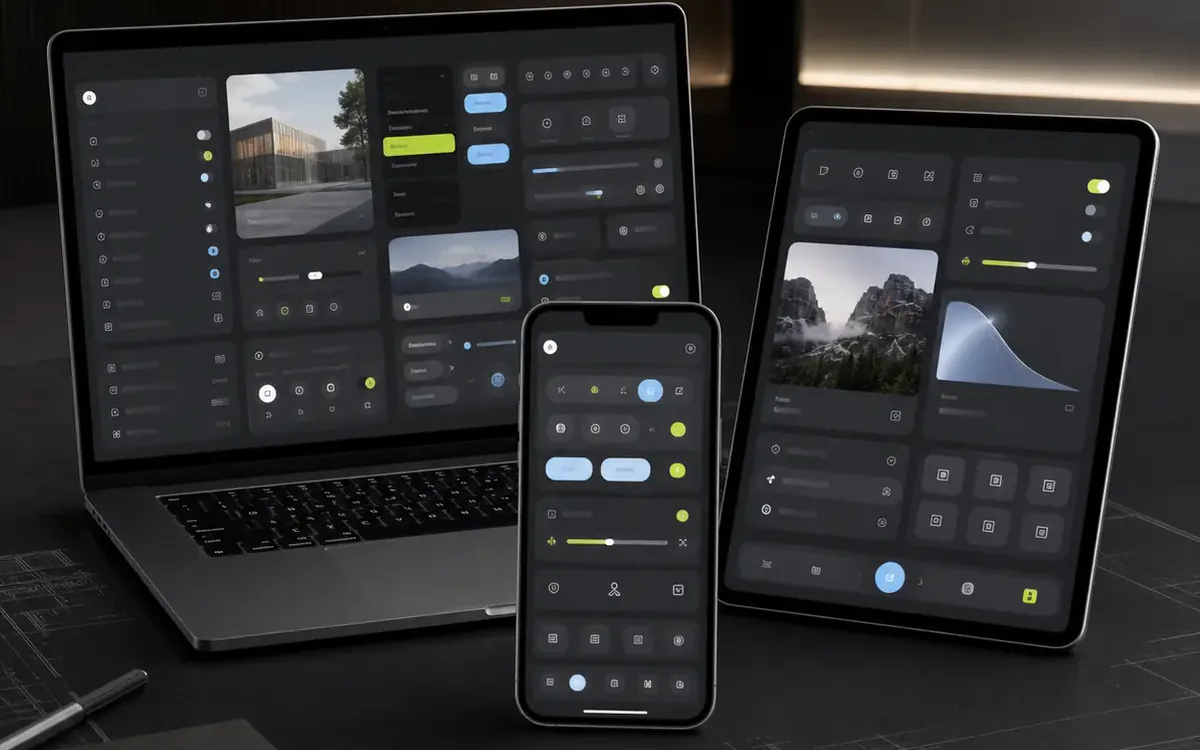
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto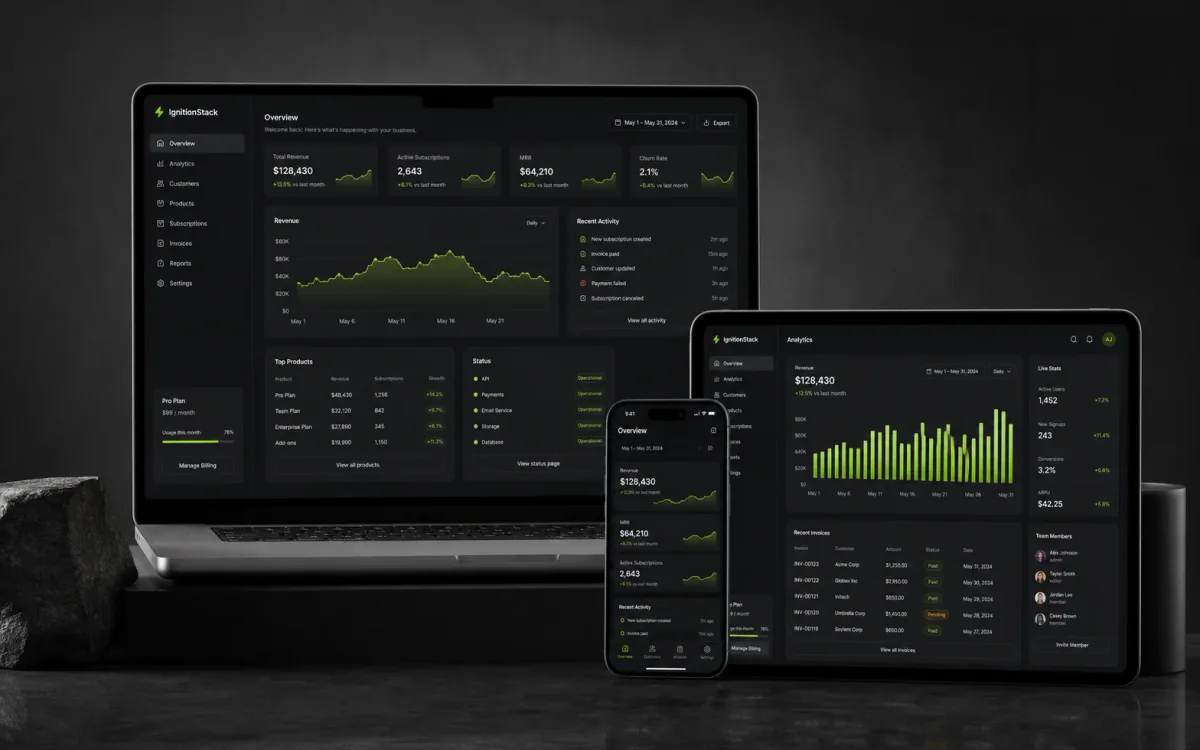
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
Em 2025, eu trabalhei 14 horas por dia durante 3 meses seguidos. Por FOMO. O resultado? Insonia. Irritabilidade. Zero criatividade. É a ironia: minha produtividade CAIU. Esse artigo de 65 minutos tem 20+ pesquisas, 7 pilares e um plano de 12 semanas para sair do burnout de forma sustentável.
App Router e Pages Router parecem uma discussão de moda, mas a diferença real está em modelo mental, limites entre servidor e cliente, cache, streaming, SEO, DX e custo de migração. Este guia mostra quando migrar, quando ficar e como evitar uma escolha cara demais para o seu produto.
Guia robusto para aplicar Dependency Inversion Principle com ports and adapters, React Context, contract tests e observabilidade de adapters em produção.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
English summary: Token bucket, leaky bucket, sliding window algorithms, quando usar e métricas.
Sua API recebe 1000 requests/segundo de um único cliente. Seus servidores derretem. Rate limiting protege contra abuso controlando quantas requests um cliente pode fazer em um período.
Conta requests em janelas de tempo fixas:
Window 1: 0-60s  → 100 requests (OK)
Window 2: 60-120s → 150 requests (BLOCK se limit = 100)
class FixedWindowRateLimiter {
  private windows: Map<string, { count: number; startTime: number }> = new Map();

  constructor(
    private maxRequests: number,
    private windowMs: number  // ex: 60000 = 1 minuto
  ) {}

  isAllowed(clientId: string): boolean {
    const now = Date.now();
    const window = this.windows.get(clientId);

    if (!window || now - window.startTime >= this.windowMs) {
      // Nova janela
      this.windows.set(clientId, { count: 1, startTime: now });
      return true;
    }

    if (window.count < this.maxRequests) {
      window.count++;
      return true;
    }

    return false;  // Rate limit exceeded
  }
}

// Uso
const limiter = new FixedWindowRateLimiter(100, 60000);  // 100 req/min

console.log(limiter.isAllowed('user1')); // true
// ... 99 more requests
console.log(limiter.isAllowed('user1')); // true (100th)
console.log(limiter.isAllowed('user1')); // false (exceeded)
Problema: Edge case - 200 requests em 2 segundos:
58s   → 100 requests (OK, window 1)
61s   → 100 requests (OK, window 2 resetou)
Total: 200 requests em 3 segundos!
Armazena timestamp de cada request, calcula quantos nos últimos N segundos:
class SlidingWindowLog {
  private logs: Map<string, number[]> = new Map();

  constructor(
    private maxRequests: number,
    private windowMs: number
  ) {}

  isAllowed(clientId: string): boolean {
    const now = Date.now();
    const log = this.logs.get(clientId) || [];

    // Remove timestamps antigos (fora da janela)
    const validLog = log.filter(timestamp => now - timestamp < this.windowMs);

    if (validLog.length < this.maxRequests) {
      validLog.push(now);
      this.logs.set(clientId, validLog);
      return true;
    }

    return false;
  }
}
Vantagem: Preciso, sem edge cases
Desvantagem: Consome memória (armazena todos timestamps)
Combina Fixed Window + Sliding Window:
class SlidingWindowCounter {
  private currentWindow: Map<string, number> = new Map();
  private previousWindow: Map<string, number> = new Map();
  private windowStart: number = Date.now();

  constructor(
    private maxRequests: number,
    private windowMs: number
  ) {}

  isAllowed(clientId: string): boolean {
    const now = Date.now();

    // Rotaciona janelas se necessário
    if (now - this.windowStart >= this.windowMs) {
      this.previousWindow = new Map(this.currentWindow);
      this.currentWindow.clear();
      this.windowStart = now;
    }

    const currentCount = this.currentWindow.get(clientId) || 0;
    const previousCount = this.previousWindow.get(clientId) || 0;

    // Peso baseado em quanto da janela anterior ainda conta
    const percentOfPrevious = Math.max(0, this.windowMs - (now - this.windowStart)) / this.windowMs;
    const estimatedCount = currentCount + (previousCount * percentOfPrevious);

    if (estimatedCount < this.maxRequests) {
      this.currentWindow.set(clientId, currentCount + 1);
      return true;
    }

    return false;
  }
}
Balde com tokens. Cada request consome 1 token. Tokens são reabastecidos constantemente:
class TokenBucket {
  private buckets: Map<string, { tokens: number; lastRefill: number }> = new Map();

  constructor(
    private maxTokens: number,      // Capacidade do balde
    private refillRate: number      // Tokens/segundo
  ) {}

  isAllowed(clientId: string, cost: number = 1): boolean {
    const now = Date.now();
    let bucket = this.buckets.get(clientId);

    if (!bucket) {
      bucket = { tokens: this.maxTokens, lastRefill: now };
      this.buckets.set(clientId, bucket);
    }

    // Reabastecer tokens baseado no tempo passado
    const timePassed = (now - bucket.lastRefill) / 1000;  // segundos
    const tokensToAdd = timePassed * this.refillRate;
    bucket.tokens = Math.min(this.maxTokens, bucket.tokens + tokensToAdd);
    bucket.lastRefill = now;

    if (bucket.tokens >= cost) {
      bucket.tokens -= cost;
      return true;
    }

    return false;
  }
}

// Uso
const limiter = new TokenBucket(100, 10);  // 100 tokens, refill 10/s

console.log(limiter.isAllowed('user1', 1));  // true (-1 token)
console.log(limiter.isAllowed('user1', 50)); // true (-50 tokens)
console.log(limiter.isAllowed('user1', 60)); // false (só 49 tokens restantes)

// Após 5 segundos: +50 tokens (10/s * 5s)
setTimeout(() => {
  console.log(limiter.isAllowed('user1', 60)); // true
}, 5000);
Vantagem: Permite bursts (usar todos tokens de uma vez)
Fila (queue). Requests entram na fila, saem em taxa constante:
class LeakyBucket {
  private queues: Map<string, number[]> = new Map();

  constructor(
    private maxQueueSize: number,
    private leakRateMs: number  // Taxa de vazamento (ms entre processar requests)
  ) {}

  async process(clientId: string, request: () => Promise<void>): Promise<boolean> {
    const queue = this.queues.get(clientId) || [];

    if (queue.length >= this.maxQueueSize) {
      return false;  // Queue cheia
    }

    queue.push(Date.now());
    this.queues.set(clientId, queue);

    // Processar na taxa de vazamento
    await new Promise(resolve => setTimeout(resolve, this.leakRateMs * queue.length));
    await request();

    queue.shift();
    return true;
  }
}

// Uso
const limiter = new LeakyBucket(10, 100);  // Max 10 na fila, vaza 1 a cada 100ms

await limiter.process('user1', async () => {
  console.log('Processing request');
});
Vantagem: Taxa de saída constante (smoothing)
Desvantagem: Adiciona latência (requests ficam em fila)
Para sistemas distribuídos, use Redis com Lua scripts (atômico):
-- Token Bucket em Redis
local key = KEYS[1]
local max_tokens = tonumber(ARGV[1])
local refill_rate = tonumber(ARGV[2])
local cost = tonumber(ARGV[3])
local now = tonumber(ARGV[4])

local bucket = redis.call('HMGET', key, 'tokens', 'last_refill')
local tokens = tonumber(bucket[1]) or max_tokens
local last_refill = tonumber(bucket[2]) or now

-- Refill
local time_passed = (now - last_refill) / 1000
local tokens_to_add = time_passed * refill_rate
tokens = math.min(max_tokens, tokens + tokens_to_add)

if tokens >= cost then
  tokens = tokens - cost
  redis.call('HMSET', key, 'tokens', tokens, 'last_refill', now)
  redis.call('EXPIRE', key, 3600)
  return 1  -- Allowed
else
  return 0  -- Blocked
end
// Node.js
import { createClient } from 'redis';

const redis = createClient();

async function isAllowed(clientId: string): Promise<boolean> {
  const result = await redis.eval(luaScript, {
    keys: [`rate_limit:${clientId}`],
    arguments: ['100', '10', '1', Date.now().toString()]
  });

  return result === 1;
}
Diferentes limites para diferentes clientes:
enum Tier {
  FREE = 100,
  PRO = 1000,
  ENTERPRISE = 10000
}

class TieredRateLimiter {
  private limiters: Map<Tier, TokenBucket> = new Map();

  constructor() {
    this.limiters.set(Tier.FREE, new TokenBucket(100, 1));
    this.limiters.set(Tier.PRO, new TokenBucket(1000, 10));
    this.limiters.set(Tier.ENTERPRISE, new TokenBucket(10000, 100));
  }

  isAllowed(clientId: string, tier: Tier): boolean {
    return this.limiters.get(tier)!.isAllowed(clientId);
  }
}
Comunique rate limit ao cliente:
app.use(async (req, res, next) => {
  const allowed = await rateLimiter.isAllowed(req.ip);

  res.setHeader('X-RateLimit-Limit', '100');
  res.setHeader('X-RateLimit-Remaining', allowed ? '99' : '0');
  res.setHeader('X-RateLimit-Reset', Date.now() + 60000);

  if (!allowed) {
    res.status(429).json({ error: 'Too Many Requests' });
    return;
  }

  next();
});
limit_req_zone $binary_remote_addr zone=mylimit:10m rate=10r/s;

server {
    location /api/ {
        limit_req zone=mylimit burst=20;
    }
}
import rateLimit from 'express-rate-limit';

const limiter = rateLimit({
  windowMs: 15 * 60 * 1000, // 15 minutos
  max: 100 // 100 requests por windowMs
});

app.use('/api/', limiter);
Resources:
  ApiGatewayUsagePlan:
    Type: AWS::ApiGateway::UsagePlan
    Properties:
      Throttle:
        BurstLimit: 200
        RateLimit: 100  # requests/second
| Algoritmo | Quando Usar |
|---|---|
| Fixed Window | Simples, uso interno |
| Sliding Window | Precisão importante, tráfego variável |
| Token Bucket | Permitir bursts curtos |
| Leaky Bucket | Taxa de saída constante (streaming) |
Rate Limiting não é sobre "bloquear usuários". É sobre proteger seu sistema de abuso e garantir fair usage.
Se sua API não tem rate limiting, você está a um script malicioso de derrubar produção.
Cenário: API pública evitando abuso. A ConnectAPI misturou sliding window para fairness + token bucket para bursting, registrando métricas por cliente.
| Métrica | Antes | Depois |
|---|---|---|
| Incidentes por overload | 12/mês | 0 |
| Tempo p/ bloquear abuso | minutos | <2s |
| Churn por falso positivo | alto | quase zero |
Toda equipe acha que rate limiting é um detalhe de infraestrutura. Até o dia em que um cliente automatiza milhares de chamadas por minuto. Ou até o momento em que um bot descobre seu endpoint mais barato. Ou até a integração de um parceiro externo ignorar limites implícitos.
Rate limiting não existe para punir o usuário. Ele existe para proteger o sistema. Quando você deixa a API aberta sem política de consumo, você transfere risco para toda a plataforma. O custo aparece em CPU, memória, filas, cache, banco, observabilidade e suporte.
O padrão mais comum é este. O time começa com um endpoint simples. Depois adiciona autenticação. Depois adiciona paginação. Depois adiciona retries. Depois descobre que os retries dos clientes viram amplificação de tráfego. O incidente parece súbito. Na prática, ele foi plantado meses antes.
Rate limiting é um contrato. Ele define quanto um consumidor pode pedir. Ele define como bursts são tratados. Ele define como fairness é aplicado. Ele define o que acontece quando o sistema está sob pressão.
Se esse contrato não estiver explícito, a API vira aposta.
Um bom limitador precisa responder cinco perguntas.
Essas perguntas parecem simples. Elas não são. Cada resposta cria trade-offs diferentes.
Se você usar uma janela fixa, ganha simplicidade e perde precisão. Se você usar uma janela deslizante, ganha justiça e perde custo de memória. Se você usar token bucket, ganha bursts controlados e perde previsibilidade de fila. Se você usar leaky bucket, ganha suavização e perde latência.
Não existe algoritmo perfeito. Existe algoritmo apropriado para uma intenção específica.
Comece do objetivo. Você quer evitar que um consumidor destrua a capacidade compartilhada.
Isso significa que a política precisa:
Se uma política não contribui para esses seis pontos, ela é cosmética.
Agora aplique a inversão. O que faria o rate limiting falhar?
Se você desenhar o sistema para evitar esses erros, a solução fica muito melhor.
É o mais fácil de explicar. Você conta requests em blocos temporais.
O problema é a borda. Se a janela reinicia em um segundo exato, o cliente pode concentrar tráfego perto da transição. O resultado é um pico artificial.
Esse algoritmo funciona quando:
Ele falha quando:
É o mais preciso. Você armazena timestamps individuais. Para cada request, calcula quantas aconteceram nos últimos N milissegundos.
Esse algoritmo é forte porque elimina o problema de borda. Também é caro porque cresce com o volume de tráfego.
Ele funciona melhor quando:
É o meio-termo. Você usa a janela atual e a anterior para estimar consumo com suavização.
Isso reduz o custo de armazenar todos os eventos. Também melhora o comportamento de borda.
Na prática, ele é um dos melhores compromissos para sistemas com grande escala.
É o algoritmo mais versátil. Cada consumidor tem um balde com capacidade máxima. As requests consomem tokens. Os tokens se regeneram em uma taxa constante.
Isso permite burst controlado. Um cliente pode usar rapidamente sua cota acumulada. Depois precisa esperar o refill.
Esse modelo é ideal quando:
Aqui você pensa em fila. As requests entram. Saem em taxa constante.
Esse algoritmo é ótimo para suavizar tráfego. Também cria mais latência. Por isso ele faz sentido quando o sistema downstream é sensível a variações.
Fixed window parece ingênuo. Mas é útil. Ele é simples de implementar. Ele é fácil de explicar. Ele é barato para observar.
O risco está na janela. Se o seu limite for 100 req/min, um cliente pode fazer 100 requests no fim do minuto e mais 100 no começo do seguinte. Isso gera 200 requests em segundos.
Esse efeito chama-se burst de borda. Ele é aceitável em alguns cenários. Ele é perigoso em outros.
Você precisa de:
Esse algoritmo é conceitualmente elegante. Ele responde à pergunta certa. Quantas requests ocorreram agora, olhando para trás em N milissegundos?
O custo é claro. Você precisa armazenar timestamps. Você precisa limpar eventos antigos. Você precisa decidir se a limpeza acontece no read, no write ou em background.
Em sistemas de grande volume, isso pode virar custo operacional pesado.
Ele é excelente para auditoria. Você consegue reconstruir consumo com precisão. Isso é bom para debug. Isso é bom para disputa de quota. Isso é bom para investigar comportamento suspeito.
Ele é mais caro do que parece. Se um cliente estiver chamando a API sem parar, a fila de timestamps cresce. Isso vira pressão de memória. Também pode virar pressão de GC em runtimes gerenciados.
Esse algoritmo tenta reduzir o custo do log. Em vez de guardar todos os timestamps, ele usa agregação.
O truque é simples. Você mede a janela atual. Você mede a janela anterior. Depois combina os dois com um peso proporcional ao tempo restante.
Isso entrega uma aproximação boa o bastante para muitos casos. É mais barato que o log puro. É mais justo que o fixed window.
Token bucket merece atenção porque ele é o mais útil no mundo real. Ele modela comportamento humano melhor do que janelas rígidas. Usuários legítimos não fazem tráfego em linha reta. Eles têm bursts. Eles navegam. Eles clicam. Eles automatizam em grupos.
Token bucket aceita isso. Ao mesmo tempo, impede abuso sustentado.
Imagine um balde que comporta 100 tokens. Ele recebe 10 tokens por segundo. Cada request custa 1 token. Se o cliente não usar nada por um tempo, o balde enche. Se ele fizer um burst, ele consome o estoque acumulado. Depois precisa esperar reposição.
Isso é muito bom para:
Se você configurar capacidade demais, o burst vira excesso. Se configurar refill demais, o limitador fica frouxo. Se configurar pouco, ele vira fricção.
Leaky bucket é mais próximo de uma fila controlada. Requests entram. O sistema libera em velocidade constante.
Isso suaviza carga. Isso protege recursos downstream. Isso torna latência mais previsível.
Mas há um preço. A fila introduz atraso. Se o usuário espera resposta imediata, o algoritmo pode piorar UX.
| Algoritmo | Memória | Precisão | Burst | Latência | Complexidade |
|---|---|---|---|---|---|
| Fixed Window | Baixa | Baixa | Ruim na borda | Baixa | Baixa |
| Sliding Log | Alta | Alta | Boa | Baixa a média | Média |
| Sliding Counter | Baixa a média | Média a alta | Boa | Baixa | Média |
| Token Bucket | Baixa | Alta para quota | Excelente | Baixa | Média |
| Leaky Bucket | Baixa a média | Média | Controlado | Alta | Média |
Essa tabela não decide por você. Ela só expõe o custo.
Você precisa definir o sujeito da política.
Pode ser:
Cada opção muda o efeito da política.
IP é fácil. IP também é ruim em redes compartilhadas.
API key é melhor para parceiros. API key não resolve abuso dentro do tenant.
Tenant id é bom para SaaS. Tenant id exige modelagem clara de quota e subquota.
O ponto é simples. Sem identidade correta, você limita a pessoa errada.
Sistemas maduros não têm um único limite. Eles têm camadas.
Essa hierarquia evita um problema comum. Se você só limitar o usuário final, um tenant inteiro pode saturar uma rota compartilhada. Se você só limitar a rota, um tenant pode monopolizar o orçamento.
Em um sistema distribuído, o limitador não vive sozinho. Ele precisa sobreviver a múltiplas instâncias da aplicação.
Isso traz uma pergunta crítica. Onde fica o estado?
Opções comuns:
Memória local é rápida. Memória local quebra consistência horizontal.
Redis é o ponto de equilíbrio mais comum. Redis oferece atomicidade suficiente com Lua. Redis também adiciona dependência operacional.
Banco relacional é bom para consistência. Banco relacional pode ser caro para alta frequência.
Gateway e proxy são bons para enforcement na borda. Isso reduz ida e volta para o backend.
Redis aparece muito porque ele resolve um problema específico. Você precisa de leitura, escrita e incremento com atomicidade.
Um limitador distribuído precisa evitar race condition. Se duas instâncias checam o limite ao mesmo tempo, ambas podem permitir a request. Isso viola a política.
Lua scripts ajudam porque o cálculo inteiro roda atomicamente no servidor Redis.
INCR com TTL para contadores simplesZSET para logs de sliding windowHASH para buckets por consumidorO padrão clássico:
O importante é que tudo isso aconteça atomically.
local key = KEYS[1]
local capacity = tonumber(ARGV[1])
local refill_per_sec = tonumber(ARGV[2])
local cost = tonumber(ARGV[3])
local now = tonumber(ARGV[4])

local data = redis.call("HMGET", key, "tokens", "ts")
local tokens = tonumber(data[1]) or capacity
local ts = tonumber(data[2]) or now

local elapsed = math.max(0, now - ts)
local refill = (elapsed / 1000) * refill_per_sec
tokens = math.min(capacity, tokens + refill)

if tokens < cost then
  redis.call("HMSET", key, "tokens", tokens, "ts", now)
  redis.call("EXPIRE", key, 3600)
  return 0
end

tokens = tokens - cost
redis.call("HMSET", key, "tokens", tokens, "ts", now)
redis.call("EXPIRE", key, 3600)
return 1
Esse script é pequeno. Ele também é o tipo de coisa que economiza horas de dor.
Para sliding log, um ZSET funciona bem.
Cada request vira um timestamp.
Requests antigas são removidas com ZREMRANGEBYSCORE.
Esse padrão é preciso. Também é mais caro em grande escala.
local key = KEYS[1]
local limit = tonumber(ARGV[1])
local window_ms = tonumber(ARGV[2])
local now = tonumber(ARGV[3])
local start = now - window_ms

redis.call("ZREMRANGEBYSCORE", key, 0, start)
local count = redis.call("ZCARD", key)

if count >= limit then
  return 0
end

redis.call("ZADD", key, now, now .. "-" .. redis.call("INCR", key .. ":seq"))
redis.call("EXPIRE", key, math.ceil(window_ms / 1000))
return 1
NGINX é útil quando você quer bloquear cedo. Quanto mais perto da borda a política estiver, menor o custo do abuso.
Isso reduz pressão em backend, banco e filas.
http {
    limit_req_zone $binary_remote_addr zone=api_limit:10m rate=10r/s;
    limit_req_status 429;

    server {
        location /api/ {
            limit_req zone=api_limit burst=20 nodelay;
            proxy_pass http://backend;
        }
    }
}
NGINX não sabe tudo sobre o negócio. Ele enxerga bem IP, host e path. Ele não enxerga quota de tenant sem integração adicional.
Envoy é mais poderoso quando você precisa de uma camada de malha ou gateway. Ele suporta rate limit com serviço externo. Isso permite políticas mais ricas do que a borda estática consegue expressar.
O fluxo é simples.
Esse desenho permite centralizar política. Também cria dependência operacional no serviço de rate limit.
API gateways oferecem uma forma prática de centralizar limites por consumidor. Isso é útil quando você tem muitos clientes externos.
Você pode aplicar:
Mas gateway não substitui desenho de sistema. Ele só impõe políticas existentes. Se sua arquitetura downstream já está mal desenhada, o gateway vai apenas atrasar o colapso.
Rate limiting não serve apenas para bloquear abuso. Ele também serve para distribuir oportunidade.
Sem fairness, um tenant barulhento domina os recursos. Com fairness, cada consumidor recebe uma parcela previsível.
Isso é importante em:
Abuso não parece sempre ataque. Às vezes parece automação legítima. Às vezes parece bug de cliente. Às vezes parece retry sem backoff.
O sistema precisa distinguir:
Nem sempre dá para identificar a intenção. Por isso as políticas precisam ser robustas mesmo quando a intenção é ambígua.
Políticas adaptativas mudam limites com base em contexto.
Exemplos:
Essa abordagem é poderosa. Também é perigosa. Se a política muda demais, clientes ficam sem previsibilidade.
Use adaptatividade para proteção. Não use para esconder falta de capacidade.
Rate limiting sem comunicação vira frustração. O cliente precisa saber o que fazer.
Por isso os headers importam.
X-RateLimit-LimitX-RateLimit-RemainingX-RateLimit-ResetRetry-AfterSe o cliente respeita o feedback, a experiência melhora. Se o cliente ignora, você ainda precisa estar protegido.
Alguns sistemas sofrem porque clientes enviam retries de forma agressiva. O melhor antídoto é combinar rate limit com idempotency keys.
Rate limit protege capacidade. Idempotency protege semântica.
Sem idempotency, um retry pode virar duplicação de pedido. Sem rate limiting, um bug de retry pode virar avalanche.
Um rate limiter invisível vira caixa-preta. Você precisa observar:
Se você não medir isso, vai operar no escuro.
Alertar em excesso também é falha. O ideal é alertar quando:
Se o alerta não ajuda ação operacional, ele vira ruído.
Se você usa timestamps e os relógios divergem, a política pode ficar incoerente. Use clock monotônico quando possível. Quando não for possível, trate o tempo com cuidado.
Se o backend de estado cai, o que acontece?
Cada escolha tem implicação. Fail open preserva disponibilidade. Fail closed preserva proteção. O correto depende do risco do endpoint.
Uma chave popular pode virar gargalo. Isso acontece quando um único tenant ou IP concentra tráfego.
Mitigações:
Quando muitos clientes recebem 429 ao mesmo tempo, eles podem voltar juntos. Isso piora o pico.
Mitigação:
Retry-AfterNão lance política agressiva de uma vez. O rollout certo é gradual.
Esse ritmo reduz risco operacional. Também aumenta confiança do time.
Shadow mode é subestimado. Ele permite calcular a decisão sem impactar o fluxo.
Você consegue responder:
Essa visão evita quebra prematura.
Imagine uma API de relatórios. O time percebe que certos clientes dispararam exportações em massa. O banco começou a saturar. As filas cresceram. O time precisava agir sem matar clientes legítimos.
429 não é só um status. É uma mensagem de produto.
A resposta deve ser clara.
Bom exemplo:
{
  "error": "rate_limit_exceeded",
  "message": "You have reached your request limit for this minute.",
  "retryAfterSeconds": 12
}
Ruim exemplo:
{
  "error": "Too Many Requests"
}
O usuário precisa de contexto. Sem isso, ele vai tentar de novo do mesmo jeito.
Rate limiting também é instrumento comercial. Em SaaS, quota define embalagem de valor.
Você pode separar:
O erro comum é misturar proteção com monetização de forma confusa. Se a política de preço e a política de proteção estiverem misturadas, o suporte paga a conta.
Nem toda rota custa o mesmo.
Logo, o limite precisa refletir custo. Limite igual para tudo é elegante. Também é ingênuo.
Alguns sistemas usam weighted cost. Uma request simples custa 1. Uma exportação custa 10. Uma operação com múltiplos writes custa 5.
Esse modelo é mais justo. Também exige disciplina para manter os pesos.
GraphQL complica o jogo. Uma única query pode custar pouco ou muito. Você precisa medir complexity, depth ou resolver cost.
O limite não pode olhar apenas para a URL. Ele precisa olhar para o shape da operação.
Isso evita que uma query aparentemente pequena consuma recursos excessivos.
Em streaming, limitar requests não basta. Você também precisa limitar conexões, mensagens, frames ou eventos por janela.
SSE, WebSocket e Kafka têm dinâmicas diferentes. O algoritmo precisa respeitar isso.
Quando você opera globalmente, surge latência. Se o rate limit depende de um backend central, a decisão fica mais lenta.
Opções:
O trade-off é inevitável. Mais consistência global geralmente custa mais latência.
Bloquear no edge é poderoso. Você corta tráfego cedo. Você reduz custo de transporte. Você protege origem.
Mas edge policy costuma ser mais simples. Ela não conhece todos os detalhes do domínio.
Então o ideal é combinar:
Um rate limiter sem teste é um incêndio esperando acontecer.
Teste:
Faça benchmark do limitador com carga realista. Não teste só happy path.
Mensure:
Isso evita otimização cega.
Nem toda rota precisa de limitador rígido.
Se a rota é interna e isolada. Se o custo é mínimo. Se o endpoint já está protegido por outra camada. Se o limite adicionaria fricção sem ganho real.
Nesses casos, simplifique. Boa engenharia também é saber onde não adicionar política.
Retry-AfterRate limiting é uma disciplina de proteção. Ele equilibra justiça, capacidade e experiência. Ele precisa de algoritmo certo, identidade certa, observabilidade certa e fallback certo.
Se você trata rate limiting como detalhe, ele vira incidente. Se você trata como contrato, ele vira vantagem operacional.
Token bucket. Ele é o melhor ponto de partida para a maioria das APIs.
Sliding window log. Ele é mais preciso, mas custa mais.
Fixed window counter. Mas ele é o que mais sofre com borda.
Pode. Só não finja que isso resolve consistência horizontal.
Allowed, blocked, latency do check, top consumers, erros do backend e falsos positivos.
Título: Rate limiting algorithms: proteja sua API antes que o abuso apareça
Resumo: Rate limiting não é só bloquear requests. É uma política de proteção que controla bursts, fairness e capacidade em APIs e sistemas distribuídos. Token bucket, leaky bucket e sliding window resolvem problemas diferentes. A escolha certa depende de custo, latência e previsibilidade.
Pontos-chave
Retry-After melhoram a experiência do cliente.CTA
Se sua API ainda não tem política explícita de limite, você já está operando com risco desnecessário.
Title: Rate limiting algorithms: protect your API before abuse shows up
Summary: Rate limiting is not just about blocking requests. It is a protection policy that controls bursts, fairness, and capacity in APIs and distributed systems. Token bucket, leaky bucket, and sliding window solve different problems. The right choice depends on cost, latency, and predictability.
Key points
Retry-After improve client behavior.CTA
If your API still has no explicit limit policy, you are already carrying unnecessary risk.