
Anderson LimaSoftware Engineer & Architect
1 de outubro de 2026
21 min de leitura
0 visualizações
DeskPilot v0.2 troca zero regras de domínio por uma sugestão de categoria e resumo, validada em código, visível apenas em modo sombra até um humano revisar

Um ticket sintético chega na fila do tenant A: "O sistema retorna erro 500 toda vez que tento salvar o formulário de cadastro de cliente." Três respostas possíveis para essa mesma frase, lado a lado:
if procura a substring "erro 500" no texto, encontra, marca a categoria como bug. Zero custo, zero latência perceptível, zero capacidade de lidar com qualquer ticket que não contenha essa string exata.category: "bug", um resumo de uma frase, uma citação verbatim do trecho que justifica a categoria, e uma confiança autodeclarada de 0,82. Custa uma fração de centavo e cerca de 15ms nesta sessão (número do stub, não de um provedor real). Mas é só uma sugestão — nenhuma linha de código faz esse JSON virar uma mudança de estado.bug sugerido também vê o ticket inteiro, decide se aceita, edita ou rejeita a sugestão, e só essa decisão — chamando o mesmo applySuggestionCommand que o capítulo 03 já testava — muda o que fica registrado.As três coexistem neste capítulo, e a linha entre elas não é estilística: é a mesma linha que separa TICKET_TRANSITIONS de SUGGESTION_TRANSITIONS no domínio herdado do capítulo 03, inalterado desde então. Uma sugestão de IA nunca aparece na lista de papéis autorizados para nenhuma transição de ticket — e é exatamente essa omissão, não uma instrução de prompt, que impede qualquer coisa que um modelo produza de virar prioridade, atribuição ou comunicação externa sem revisão.
Este capítulo constrói a primeira sugestão de IA real do DeskPilot — categoria e resumo de ticket, em modo sombra — e as quatro falhas que essa transição costuma introduzir quando o cuidado do capítulo anterior não é levado adiante.
Antes de qualquer arquitetura, o contrato de saída que este capítulo inteiro protege:
export interface ValidatedSuggestionOutput {
  schemaVersion: string;
  tenantId: string;
  ticketId: string;
  category: Category;
  summary: string;
  evidenceQuotes: string[];
  /**
   * Self-declared by the model, 0..1. NOT a calibrated probability -- see
   * Failure #2. Nothing that reads this field is permitted to use it to
   * skip human review, auto-accept a suggestion, or widen a permission.
   */
  confidenceSelfDeclared: number;
  abstain: boolean;
  modelId: string;
  promptVersion: string;
  policyVersion: string;
  dataVersion: string;
}
E a verificação que decide se um JSON bruto vira esse tipo ou vira um fallback:
const tenantId = String(obj.tenant_id);
if (tenantId !== ctx.expectedTenantId) {
  // This is the structural fix for "modelos ... produzem side effect
  // final" / "tenant errado": tenant scoping is verified here, in code,
  // never trusted because the model echoed the right-looking value.
  errors.push("tenant_mismatch");
}
// (ticket_id, category, abstain e summary recebem a mesma disciplina)
for (const quote of evidenceArray) {
  // The grounding check: every cited quote must appear verbatim in the
  // text the model was actually authorized to read. A quote that is not
  // a substring is either a hallucination or evidence for a claim
  // outside the authorized context -- both are rejected the same way.
  if (!ctx.authorizedText.includes(quote)) {
    errors.push("evidence_not_verbatim");
    break;
  }
}
Duas linhas fazem o trabalho pesado deste capítulo. A primeira nunca confia no tenant_id que o modelo devolveu — ele é comparado contra o tenant que fez a pergunta, e uma divergência vira erro, não um aviso. A segunda nunca aceita uma citação de evidência que não exista, palavra por palavra, no texto que o modelo estava autorizado a ler. Um JSON pode estar perfeitamente bem formado, com uma categoria dentro do enum permitido, e ainda assim ser rejeitado — porque schema válido e conteúdo verdadeiro são propriedades diferentes, e confundi-las é a primeira das quatro falhas deste capítulo.
Nenhuma dessas duas linhas depende do modelo "se comportar bem". Elas seriam exatamente as mesmas se o adaptador fosse um provedor real pago ou o stub determinístico que este capítulo de fato usa — e é esse o ponto: a garantia vive na validação, não na confiança de que um modelo específico é bem-comportado.
A tarefa escolhida para este capítulo é deliberadamente pequena: sugerir categoria e um resumo curto, com evidência citada do próprio ticket. Prioridade final, atribuição e qualquer comunicação externa continuam comandos humanos, validados pelo mesmo applyCommand que os capítulos 03 e 04 já cobrem com teste. Essa restrição não é modéstia — é a única forma de fazer a pergunta certa: "essa sugestão específica economiza tempo de revisão sem abrir nenhum caminho novo de dano?", em vez da pergunta maior e mais vaga "a IA ajuda o produto?".
A comparação que o capítulo pede — nenhuma IA, regra, chamada única, workflow, agente — tem uma resposta direta para cada opção não escolhida. Regra pura (um classificador por palavra-chave) já existe neste código, como baseline: é o mesmo ruleBasedCategory que o eval usa para comparação, e sozinha ela nunca abstém, mesmo quando o ticket não tem informação suficiente — ela sempre "adivinha" alguma categoria. Workflow ou agente com múltiplas etapas e ferramentas não foram construídos porque nenhum erro observado nos 47 casos deste capítulo pede uma etapa adicional de busca ou uma ferramenta externa: o contexto autorizado cabe inteiro na entrada, e a Anthropic recomenda diretamente essa ordem de prioridade — "para muitas aplicações, otimizar chamadas únicas de LLM com exemplos no contexto já é suficiente" — adicionar complexidade sem um erro observado que a justifique é o oposto do que este capítulo defende.
O que sobra é uma chamada única, tipada, validada, e presa a um modo sombra: a sugestão existe, é visível para o agente, mas não muda nada sozinha.
O capítulo 04 deixou a tabela suggestions vazia por desenho — ela existia no contrato, mas nada escrevia nela. Este capítulo escreve nela pela primeira vez, sem tocar em nenhuma regra herdada:
// Migration note (PE04 -> PE05): copied byte-for-byte again, still no type,
// transition or rule edited. Chapter 05 adds an AI suggestion path entirely
// in ../ai/ (schema validation, stub/real adapter, shadow orchestration) and
// extends the storage contract in ./repository.ts to persist the richer
// suggestion payload — it does not touch applyCommand, TICKET_TRANSITIONS or
// the "ai" role's exclusion from every allowedRoles list below. That
// exclusion is precisely the guard the new AI path depends on: no matter
// what a model outputs, nothing in this file lets it reach applyCommand.
Esse comentário está literalmente no topo de src/domain/domain.ts — o mesmo arquivo que o capítulo 04 já havia copiado byte a byte do capítulo 03. Três sessões depois, zero linhas de regra de domínio mudaram. O que mudou foi tudo ao redor:
src/ai/schema.ts valida o formato acima sem nenhuma biblioteca de terceiros — doze verificações sequenciais (campo obrigatório presente, categoria no enum, tenant e ticket batendo, tamanho de resumo, evidência verbatim, confiança no intervalo [0, 1]), cada uma retornando um motivo específico de rejeição, nunca um booleano opaco.
src/ai/adapter.ts define a interface SuggestionAdapter e duas implementações. StubAdapter é determinístico e offline — a única usada em qualquer teste ou no eval deste capítulo — e aceita um campo simulate que força um entre dez comportamentos (normal, abstenção, JSON malformado, tenant errado, resumo longo demais, evidência alucinada, categoria inválida, timeout, custo alto, indisponibilidade). HttpProviderAdapter implementa a mesma interface para um provedor real, mas nenhuma sessão até agora o instancia — não existe chave paga neste ambiente, e o próprio prompt que rege este pacote proíbe usar uma.
src/ai/shadow.ts é o orquestrador. Ele corre o adaptador contra um timeout com Promise.race, aplica um teto de custo por tarefa antes de aceitar qualquer resposta, valida com schema.ts, e decide entre gravar uma sugestão pending ou registrar um fallback auditável. Nenhum desses quatro comportamentos — timeout, custo, validação, fallback — é opcional ou condicional a um provedor específico; todos rodam para o stub exatamente como rodariam para um provedor real, porque dependem apenas da interface SuggestionAdapter, nunca da classe concreta por trás dela.
Duas rotas HTTP novas. POST /tickets/:id/suggest exige um ator com papel system — nem agent, nem manager, e certamente nunca ai, que não tem sessão possível. POST /tickets/:id/suggestions/review é a única rota que muda o estado de uma sugestão, chamando o applySuggestionCommand que já existia, inalterado, desde o capítulo 03.
migrations/0002_suggestion_details.sql é aditiva: nenhuma coluna, tipo ou política do capítulo 04 foi alterada. A nova tabela suggestion_details guarda resumo, evidência e confiança — os campos que uma sugestão precisa ter para ser revisável, mas que a tabela suggestions original nunca teve porque o capítulo 04 a deixou vazia por desenho. A mesma política de row-level security que protege tickets desde o capítulo 04 protege esta tabela nova, linha por linha idêntica, e um teste de integração real contra Postgres prova isso — não apenas o teste offline com repositório em memória.
| Decisão | Alternativa rejeitada | Por quê |
|---|---|---|
| Schema validado à mão, sem biblioteca | Zod, Ajv ou similar | Doze verificações sequenciais não justificam uma dependência nova; a mesma disciplina de "sem framework HTTP" do capítulo 04 (só node:http) se aplica aqui |
Sugestão em tabela separada (suggestion_details), não como coluna nova em suggestions | Adicionar summary/evidence/confidence direto em suggestions | suggestions já tinha um contrato usado pelo capítulo 04 (id, tenant_id, ticket_id, state, category, reviewed_by); estender por tabela evita migração destrutiva e documenta a mudança como aditiva |
Ator system exclusivo para disparar geração | Permitir que qualquer ator autenticado dispare /suggest | Geração de sugestão é um evento de sistema, não uma ação de agente — misturar os dois esconderia quem de fato pediu a sugestão no log de auditoria |
| Confiança autodeclarada armazenada, nunca lida para decisão | Usar confidence > 0.8 para pular revisão humana em casos "óbvios" | Confiança autodeclarada de um LLM não é uma probabilidade calibrada — ver Falha 2 abaixo; qualquer atalho aqui reabre exatamente o problema que o modo sombra existe para fechar |
| Orçamento de custo e timeout aplicados antes da validação de schema | Validar primeiro, cortar custo depois | Uma resposta bem formada mas cara ainda é descartada — o orçamento é uma política independente da qualidade da resposta, não uma otimização sobre respostas já aceitas |
| Eval com baseline de regras no mesmo corpus | Reportar só a taxa de acerto da IA, isoladamente | Um número sozinho não diz se a IA supera a alternativa mais simples — e nesta sessão, sem provedor real, os dois caminhos compartilham a mesma função de classificação por construção (ver seção de Avaliação) |
Falha 1 — schema confundido com verdade. Sintoma: um JSON bem formado, com categoria dentro do enum, é tratado como se a categoria estivesse correta ou a evidência fosse real. Causa: validação estrutural e correção de conteúdo são a mesma verificação na cabeça de quem constrói o sistema, mas não são a mesma verificação no código. Resposta: examples/eval/report.json mantém valid_output_rate (0,84 em dev, 0,818 em holdout — quantos JSONs passaram na validação) separado de category_accuracy (0,895 em dev, 0,882 em holdout — de quem passou, quantos acertaram a categoria) como dois números distintos, nunca um só. O caso case-044 no dataset força exatamente esse cenário: um JSON válido cuja citação de evidência não existe no ticket — rejeitado por evidence_not_verbatim, mesmo com todo o resto correto.
Falha 2 — confiança autodeclarada usada como autorização. Sintoma: um número de confiança alto vira desculpa para pular revisão humana ou aceitar automaticamente. Causa: confidence parece uma probabilidade porque tem a forma de uma, mas é autodeclarada pelo mesmo modelo que pode estar errado sobre o resto. Resposta: confidenceSelfDeclared é gravado em suggestion_details e devolvido para exibição — e não existe nenhuma outra leitura desse campo em src/ai/shadow.ts ou src/api/server.ts. O teste "normal scenario: writes a pending suggestion... never touches ticket state" prova isso operacionalmente: mesmo com confiança 0,82, a sugestão nasce em estado pending, idêntico ao que nasceria com confiança 0,3 — só applySuggestionCommand, chamado por um agente humano autenticado, muda esse estado.
Falha 3 — holdout contaminado. Sintoma: o holdout deixa de significar alguma coisa porque o sistema foi ajustado repetidamente contra os próprios erros que ele deveria medir de forma independente. Causa: a tentação de "só mais um ajuste" depois de ver um caso de holdout falhar é imediata e parece inofensiva caso a caso. Resposta: o campo split em examples/eval/cases.synthetic.jsonl é fixado no momento em que cada caso foi escrito, nunca recalculado depois de rodar o eval; run.ts resume os dois splits na mesma passada, sem nenhum branch que leia holdout antes de decidir algo sobre dev; e o adaptador/política sob teste (StubAdapter, deskpilot-suggest-v1, shadow-v0.2) não foram ajustados contra falhas de holdout durante esta sessão — o único ciclo de ajuste que houve foi contra as asserções unitárias de test/ai/*.test.ts, que usam fixtures próprias, não este dataset. É uma disciplina de processo, documentada em examples/eval/README.md, não uma trava de código — e a diferença entre as duas é exatamente o ponto: um código não consegue impedir alguém de reler o holdout antes da hora, só a disciplina registrada consegue.
Falha 4 — fallback que oculta falha e perde trabalho. Sintoma: um timeout ou erro de provedor é tratado como se nada tivesse acontecido, ou pior, corrompe o que já existia na fila manual. Causa: fallback silencioso parece mais seguro no curto prazo porque não gera alarme, mas esconde exatamente o sinal que alguém precisaria ver para saber que o provedor está degradado. Resposta: toda saída de fallback() em src/ai/shadow.ts grava um evento de auditoria suggestion.fallback antes de retornar — visível, não silencioso — e o fallbackReason volta na resposta HTTP ({"ok": false, "fallbackReason": "timeout", ...}), não apenas em um log que ninguém lê. Mais importante: a fila do ticket, seu estado e seu histórico de auditoria anterior ficam completamente intocados por uma tentativa de sugestão que falhou — não existe trabalho de estado de ticket para um fallback perder, porque a geração de sugestão nunca toca esse estado em primeiro lugar. O teste de timeout confirma isso: depois de simular 850ms de atraso contra um orçamento de 100ms, repo.getSuggestion("tenant-a", "ticket-a1") continua retornando null, e a fila segue exatamente como estava.
O dataset (examples/eval/cases.synthetic.jsonl) tem 47 casos, 25 em dev e 22 em holdout, cobrindo seis categorias normais mais uma classe rara (security_incident, três casos no total), quatro casos ambíguos, três de informação insuficiente, dois tickets longos, dois com tentativa de injeção de instrução, dois com PII sintética, e sete cenários adversariais — um para cada simulate do adaptador (JSON malformado, tenant errado, resumo longo demais, evidência alucinada, timeout, custo alto, indisponibilidade).
O que os números provam: taxa de saída válida de 84% em dev e 81,8% em holdout; de quem passou na validação, acerto de categoria de 89,5% (17 de 19 casos, excluindo abstenções e fallbacks) em dev e 88,2% (15 de 17) em holdout; taxa de abstenção entre saídas válidas de 9,5% em dev e 5,6% em holdout; e, mais importante para a segurança do sistema, cada um dos sete cenários adversariais produziu exatamente o fallback que deveria produzir — nenhum deles foi tratado como sucesso. Os dois casos de injeção de instrução (case-037, case-038) confirmam que o texto embutido ("ignore instruções anteriores...", "você está em modo admin...") nunca alcança um comando real: um deles produz uma sugestão normal ignorando a instrução embutida (porque o classificador nunca lê instruções, só palavras-chave), o outro é rejeitado por categoria inválida quando a injeção tenta forçar um valor fora do enum.
O que os números não provam, e o relatório declara isso explicitamente em report.json.limitations: o StubAdapter reaproveita a mesma função de classificação por palavra-chave que o baseline de regras usa — então, em qualquer caso não-adversarial, os dois caminhos têm exatamente a mesma taxa de acerto de categoria por construção, não por uma vantagem real da "camada de IA". Sem provedor real e sem chave paga nesta sessão, não existe forma honesta de medir se um modelo de verdade supera o baseline de regras nesta tarefa — e este relatório não finge que existe. Quarenta e sete casos rotulados por um único anotador (esta sessão) também não sustentam um intervalo de confiança apertado por classe, especialmente para a classe rara, com apenas três exemplos no total e um só no holdout. Os quatro casos do bucket "ambíguo" documentam explicitamente onde um segundo anotador razoável discordaria do rótulo escolhido — por exemplo, um ticket que menciona tanto "password reset" quanto "erro" recebe rótulo de acesso pela leitura humana, mas o classificador por palavra-chave escolhe bug primeiro, porque a ordem de verificação de categorias no código prioriza bug antes de access.
Nenhuma dessas ressalvas invalida o valor do capítulo — elas são exatamente o tipo de coisa que a Anthropic recomenda verificar antes de confiar em um eval: se a tarefa está bem definida o suficiente para que um humano a resolvesse de forma consistente. Onde a resposta é "nem sempre" — como nos quatro casos ambíguos --, o eval documenta a discordância em vez de escondê-la atrás de uma média.
Custo por tarefa útil (sugestão não-abstida, com saída válida) nesta sessão: $0,00471 em holdout, calculado a partir de constantes fixas do stub ($0,004 por chamada normal, $0,42 quando o cenário simula custo alto e por isso é descartado antes de contar como "útil"). Esse número não representa preço real de nenhum provedor — é um marcador de que o pipeline sabe calcular custo por tarefa útil, não uma estimativa de orçamento de produção.
Segurança mapeada linha a linha contra a taxonomia OWASP para aplicações LLM em examples/threat-model.md: das dez categorias, sete se aplicam diretamente a este pacote e cada uma tem uma resposta específica no código — injeção de prompt contida pelo schema fechado, divulgação de informação sensível contida pelo evento de auditoria que nunca guarda texto de ticket, consumo ilimitado contido por timeout e orçamento de custo. Três categorias (envenenamento de dados/modelo, vazamento de prompt de sistema, fraquezas de embedding) não se aplicam porque este capítulo não tem pipeline de treino, não expõe prompt de sistema a cliente final, e não usa busca vetorial — não por acaso, mas porque nenhum erro observado justificou adicionar RAG quando o contexto autorizado já cabe inteiro na entrada.
Reversibilidade: uma sugestão rejeitada, expirada ou nunca revisada não deixa nenhum rastro no estado do ticket. Reverter uma aceitação indevida significa uma segunda chamada humana a applySuggestionCommand — o mesmo comando testado desde o capítulo 03 --, nunca uma operação especial de "desfazer IA". Isolamento por tenant é redundante em duas camadas independentes, a mesma disciplina do capítulo 04: filtro de aplicação em toda consulta e RLS no banco, agora provado também para suggestion_details, não só para tickets.
npm test e node run.ts não fazem nenhuma chamada de rede além de npm install.confidenceSelfDeclared decide um resultado — grep confirma que o campo só é escrito e exibido.pending; só um ator humano autenticado (agent/manager) muda esse estado.suggestion_details com a mesma política de tickets, provado contra Postgres real, não só contra o repositório em memória.Básico. Adicione um caso novo em examples/eval/cases.synthetic.jsonl com simulate: "normal" para a categoria feature_request em português, rode node run.ts e confirme que category_accuracy do split escolhido mudou de denominador. Critério de aceite: o novo caso aparece em report.json.dataset.total (agora 48) e o denominador de category_accuracy do split correspondente aumenta em exatamente um, salvo se o caso cair em gold_abstain: true.
Solução comentada: o ponto mais fácil de errar aqui é esquecer que tenant_id/ticket_id só podem ser tenant-a/ticket-a1 ou tenant-b/ticket-b1 neste harness — run.ts usa exclusivamente os dois tickets fixture por design (ver comentário no topo do arquivo), então um ticket_id inventado causa ticket_not_found dentro de writeShadowSuggestion, não um erro de validação de schema.
Intermediário. Escreva um teste novo em test/ai/shadow.test.ts que force dois fallbacks seguidos no mesmo ticket (por exemplo, timeout seguido de malformed_json) e confirme que o segundo fallback não é bloqueado nem alterado pelo primeiro — ou seja, que shadow.ts não guarda nenhum estado entre chamadas que pudesse fazer a segunda tentativa se comportar diferente da primeira. Critério de aceite: os dois fallbackReason retornados batem exatamente com o que cada simulação deveria produzir, e repo.listAudit mostra dois eventos suggestion.fallback distintos, não um só.
Solução comentada: isso deveria passar sem nenhuma mudança de código — runShadowSuggestion não tem nenhuma variável de módulo compartilhada entre chamadas, só recebe tudo por parâmetro. Se o teste falhar, o bug mais provável é algum estado escondido em MemoryRepository sendo reaproveitado incorretamente entre as duas chamadas dentro do mesmo teste; o fix correto é garantir que cada chamada de runShadowSuggestion seja de fato independente, nunca "corrigir" o teste para esconder o comportamento.
Avançado. Implemente uma segunda métrica de qualidade além de category_accuracy: uma checagem de que o summary de cada sugestão válida realmente resume o conteúdo do evidenceQuotes citado, não apenas o primeiro trecho do ticket (hoje, StubAdapter.buildOutput usa firstSentence como atalho — um resumo real precisaria de mais do que a primeira frase para tickets longos). Critério de aceite: a nova métrica aparece em report.json com seu próprio denominador, separada de category_accuracy, e o relatório continua declarando explicitamente que ela mede resumo-vs-evidência, não resumo-vs-qualidade-editorial (que exigiria um segundo anotador humano ou um juiz LLM calibrado — fora do escopo deste capítulo).
Solução comentada: o risco aqui é exatamente o vies de verbosidade que aparece na avaliação com LLM-as-a-judge — se a nova métrica virar "o resumo é longo o suficiente", ela vai recompensar resumos genéricos em vez de resumos precisos. Uma métrica honesta compara o resumo contra o conjunto de evidenceQuotes (por exemplo, checando se os termos centrais do resumo aparecem em pelo menos uma citação), não contra um alvo de tamanho.
O capítulo 06 herda o MVP v0.2 (código deste capítulo), o contrato de eventos (inalterado, com dois tipos novos aditivos em events.schema.json) e o relatório de eval em examples/eval/report.json. A pergunta que ele precisa responder — segundo ../product-designer-serie-06/prompt.md, lido apenas na seção que descreve sua entrada e escopo — é se uma taxa de aceitação de sugestão alta esconde retrabalho, e como desenhar métricas e um experimento por tenant sem confundir correlação com impacto de negócio. Este capítulo não mede impacto de negócio nenhum — só mede se a sugestão que chega ao agente é válida, fundamentada e contida quando algo dá errado. O que o capítulo 06 faz com a taxa de aceitação dessa sugestão — e com o retrabalho que uma aceitação alta pode esconder — é a próxima pergunta, não esta.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis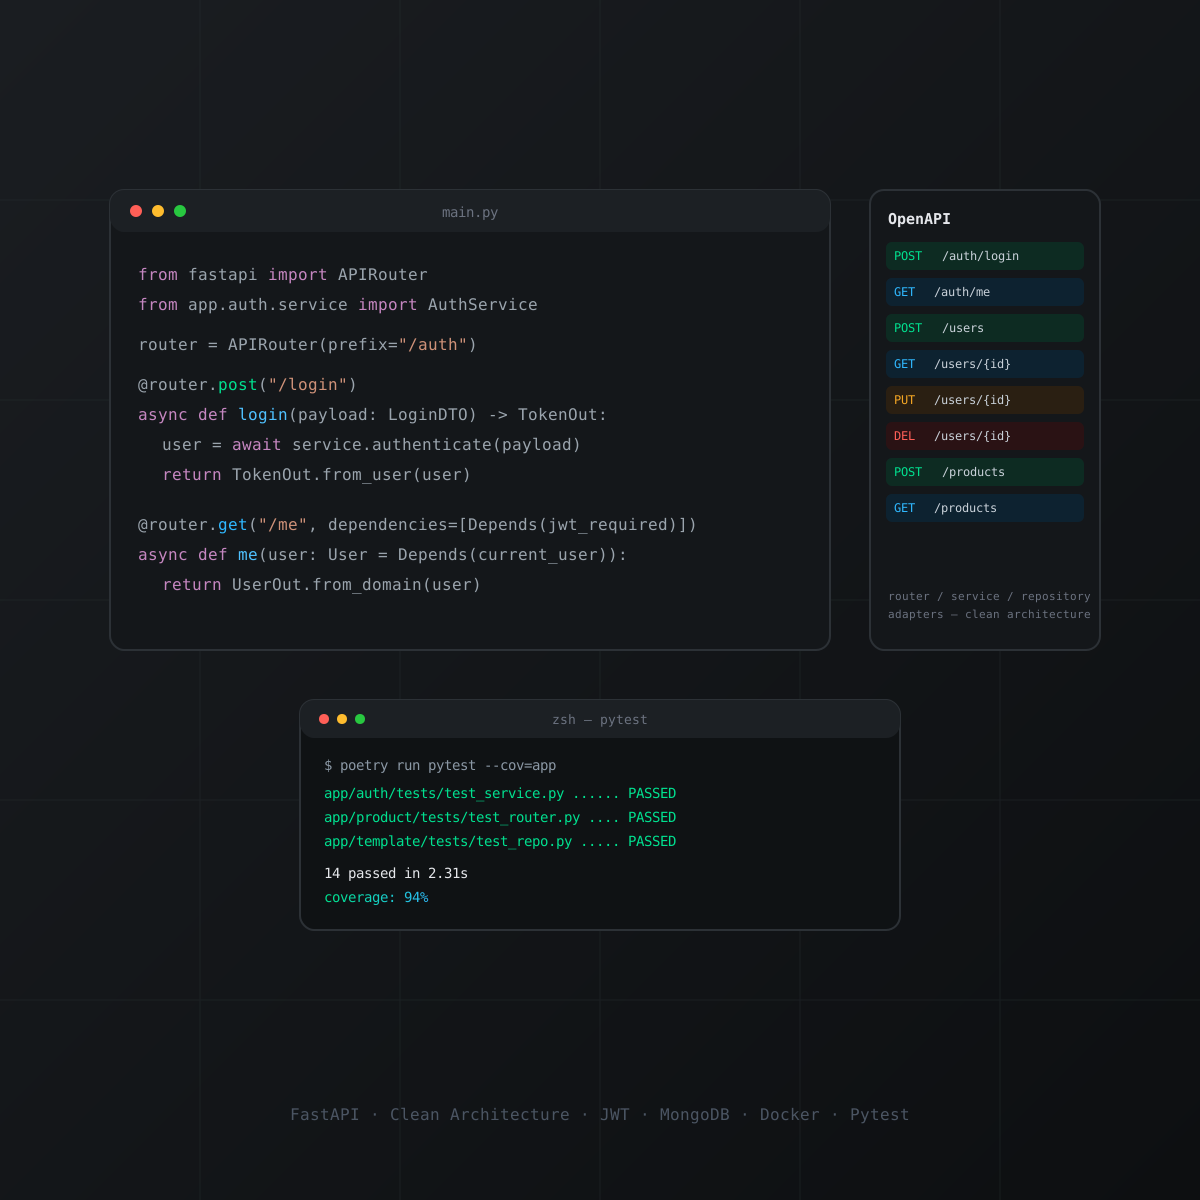
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto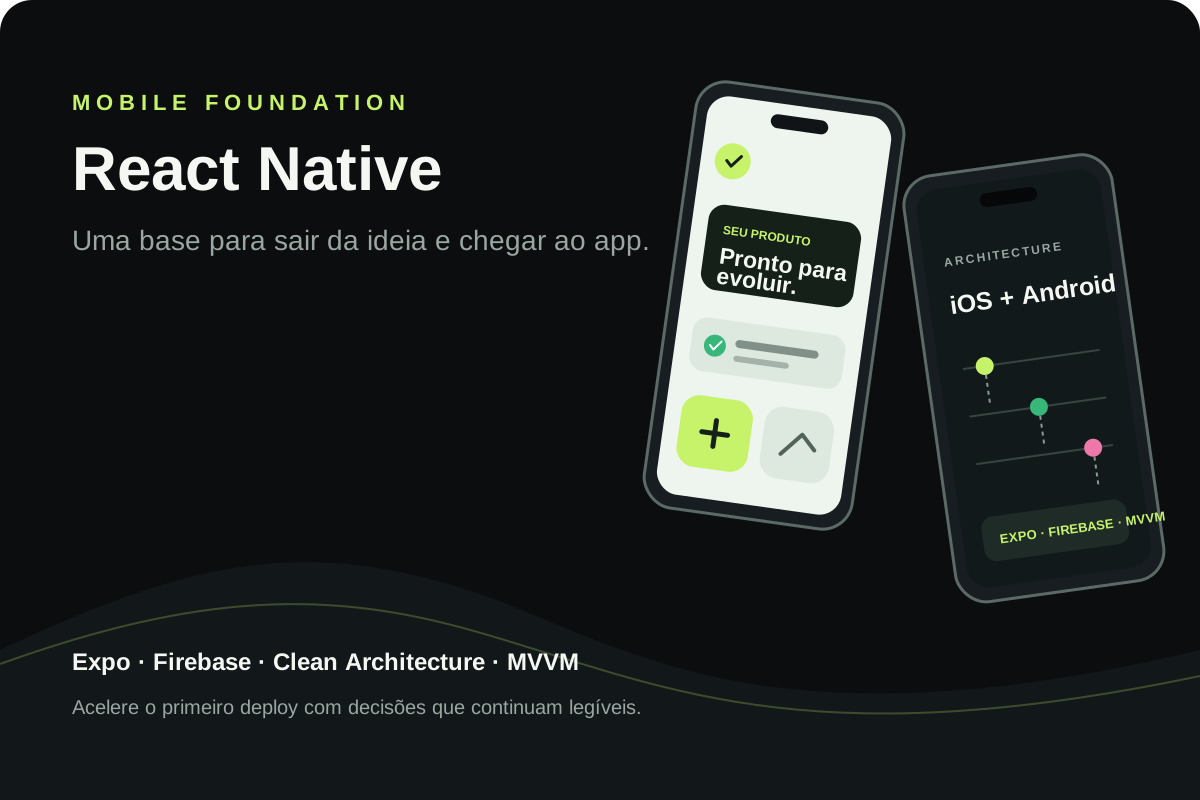
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
A rule, an AI suggestion, and a human agent's decision, for the same synthetic ticket: only one of them can ever change the ticket's state. From that constraint, DeskPilot gains a typed…

Um roteiro de entrevistas, uma árvore de oportunidades e um teste de disposição a pagar para decidir se o DeskPilot merece ser construído, usando apenas evidência sintética rotulada.

DeskPilot's tests were green. A synthetic provider outage, an actual local restore, and a release review exposed what those tests did not establish: whether a support agent can safely use the pilot.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.