
Anderson LimaSoftware Engineer & Architect
16 de outubro de 2026
7 min de leitura
0 visualizações
O que faltava nos CLIs de IA que eu já usava, e as decisões que nasceram desse incômodo

English summary: Why I built lemon-code, a terminal coding agent in Bun, TypeScript and Ink: fragmented context across AI CLIs, routing nobody could explain, and no audit trail I could trust.
Publicado: 19 de outubro de 2026
Tempo de leitura: 8 min
Série: lemon-code em 30 dias, parte 1 de 13
Em março de 2026 eu tinha quatro CLIs de agente instalados no Mac: Claude Code, Codex, Gemini CLI e OpenCode. Todos bons. Nenhum sabia o que os outros tinham feito na mesma pasta dez minutos antes.
Eu copiava contexto de um terminal para outro, colava o resumo de uma sessão como prompt da próxima e decidia de cabeça qual ferramenta usar em cada tarefa. Quando algo dava errado, não havia registro do motivo.
No dia 7 de março fiz o primeiro commit do lemon-code, um agente de código no terminal escrito em Bun, TypeScript e Ink. Sete meses e mais de 440 commits depois, ele é a ferramenta que eu uso todo dia. Esta série conta as decisões técnicas por trás dele, incluindo as que eu errei.
Pense numa orquestra em que cada músico toca bem, mas ninguém tem a partitura dos outros e não existe maestro. O som de cada um é bom; o conjunto não. O lemon-code nasceu para ser o maestro: ele não toca no lugar dos CLIs, ele decide quem entra, quando, e anota o que cada um tocou.
Antes da arquitetura, o núcleo. Um agente de código é um loop: o modelo propõe uma ação, o harness decide se ela pode rodar, executa e devolve o resultado.
// loop mínimo de agente (ilustrativo, sem dependências)
type Step = { tool: string; args: unknown } | { done: string };

interface Model { next(history: string[]): Promise<Step> }
interface Tools {
  approve(step: Step): Promise<boolean>;
  exec(step: Step): Promise<string>;
}

export async function run(task: string, model: Model, tools: Tools) {
  const history = [task];
  for (let turn = 0; turn < 20; turn++) {
    const step = await model.next(history);
    if ("done" in step) return step.done;
    const ok = await tools.approve(step); // humano no circuito
    history.push(ok ? await tools.exec(step) : "negado pelo usuário");
  }
  throw new Error("limite de turnos atingido");
}
Cada CLI que eu usava implementa uma variação desse loop. A diferença está em tudo que fica ao redor dele: qual modelo responde, que contexto entra, quem aprova, o que fica registrado. Era essa parte que eu queria controlar.
Cada ferramenta guardava sessão e memória do seu jeito. Trocar de CLI no meio de uma tarefa significava perder o fio. O documento de produto do lemon-code descreve assim: ferramentas desconectadas geram contexto fragmentado, auditoria fraca e custo alto de troca.
Algumas tarefas pedem o modelo mais forte disponível. Outras são uma busca de arquivo que qualquer modelo pequeno resolve. Eu escolhia na mão, sem critério estável. Quando uma ferramenta escolhia por mim, eu não sabia por quê.
Todo CLI pede confirmação antes de escrever arquivo ou rodar comando. A aprovação some quando a sessão fecha. Eu queria poder responder depois quem aprovou aquela escrita, em qual modo de permissão e com qual modelo.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis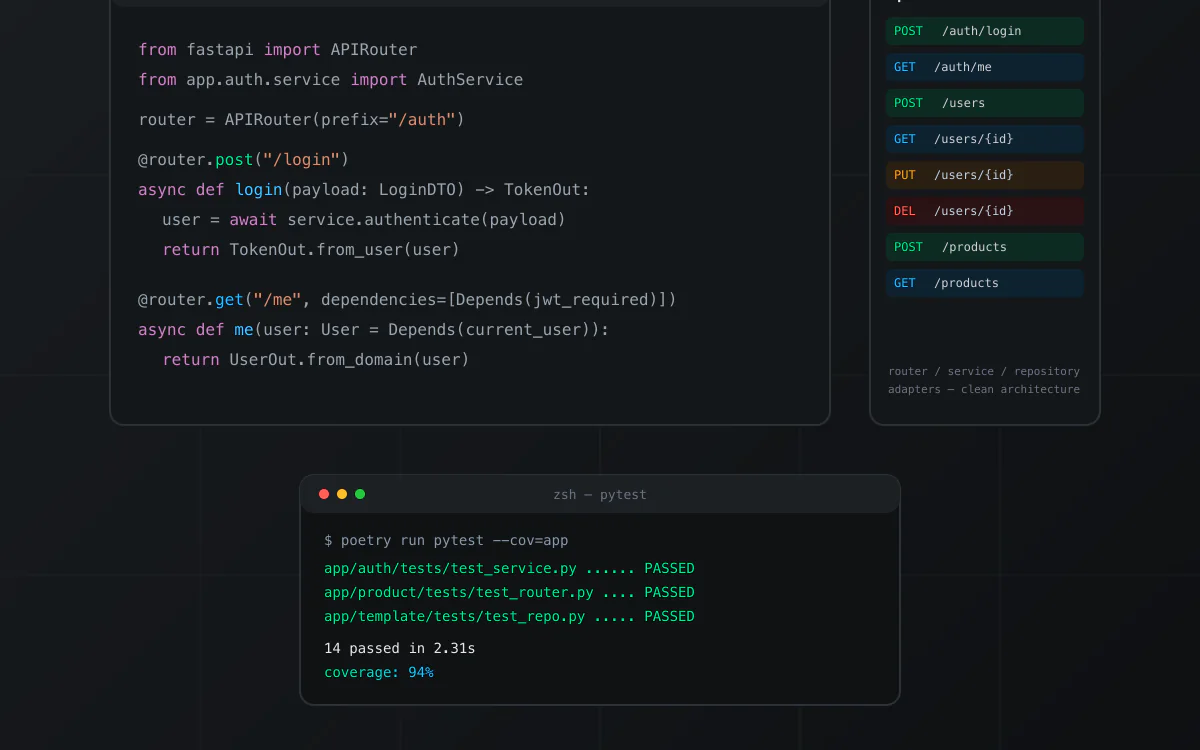
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto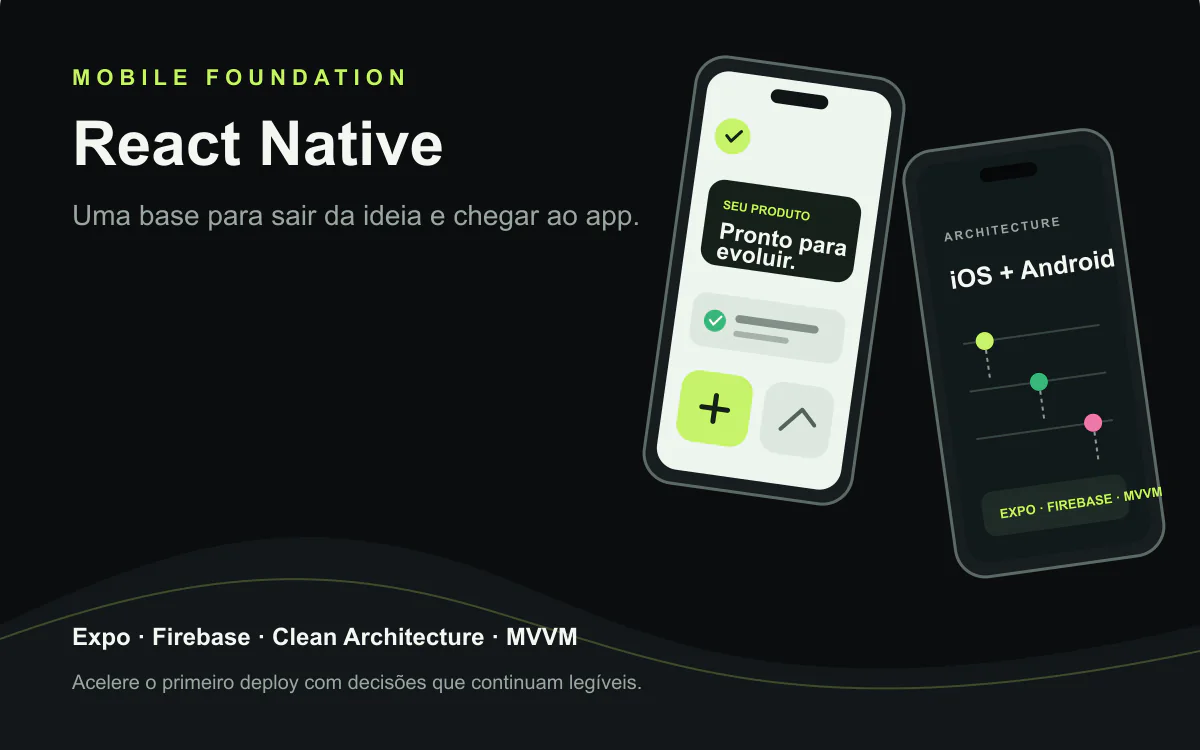
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto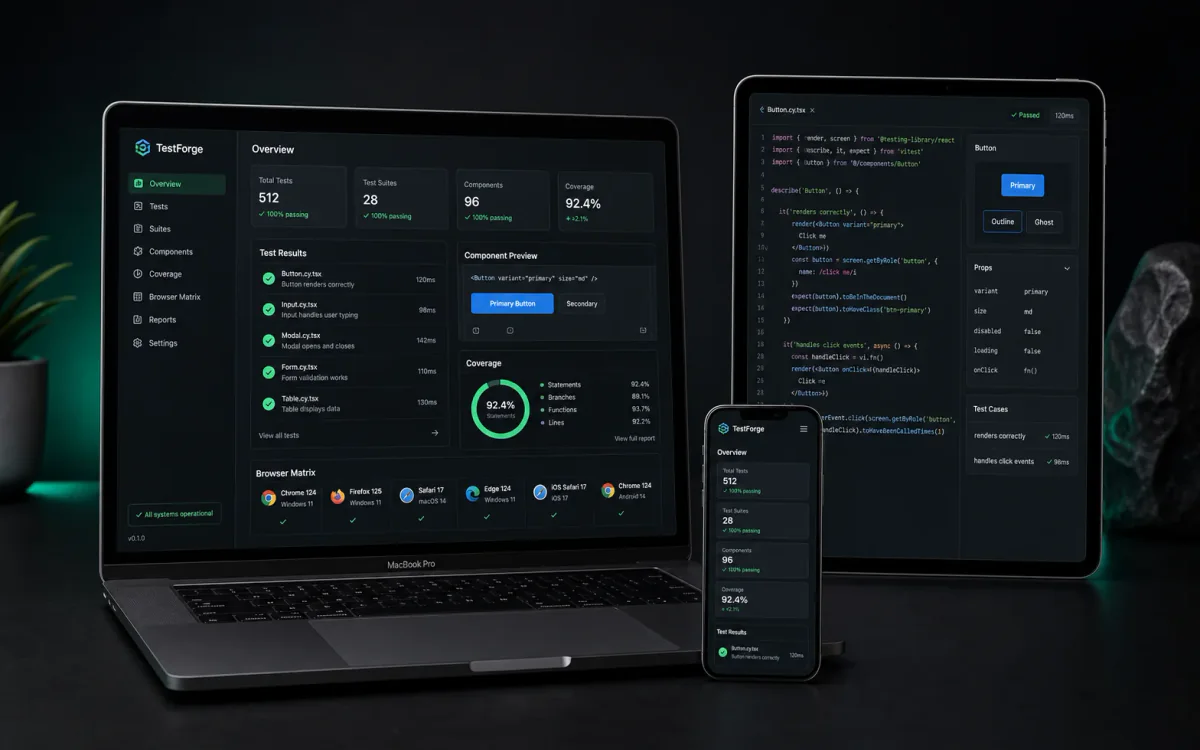
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto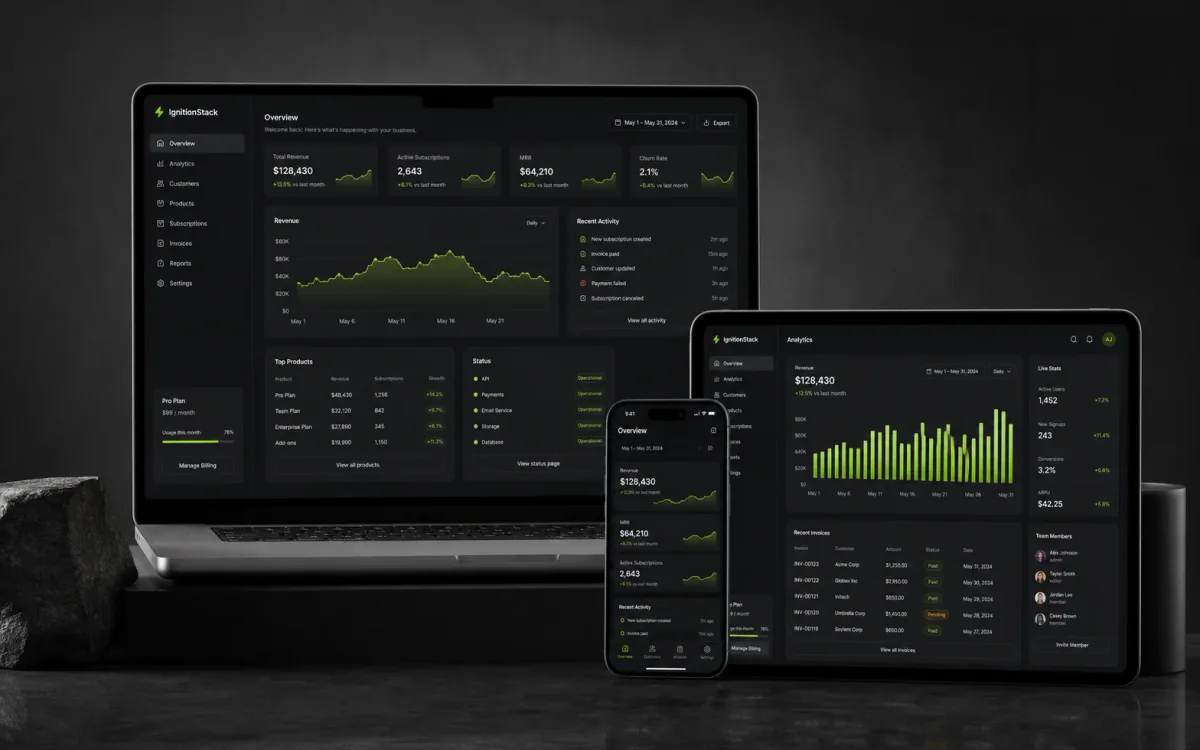
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Eu pagava API para tarefas que o Claude Code ou o Codex, já logados na minha máquina, resolveriam. A regra CLI-first do lemon-code cabe em quatro linhas de precedência.

Meu agente escolhia o modelo e eu não sabia por quê. Hoje cada escolha vem com uma linha como 'anthropic score 71.5 (risk +20, order +50)'. Este post mostra como chegar nisso.

O lemon-code tem seis ADRs com o número 0049, todas criadas no mesmo dia. Esse erro ensina mais sobre memória de projeto com vários agentes do que qualquer ADR bem numerada.
Checklist prático para validar segurança, custos, avaliações e observabilidade antes de colocar seu app com IA em produção.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
Escrever os não-objetivos ajudou mais do que listar features. O PRD do projeto define dois limites:
No código atual, isso vale para o score base de providers HTTP, calculado localmente. Há também uma etapa JEV separada: sem chave do gateway, usa o client local disponível (Laya ou BuiltinOne); com uma chave, pode avaliar candidatos via Vercel Gateway. Em shadow, a avaliação não muda a rota; em advisory ou enforce, uma decisão aceita pode mudar o destino. Essa camada configurável não cabe na afirmação de que todo dispatch é local e determinístico.
| Princípio | Na prática |
|---|---|
| Local primeiro | CLI-first automático para runtimes elegíveis; API HTTP quando explícita, com CLI-first desligado ou sem runtime elegível; estado em SQLite local |
| Roteamento explicável | Scores base de providers HTTP têm parcelas registradas; JEV e runtimes CLI seguem caminhos próprios |
| Humano no circuito | Escrita e comandos sensíveis passam por aprovação, com modos de permissão visíveis |
Cada um vira um post da série. O próximo, sobre preferir os CLIs elegíveis antes dos providers HTTP, sai na quarta.
Em paralelo ao dispatch, o lemon-model é um laboratório em andamento para classificação local, um nano transformer próprio e avaliação de bases abertas com MLX. Os smokes de treinamento validam o pipeline, não a qualidade de um modelo de código.
O app nativo macOS não reimplementa nada. Ele conversa com o CLI por um contrato JSON-RPC versionado, assunto de um post mais adiante.
A escolha foi pragmática. Escrevo React há anos, então construir a interface do terminal com componentes React via Ink tirou atrito do primeiro dia. O Bun roda TypeScript direto, sem etapa de build no desenvolvimento, e traz test runner e SQLite embutidos.
O primeiro atrito apareceu cedo: o Ink não roda limpo sob Bun no macOS ARM64 sem alguns ajustes. Esse é o tema do post 3.
Depois de alguns meses de uso diário, fiz três perguntas:
Se você usa mais de um CLI de IA e respondeu "não" para alguma delas, o meu problema provavelmente é seu também. Construir um agente inteiro é só uma das respostas. Às vezes um script que padroniza contexto entre ferramentas já resolve boa parte.
Com três ou mais marcados, vale ao menos padronizar sessão e registro de decisões.
Construí o lemon-code porque os CLIs que uso são bons demais para continuar usando cada um isolado. Faltava a camada que junta contexto, escolhe o modelo com critério visível e guarda o que foi aprovado.
Nos próximos 30 dias vou abrir as decisões dessa camada, uma por post. O código continua fechado. As ideias e os trade-offs ficam aqui.
Se o seu time está tentando encaixar agentes de código num fluxo com aprovação e auditoria, esse é o tipo de trabalho de arquitetura que faço na LEMON.DEV.