

Anderson LimaSoftware Engineer & Architect
1 de outubro de 2026
18 min de leitura
14 visualizações
O case DeskPilot mostra como contar o que foi construído sem vender testes sintéticos como impacto em cliente

Uma pessoa candidata abre o portfólio e diz: “Construí autenticação, multi-tenancy, PostgreSQL, IA, analytics, outbox e dashboard.” Outra abre o mesmo projeto e diz: “A IA ficou em modo sombra porque a regra de tenant não podia depender dela. O teste local mostrou fallback, mas a interface não avisava o agente; por isso não convidamos usuários.” As duas trabalharam no mesmo DeskPilot. Só a segunda deixou uma decisão que alguém pode verificar e contestar.
Esse é o último capítulo da série Product Engineer AI-native. O DeskPilot é um produto didático de triagem assistida de suporte B2B, com usuário agente, comprador gestor e cliente final afetado. Ele tem código e testes reproduzíveis. Não tem piloto executado, cliente, receita ou product-market fit (PMF). O portfólio honesto começa por essa diferença, não a esconde no rodapé.
Leitura rápida: o case reúne problema, alternativa, decisão, artefato, teste e limite. O índice de evidências separa construído, medido localmente, validado com usuário e planejado. Um checker rejeita claims sem path ou denominador e não aceita que ganho de clientes reais seja rotulado como medição sintética. O próximo passo é fechar os gates do piloto e obter feedback autorizado, ou simplificar a hipótese de IA.
Antes de mostrar arquitetura, escreva um claim que sobreviva a uma pergunta simples: “Como você sabe?” Para o DeskPilot, “a suíte offline passou 76 de 76 testes no ambiente local registrado” tem estado, denominador e registro de execução. “Clientes ficaram mais produtivos” não tem participante, baseline, janela, medição ou autorização. Não é uma versão mais ousada da mesma frase. É outra afirmação, sem evidência.
O arquivo examples/claims.json torna essa distinção explícita. Cada item declara evidenceClass (built, local_measurement, external_outcome ou planned) e aponta para paths. Uma medição local também precisa de denominator e window. Um resultado externo precisaria de URL HTTPS e data de verificação; ninguém inseriu um resultado desse tipo nesta série. O checker valida a forma e a existência de arquivos. Ele não autentica uma fonte externa, nem prova que o texto de um relatório é verdadeiro — revisão humana ainda é necessária.
node examples/check-portfolio.mjs  # PASS: 7 claims com evidência estruturada
node examples/check-portfolio.mjs examples/claims.invalid.json  # FAIL esperado: claim de cliente real rotulado como medição local
A segunda entrada é uma fixture inválida criada para o teste do checker, não um cliente que existiu. Seu valor pedagógico é mostrar que o portfólio pode falhar de modo verificável. O artefato não substitui uma conversa; obriga a conversa a começar na alegação correta.
A lista comprime trabalho em nomes de tecnologia. Ela pode servir como índice, mas não como prova de impacto. “Outbox” não diz se houve duplicação, como se recupera uma dead letter, quem autoriza reprocessamento ou se o consumidor deduplica. “Dashboard” não diz quem age quando um sinal degrada. “IA” não diz se a sugestão é usada, se o agente consegue contestá-la ou se ela piora reabertura.
No capítulo 07, o DeskPilot passou por um drill local de restore. O primeiro pg_restore recuperou tabelas, mas falhou em nove grants porque o papel deskpilot_app não existia no cluster novo. Um screenshot do banco restaurado como superusuário teria produzido um case mais bonito e mais fraco. A equipe alterou o procedimento: restaurar, migrar para recriar papel/grants, ler ticket e auditoria como papel da aplicação sob RLS. Isso demonstra recuperação da fixture local naquele ambiente, não uma política de backup de produção. A diferença entre os dois relatos mostra uma competência mais útil que “sei PostgreSQL”: recusar evidência que testa o ator errado.
O case completo tem cinco peças por decisão: problema, alternativa considerada, escolha, teste e limite. Sua cronologia aponta para os handoffs PE01–PE07. Se um recrutador ou colega perguntar “qual feature teve mais uso?”, a resposta correta é “não houve uso real”; o case mostra o experimento necessário para obter essa resposta depois. Não transformar ausência de prova em uma métrica imaginária é parte da capacidade profissional demonstrada aqui.
Construído significa que um artefato existe e sua função pode ser examinada. O snapshot v0.3 tem regras de domínio, interface simples, sugestão tipada em modo sombra, métricas e operação. Um arquivo não garante que o fluxo foi usado por alguém.
Medido localmente acrescenta ambiente, método, janela e denominador. O npm test do PE07 terminou com 76/76; o capítulo registra 16/16 testes de fluxo PostgreSQL e um restore em container efêmero. O PE06 calculou 81,8% de aceite e 63,6% de fechamento limpo sobre fixture sintética, com recortes no relatório. Nenhum desses números descreve clientes ou sustenta causalidade.
Validado com usuário exigiria agente de suporte ou gestor real, autorização, tarefa observada, feedback e critério de sucesso antes de ver o resultado. A série não tem esse estado. Nem mesmo uma demo apresentada a um colega cria automaticamente “validação com cliente”.
Planejado é um protocolo com responsável, convite, finalidade dos dados, canal de feedback e condição de parada. O protocolo do PE07 começa com “piloto não executado”. Um plano pode ser executável e ainda não ser um relatório. Esses quatro estados evitam que a narrativa salte de “o teste passa” para “o mercado quer”.
O índice de portfólio permite percorrer os oito capítulos sem depender da memória do chat. PE01 definiu brief e autonomia; PE02 desenhou discovery; PE03 fixou tenant, papéis e estados; PE04 montou o fluxo manual; PE05 adicionou sugestão tipada e eval sintético; PE06 separou métricas de aceite e fechamento; PE07 tratou operação e piloto; este PE08 torna o percurso legível como case e próximo plano. Os links são evidência de artefato, não uma sequência de vitórias comerciais.
A primeira decisão relevante foi não permitir que o modelo execute comandos. Um modelo pode sugerir categoria e resumo, mas tenant, SLA, autorização, estado e atribuição ficam em regras determinísticas. Um humano revisa. O backend valida o comando. Essa restrição foi mantida quando o produto ganhou mais módulos, porque a ausência de automação de envio ao cliente é uma escolha de risco, não atraso a desculpar.
A segunda foi não aceitar o número mais bonito como outcome. A fixture do PE06 produziu aceite de sugestão superior ao fechamento limpo. O resultado levantou uma hipótese de métrica enganosa; não demonstrou que a IA causou benefício ou dano. A resposta foi desenhar guardrail de reabertura e experimento por tenant, sem calcular p-value para um tenant por braço. Um portfólio maduro guarda o denominador junto ao slide, mesmo quando ele enfraquece a manchete.
A terceira foi restringir a automação diante de falha. O PE07 injeta indisponibilidade do provedor; após cinco fallbacks consecutivos, a sexta chamada de sugestão é suspensa para o tenant. O fluxo de tickets continua manual. O backend sinaliza fallback, mas a interface ainda não mostra sugestão nem degradação ao agente. Dizer “fallback operável para usuário” seria incorreto. O gate de UX continua bloqueado, junto com teto faturado do provedor, operação de dados e consentimento. A matriz go/no-go diz não convidar usuários reais agora.
Há uma decisão de não construir e uma de retirar poder de automação aqui: não criar resposta automática ao cliente; suspender sugestão quando a dependência externa degrada, com reset manual por papel autorizado. Uma feature list poderia esconder ambas por não terem screenshot novo. No case, elas carregam o argumento: Product Engineering inclui preservar um caminho seguro e admitir quando ele não é suficientemente compreensível na UI.
Sintoma: “entreguei oito capítulos e uma plataforma AI-native; portanto aumentei produtividade”. O antecedente é verificável como output; a conclusão exige tempo de tarefa, retrabalho, qualidade, custo, baseline e participantes. A transição lógica está ausente.
Causa: confundir capacidade de construir com efeito do produto. A lista de tecnologias pode impressionar, mas não força o autor a definir usuário, tarefa nem resultado. Em entrevista, ela ainda convida perguntas impossíveis de responder: “quanto economizou?”, “quantos clientes usam?”, “qual retenção?”
Resposta: usar a frase de cinco peças. “Propusemos reduzir retrabalho de triagem; escolhemos sugestão revisável em vez de automação; testamos isolamento e fallback localmente; encontramos UI e custo ainda bloqueados; o próximo experimento exige agentes reais com opt-in.” O case continua forte porque a decisão é inspecionável. Nunca substitua “impacto não medido” por “impacto positivo” só para preencher uma linha do currículo.
Sintoma: “clientes aceitaram 81,8% das sugestões”. O PE06 tem esse percentual em fixture sintética, não clientes. Uma palavra trocada muda a classe da evidência. Uma demo com colegas ou dados fabricados pode verificar apresentação e parser; não valida demanda ou utilidade no turno de suporte.
Causa: falta de rótulo no número e pressão para mostrar tração. A solução não é esconder toda medição. É preservar denominador, população e contexto no ponto da afirmação. Se o percentual vem de 14 tickets de fixture, diga isso. Se o dado falta, escreva “não medido” e desenhe o protocolo que permitiria medi-lo.
Resposta: registrar claims em claims.json, manter external_outcome vazio até existir fonte verificável e testar a fixture inválida. O checker rejeita “clientes reais ficaram 30% mais produtivos” sob local_measurement, inclusive pela falta de denominador/janela. Ele pode ser enganado por um arquivo falso; por isso revisão humana, autorização e proveniência continuam parte do gate. Essa limitação deve estar no próprio portfólio, não escondida na implementação do checker.
Sintoma: o profissional mostra um catálogo de prompts e versões de modelos como se a quantidade provasse capacidade de produto. Prompts podem acelerar escrita ou código; não definem qual ticket deve ser priorizado, qual risco merece um no-go, quem atende incidente ou se comprador aceita custo.
Causa: ferramentas geram output visível mais rápido que discovery, negociação e operação. A página da PostHog sobre product engineers descreve como aquela empresa espera participação em suporte, roadmap e experiência. É uma prática declarada de uma empresa, não uma norma universal nem uma promessa de carreira. O DORA 2025 descreve IA como amplificadora das forças e fraquezas de um sistema organizacional; a página de resumo não autoriza inferir que uma pessoa com mais prompts terá salário ou produtividade maior.
Resposta: mostrar o que o prompt não decide. No DeskPilot, um teste de RLS, o restore como papel de aplicação e a matriz no-go são mais informativos que o texto que gerou o primeiro rascunho. Saber usar IA continua útil; a competência demonstrada é pedir evidência, corrigir desvio e assumir o limite do sistema que a ferramenta ajudou a construir.
Sintoma: “Product Engineer faz PM, design, suporte, segurança, jurídico e engenharia.” A frase pode soar autônoma, mas transforma colaboração em carga ilimitada e dilui quem decide valor, usabilidade, operação de dados e orçamento. Um indivíduo sem acesso a usuários ou poder de decisão não resolve essa lacuna por esforço pessoal.
Causa: confundir responsabilidade por entender o produto com autoridade sobre todo o produto. O SVPG contrasta equipes focadas em output com equipes orientadas a problemas e outcomes. É um framework autoral; nele PM, design e engenharia colaboram e enfrentam riscos diferentes. Seu uso aqui é lembrar que engenharia precisa participar da decisão, não substituir especialistas por padrão.
Resposta: negociar interfaces de trabalho. PM abre a pergunta de valor, priorização e acesso a participantes. Design conduz observação de uso e linguagem da UI. Engenharia responde por factibilidade, instrumentação, testes e reversão. Suporte ensaia incidente; segurança/legal revisam dados e finalidade; liderança define teto e responsável pelo risco. Em equipe pequena, pessoas podem acumular funções, mas o acordo deve nomear tempo, decisão, revisão e limite. Autonomia significa poder propor e interromper com evidência, não ser dono solitário de tudo.
A matriz CSV enumera dez áreas: discovery, domínio, UX, engenharia, IA/eval, analytics, economia, operação, comunicação e influência. Cada linha descreve comportamento inicial, comportamento em prática, evidência do DeskPilot e lacuna que pede feedback. Ela não atribui nota de 0 a 10 à pessoa. Um número único sugeriria precisão que a série não tem.
Observe a linha de UX: o artefato existe, mas a tela não renderiza a sugestão. A célula de evidência não deve dizer “domínio de UX”; deve indicar o gate bloqueado e a revisão com design/agente ainda necessária. A linha de operação registra restore local e runbook, ao lado de alertas duráveis e operador real pendentes. Essa forma permite que uma pessoa em início de carreira mostre aprendizado real sem alegar senioridade por decreto.
O comportamento também muda com contexto. Júnior pode formular uma hipótese e testar um caso com mentoria; pleno/sênior pode fechar um gate de ponta a ponta e negociar suporte; staff pode desenhar guardas reutilizáveis sem virar aprovação central; consultoria precisa separar comprador, operador e cliente final e obter acordo de dados antes de testar. A mesma evidência do DeskPilot não vale da mesma forma para todas as vagas. Mostre quem tomou qual decisão, não apenas que a tarefa apareceu no repositório.
Nos primeiros 30 dias, audite o case: para cada afirmação, há path? A medição tem denominador, janela e ambiente? O trabalho de discovery tem pessoa real autorizada ou somente roteiro? Peça a PM crítica da hipótese de valor, a design crítica da tarefa e a suporte exceções do fluxo. A entrega observável é um problema formulado com alternativas e um registro honesto do acesso disponível. Sem acesso, a entrega é protocolo pendente, não entrevista inventada.
Nos 31–60 dias, feche gates técnicos necessários ao piloto: custo faturado e reconciliação, operação de dados reais, UI de revisão e consentimento. A responsabilidade não cabe em um nome só. Engenharia mede e corrige; segurança revisa threat model; design testa compreensão; suporte executa runbook. Se qualquer gate falhar, a saída é pausa com dono e próxima verificação. O marco não é “lançar porque o calendário chegou ao dia 60”.
Nos 61–90 dias, somente com gates fechados e autorização, PM recruta participantes opt-in; engenharia e design observam o fluxo; suporte recebe reclamações; a equipe compara com o baseline manual e usa critérios de parada. Se isso não puder ocorrer, registre “piloto não executado” e escolha outra evidência obtível. A versão detalhada do plano inclui quatro contextos de carreira e quem dá feedback em cada janela. Nenhum prazo promete promoção ou contratação.
O case DeskPilot ensina a mudar o desenho conforme usuário e risco. Em produto interno, o agente interno quer menos retrabalho e pode tolerar sugestão revisável com fallback manual, mas dados e processo ainda têm dono. Em growth, clique ou aceite é proxy perigoso: o outcome é ativação útil com guardrail de retenção, e automação de mensagem não consentida não entra por atalho. Numa plataforma para devs, o usuário é o integrador; contrato estável, idempotência e limites de custo importam mais que uma demo de UI. No B2B regulado, rastreabilidade, permissão e revisão de finalidade podem exigir ainda menos autonomia da IA e mais evidência operacional.
Cada variação muda usuário, outcome, risco e grau de automação. Se agentes não quiserem a sugestão ou o custo superar o valor, a próxima iteração pode ser triagem manual melhor instrumentada, regras determinísticas ou abandono da hipótese de IA. “Hero” profissional, se o termo for útil, é quem aprende e opera com responsabilidade, inclusive quando a resposta é parar. Lucro e PMF continuam perguntas externas à série.
Um case bom deixa claro o que o próximo experimento poderia refutar. Antes de convidar agentes, a equipe precisaria observar o caminho manual, estimar volume e frequência da tarefa e combinar com o gestor quais tickets podem entrar no piloto. Isso estabelece uma linha de base sem IA. A hipótese pode então ser escrita de forma contestável: com sugestão revisável, agentes concluem a triagem com menos retrabalho, sem aumentar reabertura, exposição de dados ou custo por tarefa útil. “Menos retrabalho” precisa virar evento e janela; “qualidade” precisa de revisão de casos, não apenas de aceitação da sugestão.
Mesmo após fechar os gates técnicos, o primeiro piloto produziria principalmente evidência de uso e operação: o agente consegue perceber a sugestão? Sabe quando ela está indisponível? Consegue rejeitá-la sem punição? O gestor entende o gasto e a regra de parada? Que erro chega ao canal de suporte? Uma amostra pequena pode revelar falhas graves e ainda ser insuficiente para estimar efeito médio ou PMF. Relatar “três agentes tiveram dificuldade na revisão” exigiria três agentes reais, consentimento e registro; não é algo que possamos deduzir da fixture atual.
O experimento deve admitir saídas diferentes. Se o fluxo manual já for rápido, talvez o melhor produto seja organizar fila e SLA sem IA. Se a sugestão reduzir tempo mas aumentar reabertura, a equipe pode restringir categorias ou pedir revisão adicional. Se custo faturado escapar da reserva, o piloto pausa independentemente da satisfação declarada. Se agentes não confiarem no resumo, reformular a experiência pode ser mais útil que trocar modelo. Essas decisões são um backlog orientado por evidência, não uma promessa de que um roadmap específico vencerá.
Para o portfólio profissional, essa seção funciona como compromisso público de método. Ela mostra que o candidato sabe que teste local, pesquisa de uso e resultado comercial respondem perguntas diferentes. Também revela onde precisa de colaboração: PM para valor e recrutamento, design para compreensão, suporte para exceções, segurança para dados e liderança para custo. Se uma vaga não oferece acesso a essas fontes, o trabalho possível muda; a narrativa de impacto precisa mudar junto. Isso evita transformar limitação organizacional em falha moral do engenheiro ou em claim fabricado.
Comece com o problema proposto e o papel do usuário. Mostre uma decisão técnica ligada à experiência: “mantivemos ticket manual quando o provedor cai”. Abra o teste; diga que é falha injetada. Mostre a alternativa rejeitada: resposta automática ao cliente. Apresente o achado inesperado do restore, sua correção e o limite. Termine no no-go e no experimento que mudaria a decisão. Isso dá ao entrevistador algo para desafiar em cada passo.
Pergunte também sobre a vaga: quem dá acesso a usuários? Quem decide cortar uma feature após feedback? O time tem design, PM e suporte disponíveis ou espera acumulação sem tempo? Há teto de custo e dono de incidentes? Como se mede uma tarefa útil, não só deploys? São perguntas práticas, não teste ideológico de “time de produto” versus “time de features”. Sinal de expectativa irreal: exigem impacto em receita sem acesso a dados, chamam opinião de pesquisa, ou colocam on-call e consentimento sobre uma pessoa sem autoridade para pausar.
Antes de publicar um case ou levá-lo à entrevista, execute o checker e abra os paths que ele aponta. Confirme que números trazem denominador e natureza sintética; que o texto diz “piloto não executado”; que a UI e o teto faturado seguem bloqueados; que nenhum link chama draft de página live. Peça revisão a PM/design/suporte para as interpretações que são deles. Um script verde é condição de consistência do registro, não prova de impacto.
Output é entrega produzida; outcome é mudança observada na tarefa ou negócio. Claim é uma afirmação do case que precisa de classe de evidência. Gate é condição verificável para avançar ou pausar. Modo sombra gera sugestão sem automatizar a decisão. PMF é uma hipótese sobre aderência produto-mercado que este exercício não mediu.
O portfólio final do DeskPilot não termina com “produto lançado”. Termina com um case que qualquer colega pode auditar e um próximo experimento que ainda precisa de pessoas, autorização e operação real. Esse é um ponto de partida mais útil para uma carreira de Product Engineer do que trocar o título no perfil: quando alguém perguntar “como você sabe?”, há um arquivo, um teste, um denominador e uma resposta honesta sobre o que ainda falta.
sources.md, case-study.md e portfolio-index.md.Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis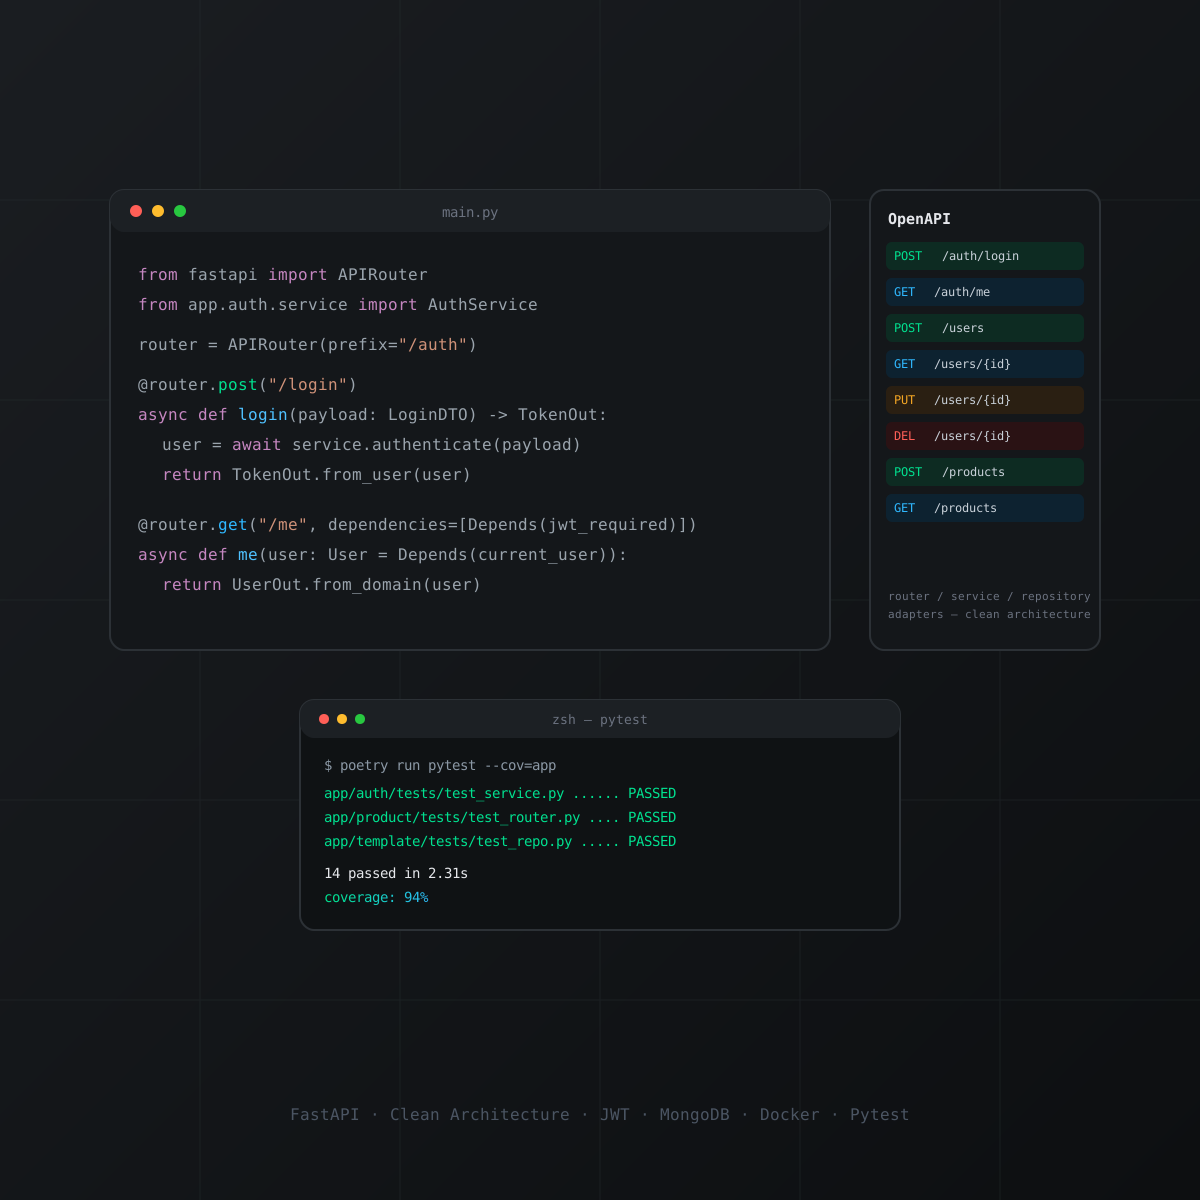
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto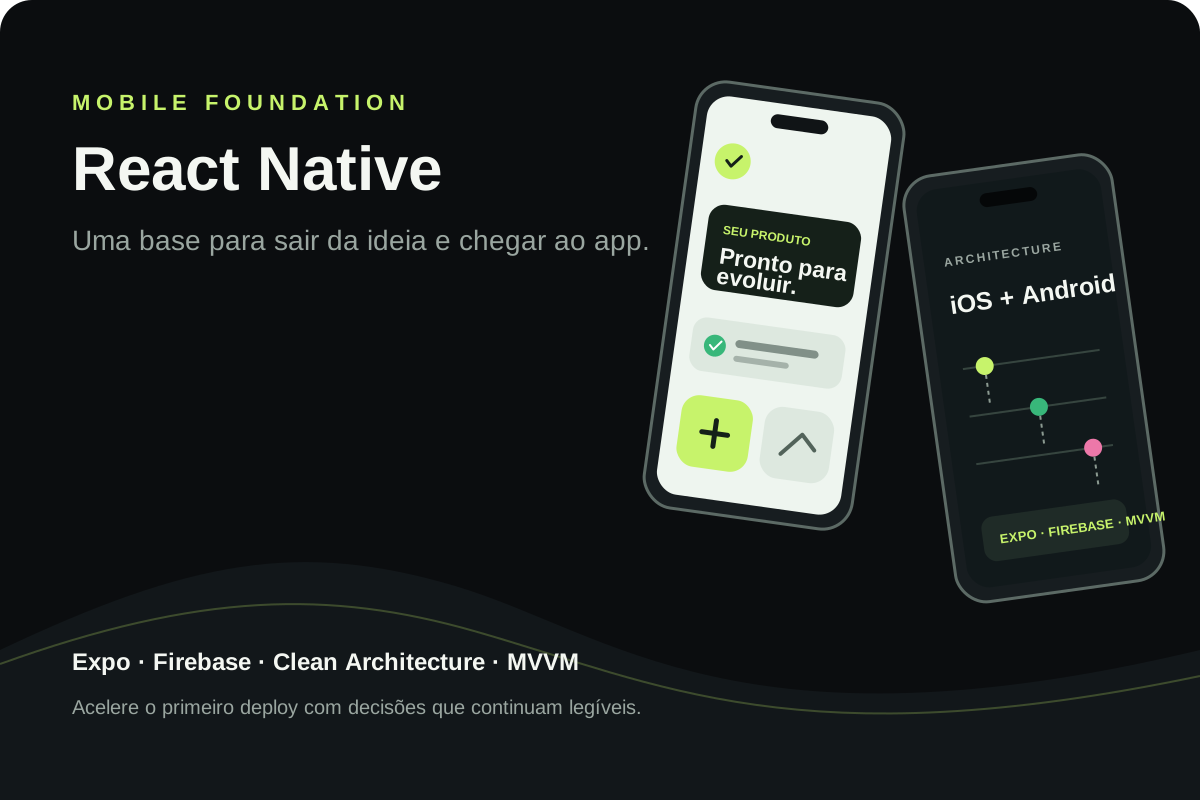
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto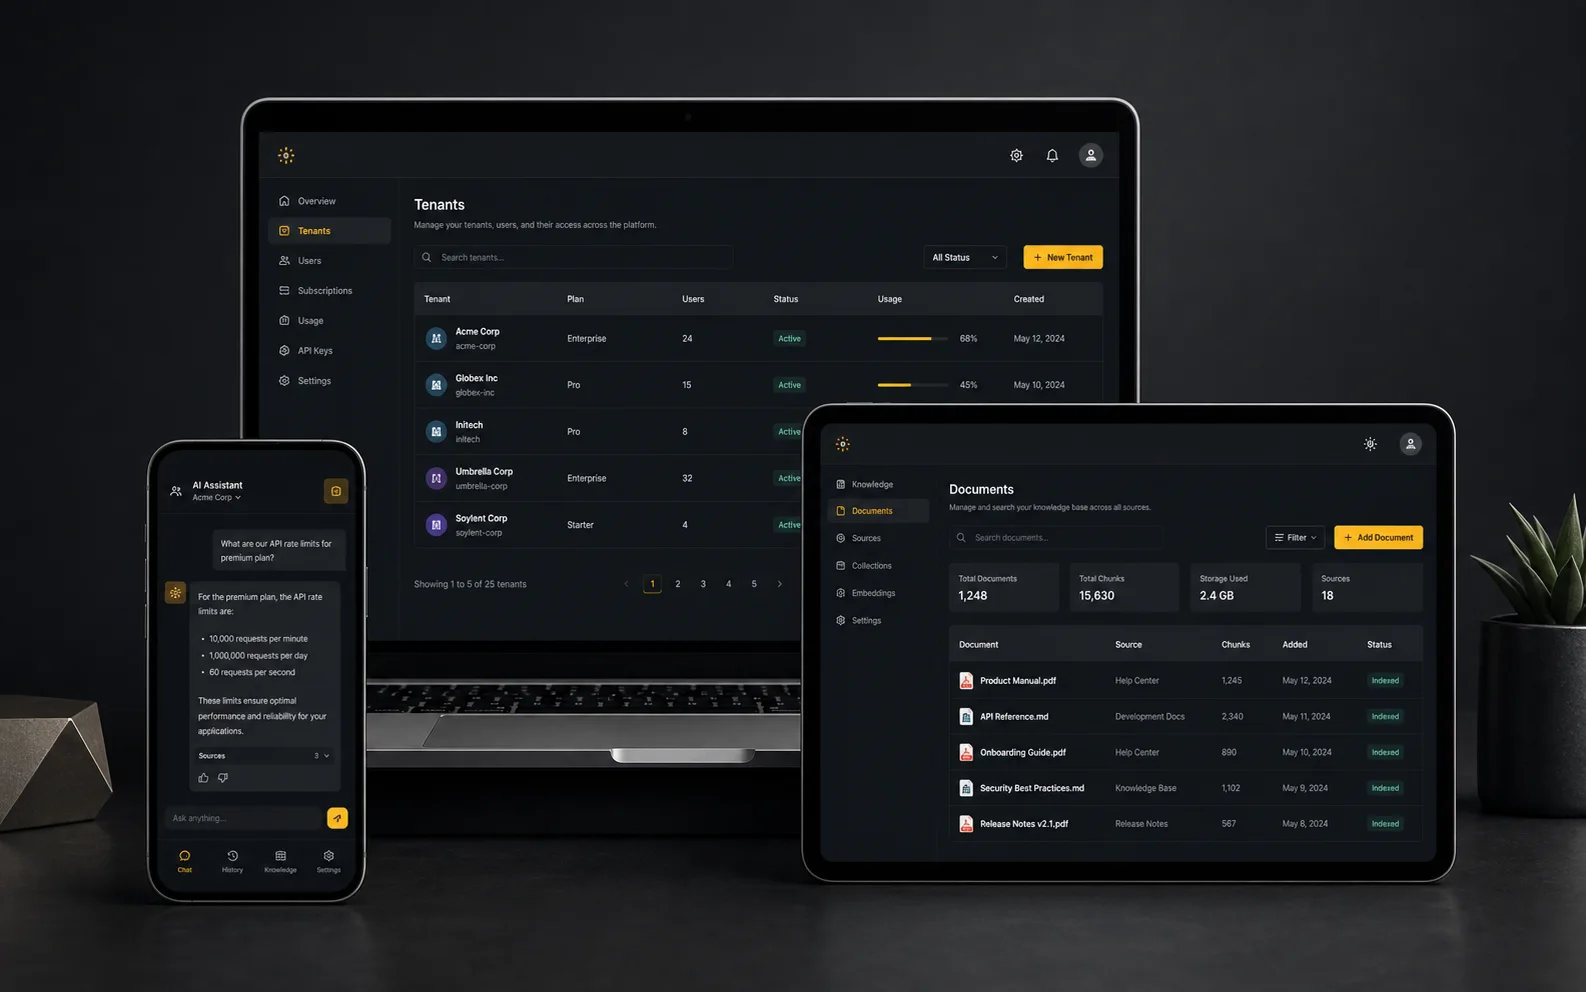
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

A rule, an AI suggestion, and a human agent's decision, for the same synthetic ticket: only one of them can ever change the ticket's state. From that constraint, DeskPilot gains a typed…
Eight chapters of code still cannot establish customer value. Use the DeskPilot case study, a behavioral skills matrix, and a 30/60/90-day plan to show decisions and their limits.

Um roteiro de entrevistas, uma árvore de oportunidades e um teste de disposição a pagar para decidir se o DeskPilot merece ser construído, usando apenas evidência sintética rotulada.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.