
Anderson LimaSoftware Engineer & Consultant
4 de outubro de 2026
28 min de leitura
5 visualizações
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis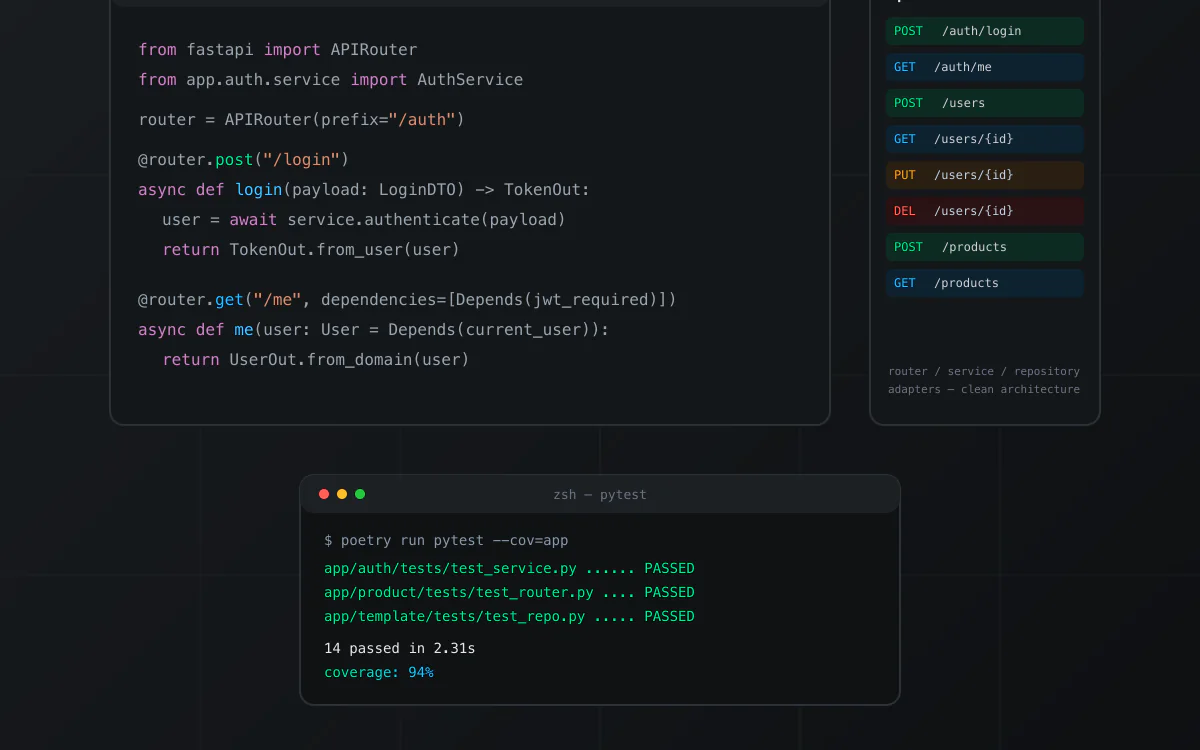
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto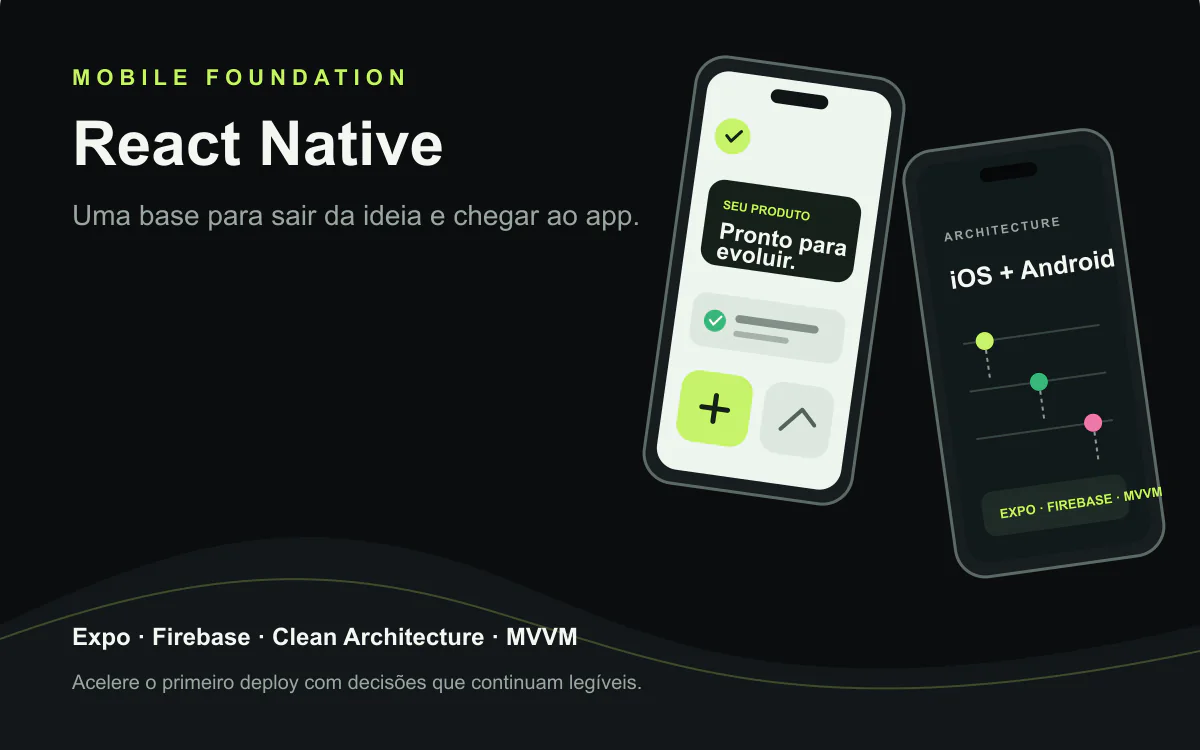
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoChecklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
English summary Vector databases are useful because they let software retrieve by meaning instead of only by literal words. That shift is powerful, but it also changes architecture, operations, and cost.
The right design starts with the user question, not with the database brand. If the relational database already owns the data and the use case is still small or medium, pgvector is often the most pragmatic first step. If the workload has become a dedicated semantic search product and the team wants to avoid managing the engine, Pinecone can be a solid managed option. If the product needs hybrid search and a search-native schema model, Weaviate becomes a strong candidate.
ANN is the core compromise that makes vector search practical. HNSW usually favors recall and search quality. IVFFlat often favors simpler operational trade-offs. Brute-force is still valid when the dataset is small or the workflow is early stage.
The real job is not picking a fashionable vector database. The real job is designing a retrieval system that stays fast, relevant, observable, and affordable as the product grows.
Resumo em português Vector database não é uma moda de AI. É uma resposta arquitetural para um problema real: como buscar por significado quando texto, imagem e contexto deixam de caber em consultas tradicionais.
Aqui você vai ver quando usar pgvector, quando um serviço gerenciado faz mais sentido, e como evitar decisões que quebram custo, latência ou qualidade. O ponto central não é escolher a ferramenta mais popular. É entender o custo de decisão antes de assinar contrato com qualquer fornecedor.
Busca por palavra sempre foi uma aproximação.
Ela funciona quando o usuário sabe exatamente o termo que procura.
Ela falha quando o usuário descreve a intenção de forma imperfeita.
É por isso que sistemas bons de busca sempre precisaram de camadas extras.
Sinônimos.
Stem.
Ranking.
Filtros.
Boosts.
Regras de negócio.
Quando a interface passou a aceitar perguntas, documentos longos, tickets, imagens e contexto de conversa, a busca literal ficou pequena demais.
O vetor entrou exatamente aí.
Ele não substitui o índice invertido.
Ele muda a pergunta.
Em vez de buscar palavras iguais, o sistema tenta buscar ideias próximas.
Isso altera tudo.
O formato da query muda.
A estrutura do dado muda.
A latência aceitável muda.
O custo do erro muda.
A arquitetura muda.
O que parecia um detalhe de machine learning vira uma decisão de backend, plataforma e produto.
Se você trata vector search como "só mais um banco", o sistema começa a falhar no lugar errado.
Se você trata como arquitetura, consegue ligar semântica, relevância e custo com muito mais controle.
É por isso que a discussão não é "qual banco de vetores é melhor".
A discussão é "qual formato de recuperação faz sentido para meu problema".
Embedding é uma representação numérica de um objeto.
Texto.
Imagem.
Áudio.
Código.
Produto.
Pergunta.
Cada objeto vira um vetor em um espaço de alta dimensão.
O objetivo não é decorar significado.
O objetivo é organizar proximidade.
Itens semanticamente parecidos tendem a ficar próximos.
Itens semanticamente distantes tendem a ficar longe.
Isso não é magia.
É aprendizado estatístico.
O modelo é treinado para capturar padrões de uso, contexto e coocorrência.
Depois disso, a aplicação usa o vetor como coordenada.
Ele não é um hash.
Ele não é um ID.
Ele não é um resumo completo do conteúdo.
Ele não garante que duas frases iguais semanticamente tenham distância perfeita.
Ele não substitui validação de negócio.
Ele não substitui filtro de segurança.
Ele não substitui política de acesso.
Sinonímia.
Paráfrase.
Relações conceituais.
Agrupamento por tema.
Recuperação de contexto para RAG.
Similaridade entre itens de catálogo.
Recomendação baseada em conteúdo.
Busca de tickets, documentação e respostas internas.
Exatidão lexical rígida.
Regras complexas de compliance.
Comparações booleanas em campos estruturados.
Filtros de faixa com precisão absoluta.
Critérios que dependem de interpretação determinística.
O erro mais comum é achar que embedding substitui tudo.
Ele não substitui.
Ele complementa.
Uma pipeline típica tem cinco etapas.
Ingestão.
Chunking.
Embedding.
Indexação.
Recuperação.
O segredo está na qualidade da transição entre essas etapas.
Se o chunk é ruim, o embedding já nasce pobre.
Se o embedding é pobre, o índice só acelera um erro.
Se o índice é ruim, a recuperação degrada.
Se o reranking é fraco, o usuário vê ruído.
Se a observabilidade é inexistente, ninguém descobre onde o problema começou.
type Chunk = {
  id: string;
  documentId: string;
  text: string;
  metadata: {
    source: string;
    language: "pt" | "en";
    tenantId: string;
    version: number;
    tags: string[];
  };
};

type VectorRecord = {
  id: string;
  vector: number[];
  metadata: Chunk["metadata"];
};

async function indexChunk(chunk: Chunk) {
  const vector = await embed(chunk.text);
  await vectorStore.upsert({
    id: chunk.id,
    vector,
    metadata: chunk.metadata,
  });
}

async function search(query: string) {
  const queryVector = await embed(query);
  const candidates = await vectorStore.query({
    vector: queryVector,
    topK: 20,
  });

  return rerank(query, candidates);
}
Cada etapa tem um tipo de falha diferente.
Ingestão falha por dados sujos.
Chunking falha por corte ruim de contexto.
Embedding falha por modelo inadequado.
Indexação falha por estrutura e parâmetros.
Recuperação falha por filtros, recall e ranking.
Reranking falha por custo e latência.
Observabilidade falha quando não existe.
Não comece pelo banco.
Comece pelo comportamento esperado.
Que tipo de pergunta o usuário faz.
Que tipo de resposta o sistema precisa devolver.
Qual é o custo de um falso positivo.
Qual é o custo de um falso negativo.
Qual é a latência máxima tolerável.
Qual é o volume esperado.
Qual é o ciclo de atualização do conteúdo.
Sem isso, qualquer escolha de vector DB vira chute.
Busca exata compara tudo com tudo.
Isso é simples.
Isso é correto.
Isso é caro.
ANN existe para trocar exatidão por eficiência controlada.
O sistema deixa de olhar todo o espaço.
Ele olha uma estrutura aproximada.
E isso costuma ser suficiente.
Conjunto pequeno.
Dados temporários.
Baixa taxa de consulta.
Fase de protótipo.
Necessidade de reprocessamento determinístico.
Ambiente em que erro de ranking é mais caro que latência.
Volumes médios ou grandes.
Leituras frequentes.
Interação em tempo quase real.
RAG com múltiplos documentos.
Busca semântica em catálogo ou help center.
HNSW cria um grafo navegável em camadas.
Você começa por um ponto alto.
Vai descendo até chegar perto da vizinhança correta.
Ele tende a entregar boa qualidade de busca.
Ele costuma exigir mais memória.
Ele é muito útil quando o recall importa e a consulta precisa ser responsiva.
IVFFlat divide o espaço em listas.
Ele agrupa vetores parecidos.
Depois procura primeiro nas listas mais prováveis.
Ele pode ser mais simples de operar em alguns cenários.
Ele depende mais de treinamento e da qualidade da distribuição.
Ele pode ser bom quando build time e footprint importam.
Se o conjunto é pequeno, brute-force é honesto.
Se o conjunto é pequeno, brute-force também é fácil de entender.
Se o conjunto é pequeno, brute-force pode ser a melhor decisão.
Uma arquitetura madura sabe quando não precisa de sofisticação.
Se você não sabe explicar o motivo do índice, você provavelmente não sabe operar o índice.
Se você não sabe explicar o trade-off entre memória e qualidade, você provavelmente vai sofrer em produção.
Se o time quer "a opção mais rápida" sem definir recall, o sistema vai otimizar a coisa errada.
Vector database não é só armazenamento.
É uma cadeia de responsabilidades.
Persistir vetores.
Organizar índices.
Suportar filtros.
Respeitar multitenancy.
Permitir atualização incremental.
Servir consultas com baixa latência.
Expor observabilidade.
Gerenciar custo.
Ingest pipeline.
Embedding service.
Vector store.
Metadata store.
Query service.
Reranker.
Cache.
Audit log.
Observability stack.
Single store.
Dual store.
Search orchestration service.
Tudo vive no mesmo sistema.
É mais simples.
É mais fácil de começar.
É mais fácil de operar.
É mais fácil de errar a escala.
Metadados ficam em um banco relacional.
Vetores ficam no mecanismo vetorial.
É comum em produção.
É mais flexível.
Exige sincronização bem pensada.
Um serviço próprio coordena embedding, busca, filtro e reranking.
Esse modelo separa o domínio de busca da infraestrutura.
Ele é mais caro de construir.
Ele tende a pagar dividendos quando a busca é uma capacidade central do produto.
Uma fonte clara de verdade para documentos.
Uma política de versionamento.
Uma estratégia de reindexação.
Um mecanismo de rollback.
Um limite de custo por consulta.
Uma forma de medir qualidade da recuperação.
pgvector é atrativo porque reduz a quantidade de sistemas.
Se o Postgres já é a base do produto, ele pode carregar a primeira versão da busca vetorial.
Isso não significa que ele é sempre a resposta final.
Significa que ele é um excelente ponto de partida em muitos produtos.
Você mantém joins.
Você mantém transações.
Você mantém filtros relacionais.
Você mantém o ecossistema do Postgres.
Você evita uma nova camada operacional cedo demais.
Você compartilha recursos com o banco principal.
Você pode sofrer com concorrência entre OLTP e busca vetorial.
Você precisa cuidar do crescimento do índice.
Você precisa observar impacto em vacuum, bloat e manutenção.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
  id BIGSERIAL PRIMARY KEY,
  tenant_id TEXT NOT NULL,
  title TEXT NOT NULL,
  body TEXT NOT NULL,
  embedding vector(1536) NOT NULL,
  metadata JSONB NOT NULL DEFAULT '{}'::jsonb,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX documents_tenant_idx ON documents (tenant_id);
CREATE INDEX documents_metadata_gin ON documents USING GIN (metadata);
SELECT
  id,
  title,
  1 - (embedding <=> $1) AS similarity
FROM documents
WHERE tenant_id = $2
  AND metadata @> '{"language":"pt"}'
ORDER BY embedding <=> $1
LIMIT 10;
Você quer rapidez de entrega.
Você quer simplificar arquitetura.
Você quer manter dados relacionais próximos do índice.
Você quer flexibilidade para experimentar.
Você quer evitar um serviço externo antes da hora.
O volume cresce demais.
A concorrência cresce demais.
A busca deixa de ser periférica e vira core.
O time precisa de escalabilidade operacional mais especializada.
Os custos de manter tudo junto passam a ser maiores que o benefício.
pgvector não é "menor".
Ele é uma escolha pragmática quando o banco relacional ainda é o centro da verdade.
Pinecone representa o extremo da conveniência operacional.
Você terceiriza parte da complexidade do motor vetorial.
Em troca, ganha uma API focada e menos carga de operação direta.
Quando o time quer foco em produto.
Quando a busca vetorial é um subsistema importante.
Quando a equipe não quer administrar infraestrutura de índice.
Quando o produto exige elasticidade e operação simples para o time de aplicação.
Vendor lock-in.
Custo recorrente.
Dependência de conectividade e contrato de serviço.
Arquitetura de filtro precisa ser bem desenhada.
Observabilidade deve ser integrada ao seu stack.
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("docs-index")

def upsert_document(doc_id, vector, metadata):
    index.upsert([
        {
            "id": doc_id,
            "values": vector,
            "metadata": metadata,
        }
    ])

def query_documents(vector, tenant_id):
    return index.query(
        vector=vector,
        top_k=10,
        filter={"tenant_id": {"$eq": tenant_id}},
        include_metadata=True,
    )
Você já validou o caso de uso.
Você quer escalar sem montar a operação do motor.
Você aceita o custo do serviço como preço da simplicidade.
Você tem um produto que precisa de vector search como capacidade central e não como experimento.
Taxa de hits por filtro.
Tempo de consulta por tenant.
Custo por requisição.
Tempo de reindexação.
Taxa de atualização de vetores.
Uso de metadata para segmentação.
Se o problema principal é velocidade de mercado, serviço gerenciado costuma vencer.
Se o problema principal é controle fino e coexistência com o banco relacional, pgvector costuma vencer.
Se o problema principal é uma plataforma de busca vetorial com autonomia própria, a resposta pode ser outra.
Weaviate é interessante porque cruza busca vetorial e busca por palavras em um mesmo ecossistema.
Isso é útil quando o produto não quer escolher entre lexical e semântico.
Na prática, muita busca boa precisa dos dois.
Hybrid search.
Schema com semântica explícita.
Boa experiência para quem quer construir pesquisa mais rica.
Ecossistema que conversa bem com casos de RAG e catálogo.
Operação própria pode ser mais complexa.
Modelagem errada deixa o sistema difícil de ajustar.
Sem governança, a flexibilidade vira bagunça.
import weaviate

client = weaviate.connect_to_local()

collection = client.collections.create(
    name="Document",
    properties=[
        {"name": "title", "dataType": ["text"]},
        {"name": "body", "dataType": ["text"]},
        {"name": "tenantId", "dataType": ["text"]},
    ],
)

collection.data.insert(
    {
        "title": "Vector DB Architecture",
        "body": "How embeddings, ANN and hybrid search work in production.",
        "tenantId": "acme",
    }
)
Você quer lexical plus vector.
Você quer flexibilidade de schema com um motor de busca próprio.
Você quer um modelo híbrido que não dependa tanto de uma base relacional para cada consulta.
Como o schema cresce.
Como filtros afetam recall.
Como o cluster reage a reindexação.
Como você versiona coleções.
Como lida com múltiplos tenants.
Não escolha pelo hype.
Escolha pelo formato do problema.
Se o dado de origem já está no Postgres, começar com pgvector costuma ser inteligente.
Se a busca vetorial virou produto e a operação do índice não é o seu diferencial, um serviço gerenciado pode economizar muito tempo.
Se você precisa de busca híbrida com modelagem específica e autonomia de motor, Weaviate entra forte na conversa.
Os dados mudam com que frequência.
O volume de consultas é previsível.
A busca precisa de filtros fortes.
O time quer operar infraestrutura ou preferiria focar em features.
O produto depende de busca como core feature ou como suporte.
Use pgvector quando a complexidade precisa ser mínima.
Use Pinecone quando a operação do motor não deve consumir o time.
Use Weaviate quando a combinação lexical-semântica é central.
Use uma solução própria quando o domínio e o volume justificarem.
Tratar todo repositório vetorial como se tivesse o mesmo formato de carga.
Ele não tem.
Busca de documentação não parece com busca de produto.
Busca de tickets não parece com recomendação.
Busca de imagem não parece com busca textual.
RAG não parece com catálogo.
O vetor é só uma parte do registro.
O resto é contexto.
E contexto é o que evita recuperação errada.
ID estável.
Tenant.
Source.
Language.
Chunk version.
Embedding version.
Texto original.
Título.
Tags.
Timestamp.
Uma forma de reconstruir o documento original.
Uma forma de reindexar.
Uma forma de invalidar versões antigas.
Uma forma de filtrar por escopo.
Uma forma de auditar o que foi recuperado.
Um vetor por documento.
Um vetor por chunk.
Múltiplos vetores por artefato.
Metadados normalizados em tabela relacional.
Metadados duplicados no motor vetorial para filtro rápido.
Documento inteiro funciona para itens curtos.
Chunk funciona melhor para contexto longo.
Múltiplos vetores por artefato ajudam em multimodal.
Metadados normalizados ajudam em governança.
Metadados duplicados ajudam em latência.
Se o texto muda, o embedding pode mudar.
Se o embedding muda, o índice precisa ser reavaliado.
Se a versão muda, o sistema precisa saber qual versão responder.
Chunking é a diferença entre bom resultado e ruído.
Chunk pequeno demais perde contexto.
Chunk grande demais perde precisão.
O ideal depende do domínio.
Chunk por heading.
Chunk por parágrafo.
Chunk por janela fixa com overlap.
Chunk semântico por seção.
Chunk orientado a documento.
Se a pergunta normalmente atravessa parágrafos.
Se a resposta precisa de contexto anterior.
Se o documento tem estrutura estável.
Se o documento muda com frequência.
Se o domínio tem termos técnicos densos.
Fonte original.
Categoria.
Idioma.
Tenant.
Versão.
Data de publicação.
Data de atualização.
Autorização de acesso.
Tags de produto.
Canal de origem.
Versão antiga não deve competir com a nova sem intenção.
Versão antiga não deve ficar invisível sem rastreio.
Versão antiga não deve sobreviver por acidente.
Versionamento bom evita recuperar texto certo da versão errada.
Indexe por versão.
Consuma por versão ativa.
Mantenha histórico para auditoria.
Reindexe de forma controlada.
Registre o motivo de troca de embedding.
Vector search resolve semântica.
Lexical search resolve exatidão.
Juntas, as duas técnicas costumam ser melhores do que qualquer uma sozinha.
Nomes próprios.
IDs.
Código.
Termos técnicos muito específicos.
Documentos com vocabulário fechado.
Catálogos em que o usuário mistura intenção e string exata.
Recuperar candidatos é só metade do trabalho.
Reranking reorganiza os resultados com mais inteligência.
Ele pode usar um modelo mais caro.
Ele pode usar um cross-encoder.
Ele pode usar regras de negócio combinadas.
Buscar top 50 por vetor.
Filtrar por tenant e permissão.
Fazer rerank dos 10 melhores.
Devolver top 5 com snippets confiáveis.
Não reranqueie tudo.
Não jogue modelo caro em volume bruto.
Use candidatos bons.
Use limites.
Use métricas.
Recall@k.
MRR.
NDCG.
Precision@k.
Latência de reranking.
Custo por consulta.
Sem observabilidade, a busca vira opinião.
Você precisa saber se o sistema recupera o que deveria.
Latência p50.
Latência p95.
Latência p99.
Taxa de erro.
Tempo de indexação.
Taxa de reindexação.
Tamanho do índice.
Uso de memória.
Taxa de cache hit.
Recall.
Relevância percebida.
CTR nos resultados.
Taxa de refinamento de query.
Taxa de zero result.
Taxa de fallback lexical.
Taxa de fallback manual.
Tempo até resposta útil.
Tempo até primeira ação.
Satisfação da busca.
Taxa de abandono.
Taxa de uso repetido.
Logue query.
Logue tenant.
Logue filtros.
Logue versão do embedding.
Logue candidatos retornados.
Logue o item clicado.
Logue o tempo da etapa de rerank.
Medir só latência.
Medir só custo.
Medir só volume de dados.
Medir só número de embeddings gerados.
Medir só número de queries por dia.
Isso cria ilusão de saúde.
A maioria das falhas não parece falha no início.
Elas parecem "relevância estranha".
Embedding errado para o idioma.
Chunking incoerente.
Indexação sem versão.
Atualização parcial.
Filtro forte demais.
Filtro fraco demais.
Reranking caro demais.
Cache inválido.
Dados duplicados.
Permissão esquecida.
Ninguém é dono do índice.
Ninguém sabe como reindexar.
Ninguém monitora qualidade.
Ninguém sabe quando trocar de modelo.
Ninguém sabe explicar o custo.
Misturar OLTP com carga de busca sem isolamento.
Confiar em metadata inconsistente.
Ignorar tenant boundary.
Ignorar versionamento.
Ignorar backfill.
Ignorar rollback.
Defina dono.
Defina contrato.
Defina métricas.
Defina rollback.
Defina ciclo de revisão.
Não necessariamente.
Muitos sistemas começam no Postgres com pgvector e só depois avaliam um motor separado.
Não.
A melhor escolha depende de memória, dinâmica de atualização, volume e tolerância a trade-offs.
Pode.
Mas a qualidade tende a ser melhor quando a recuperação inicial é seguida de um segundo passo de ordenação.
Nem sempre.
Se o corpus é pequeno, um fluxo simples pode ser suficiente.
Se o corpus cresce e o contexto fica caro, o motor vetorial passa a fazer sentido.
Pode, mas com cuidado.
Filtros e cardinalidade afetam performance e desenho do índice.
Quando as respostas recuperadas parecem corretas na superfície, mas não sustentam a pergunta completa.
Quando perguntas parecidas caem em vizinhos errados de forma repetitiva.
Quando o conteúdo certo existe, o embedding é plausível, mas a recuperação perde qualidade por parâmetros ou estrutura.
Quando o candidato certo aparece, mas a ordenação final devolve algo menos útil.
Quando a intenção do usuário não foi bem definida.
Medir.
Simular.
Comparar.
Documentar.
Migrar só com critério.
Busca é parte da experiência.
Vector DB é meio.
Produto é fim.
Vector search is not only about recall and latency.
It is also about where your metadata lives, how your team operates indexes, and whether semantic retrieval belongs near your transactional system or in a dedicated retrieval plane.
That is why architecture matters more than vendor demos.
When the relational database already owns the data and the use case is still small or medium, pgvector is often the most pragmatic first step because it keeps joins, transactions, and filters where the team already operates.
If the workload has become a dedicated semantic search product and the team prefers to avoid managing the engine, a managed offering such as Pinecone can save operational cycles and reduce time to market.
If the product needs hybrid search and a search-native schema model, Weaviate becomes a strong candidate, especially when lexical and semantic signals must be combined.
ANN is the core compromise that makes vector search practical.
HNSW usually favors recall and search quality at the cost of memory.
IVFFlat favors simpler operational trade-offs and smaller indexes.
Brute-force remains valid for small datasets and early-stage workflows.
Architecture means defining what must stay correct under pressure, what can degrade safely, what the team can actually operate, and what the rollback path looks like.
The mature teams buy only the complexity they can explain, monitor, and reverse.
| Pergunta | pgvector | Pinecone | Weaviate |
|---|---|---|---|
| Você já usa Postgres como fonte de verdade? | Forte candidato | Pode funcionar | Pode funcionar |
| Você quer minimizar a operação inicial? | Bom ponto de partida | Muito forte | Médio |
| Você precisa de busca híbrida forte? | Possível, mas limitada | Depende do desenho | Muito forte |
| Você quer manter joins relacionais simples? | Muito forte | Fraco | Médio |
| Você quer separar o motor da base transacional? | Menos ideal | Forte | Forte |
| Você quer foco em produto, não em operação? | Médio | Forte | Médio |
| Você quer um caminho pragmático para piloto? | Muito forte | Forte | Forte |
| Você quer governança relacional bem próxima? | Muito forte | Médio | Médio |
| Você quer reduzir lock-in? | Forte | Fraco | Médio |
| Você quer buscar conteúdo com filtros complexos? | Forte | Forte | Forte |
| Você quer controles de schema centralizados? | Forte | Médio | Forte |
| Você quer evoluir sem trocar tudo cedo? | Forte | Forte | Forte |
Embedding.
Representação numérica de um objeto.
Chunk.
Fragmento de um documento usado para indexação.
ANN.
Approximate Nearest Neighbor.
HNSW.
Hierarchical Navigable Small World.
IVFFlat.
Índice aproximado baseado em listas e agrupamento.
Reranking.
Etapa de reordenação dos candidatos recuperados.
Hybrid search.
Combinação de busca lexical com busca vetorial.
Metadata.
Contexto estruturado associado ao vetor.
Recall.
Capacidade de recuperar o que era relevante.
Precision.
Capacidade de evitar ruído.
Tenant.
Escopo de isolamento entre clientes ou domínios.
Drift.
Mudança no comportamento ou na distribuição ao longo do tempo.
Backfill.
Reprocessamento de dados antigos.
Rollback.
Volta controlada para um estado anterior.
Reindex.
Reconstrução de índices a partir da fonte.
Cross-encoder.
Modelo que avalia query e documento juntos para pontuar relevância fina.
MRR.
Mean Reciprocal Rank. Métrica que mede a posição média do primeiro resultado relevante.
NDCG.
Normalized Discounted Cumulative Gain. Métrica que pondera relevância pela posição.
Precision@k e Recall@k.
Qualidade medida considerando apenas os top k resultados retornados.
OLTP.
Online Transaction Processing. Carga típica de gravação e leitura em banco relacional.
Open source.
Modelo de licenciamento que permite inspecionar, modificar e operar o software sem licença proprietária, sem implicar ausência de custo operacional.
Vector database não é um banco de moda.
É uma resposta para um problema real: buscar significado em vez de buscar só palavras.
Se o seu produto depende de documentação, RAG, catálogo ou busca semântica, o desenho importa mais que o nome do motor.
pgvector costuma ser a melhor porta de entrada quando o Postgres já é a base do sistema.
Pinecone faz sentido quando o time quer foco em produto e menos operação do índice.
Weaviate entra forte quando hybrid search e modelagem de busca são parte central da proposta.
HNSW tende a ser uma boa escolha quando qualidade importa.
IVFFlat pode ser interessante quando operação e custo pedem outro equilíbrio.
O ponto mais importante não é escolher a ferramenta mais popular.
É entender chunking, embedding, filtros, reranking, métricas e versionamento.
Sem isso, o motor mais sofisticado só acelera uma arquitetura fraca.
Vector databases are not just a trendy storage layer.
They are an architectural answer to semantic retrieval.
If your product relies on RAG, documentation search, catalog search, or semantic similarity, the retrieval design matters more than the brand name.
pgvector is often the most pragmatic first step when Postgres already owns the source of truth.
Pinecone fits well when the team wants managed infrastructure and less operational burden.
Weaviate becomes attractive when hybrid search is central to the product.
HNSW usually favors quality.
IVFFlat often balances operational simplicity and performance differently.
The real work is not picking a database.
The real work is designing chunking, embeddings, filters, reranking, observability, and versioning.
Without that, even the best vector engine only amplifies a weak retrieval design.
Boas decisões de vector search acontecem quando o time conecta comportamento de usuário, custo de erro, formato do dado e capacidade operacional em uma só conversa. A frase "Quando X acontece, Y" descreve bem essa cadeia: quando a pergunta do usuário é ambígua, a recuperação também fica ambígua. Quando o documento é mal chunkado, o vetor herda a ambiguidade. Quando o índice é escolhido sem pensar no padrão de escrita, a operação piora depois do primeiro sucesso. Quando o time não define quem reindexa, a dívida cresce em silêncio. Quando a permissão é validada só depois da query, o risco de vazamento sobe. Quando o embedding muda sem versionamento, a reindexação vira loteria. Quando o conjunto de validação é pequeno demais, a avaliação engana. Quando o sistema tem múltiplos tenants, o isolamento precisa ser explícito. Quando ninguém quer mexer na pipeline, o sistema já está caro. Quando a recuperação deixa de ser confiável, o usuário volta à busca manual e a feature perde valor. A arquitetura boa reduz esse ciclo. A arquitetura ruim só o acelera. Por isso o ponto central deste artigo não é o motor: é a clareza sobre custo de decisão antes do primeiro deploy.