
Anderson LimaSoftware Engineer & Consultant
4 de outubro de 2026
2 min de leitura
5 visualizações
English summary: Detect hallucinations that leak secrets or dangerous instructions.
LLMs:
Validation é crítica.
def verify_fact(claim: str) -> bool:
  # 1. LLM generates claim
  # 2. Search for evidence
  results = web_search(claim)

  # 3. LLM validates against search results
  prompt = f"""
  Claim: {claim}
  Evidence: {results}

  Is the claim supported by evidence? Yes/No
  """

  validation = llm.generate(prompt)
  return "yes" in validation.lower()

claim = llm.generate("When was Python created?")
# "Python was created in 1985"  # WRONG!

is_valid = verify_fact(claim)
# False (search shows 1991)
# Ask same question 3x, check consistency
answers = [llm.generate("Capital of France?") for _ in range(3)]

if len(set(answers)) > 1:
  print("Inconsistent! Possible hallucination")
from bandit import run_bandit

code = llm.generate("Generate Python login function")

# Scan for vulnerabilities
issues = run_bandit(code)

if issues:
  print(f"Security issues found: {issues}")
  # Reject or ask LLM to fix
# Constrain outputs com JSON Schema
response = llm.generate(prompt, response_format={
  "type": "json_schema",
  "json_schema": {
    "type": "object",
    "properties": {
      "answer": {"type": "string", "maxLength": 100},
      "confidence": {"type": "number", "minimum": 0, "maximum": 1}
    },
    "required": ["answer", "confidence"]
  }
})
# LLM MUST return valid JSON matching schema
# ❌ Vulnerable
user_input = request.GET['query']
prompt = f"Answer: {user_input}"

# ✅ Sanitized
def sanitize(text):
  # Remove special instructions
  banned = ["ignore previous", "system:", "assistant:"]
  for phrase in banned:
    text = text.replace(phrase, "")
  return text

safe_input = sanitize(user_input)
prompt = f"Answer: {safe_input}"
LLM outputs SÃO UNTRUSTED. Valide com fact-checking, code scanning e output constraints antes de produção.
Cenário: Plataforma devtools. DevTools implementou scanner semântico que intercepta respostas perigosas antes de exibir ao usuário.
| Métrica | Antes | Depois |
|---|---|---|
| Incidentes de vazamento | 5 | 0 |
| Tempo para bloquear resposta | minutos | <5s |
| Feedback negativo | 12% | 3% |
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis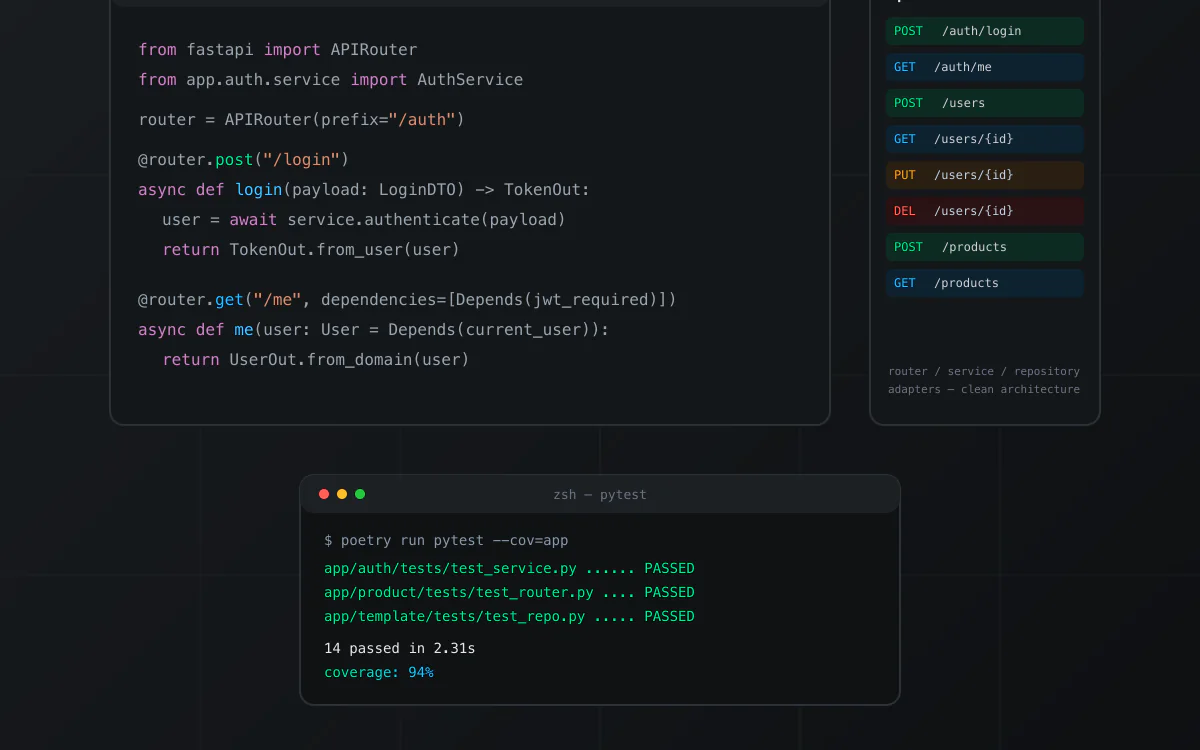
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto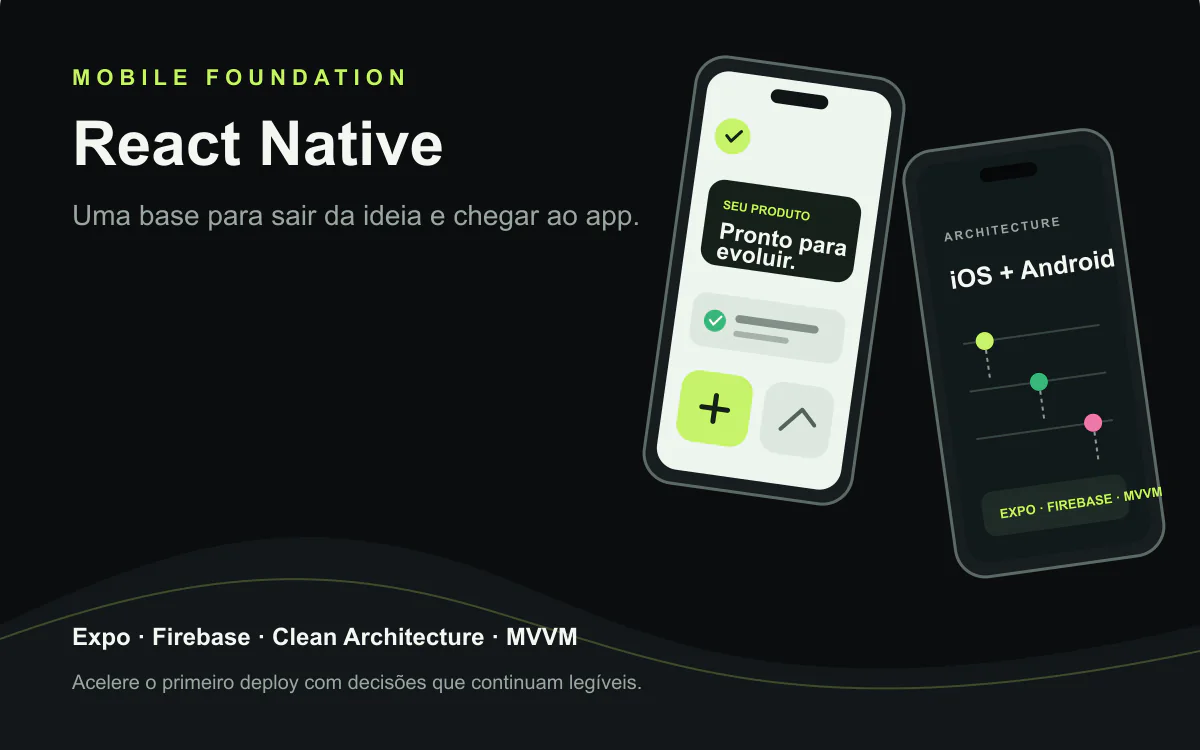
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto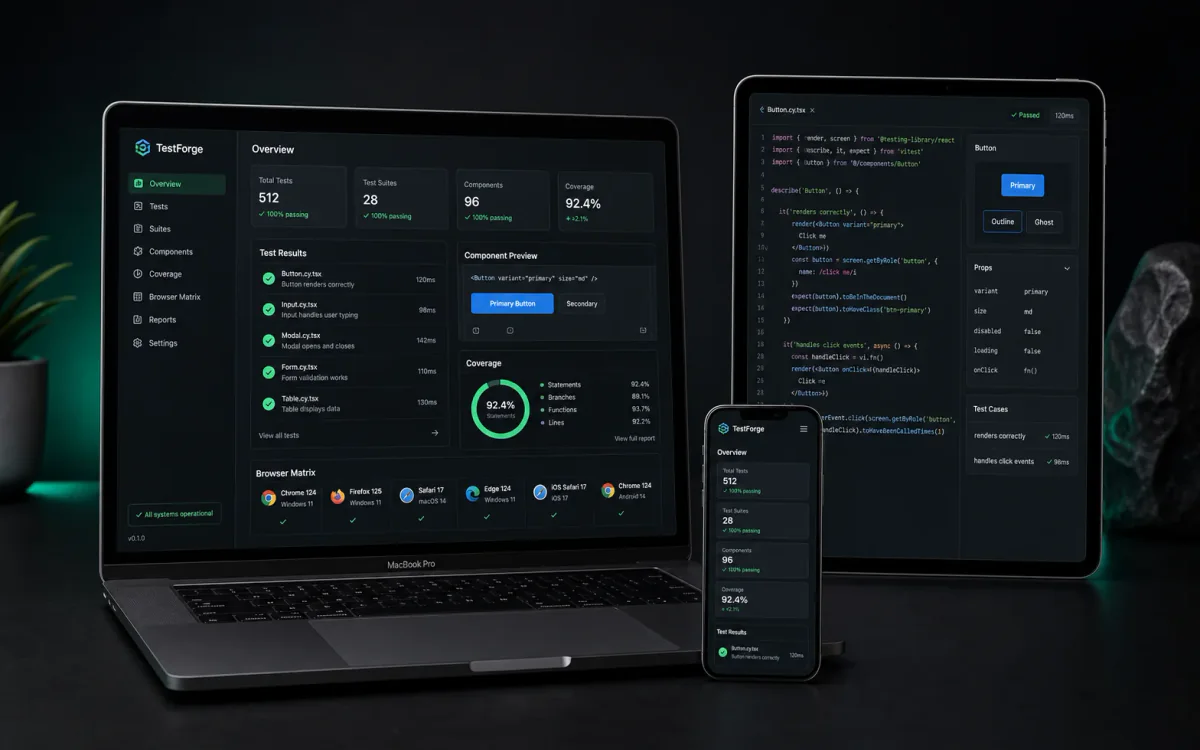
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto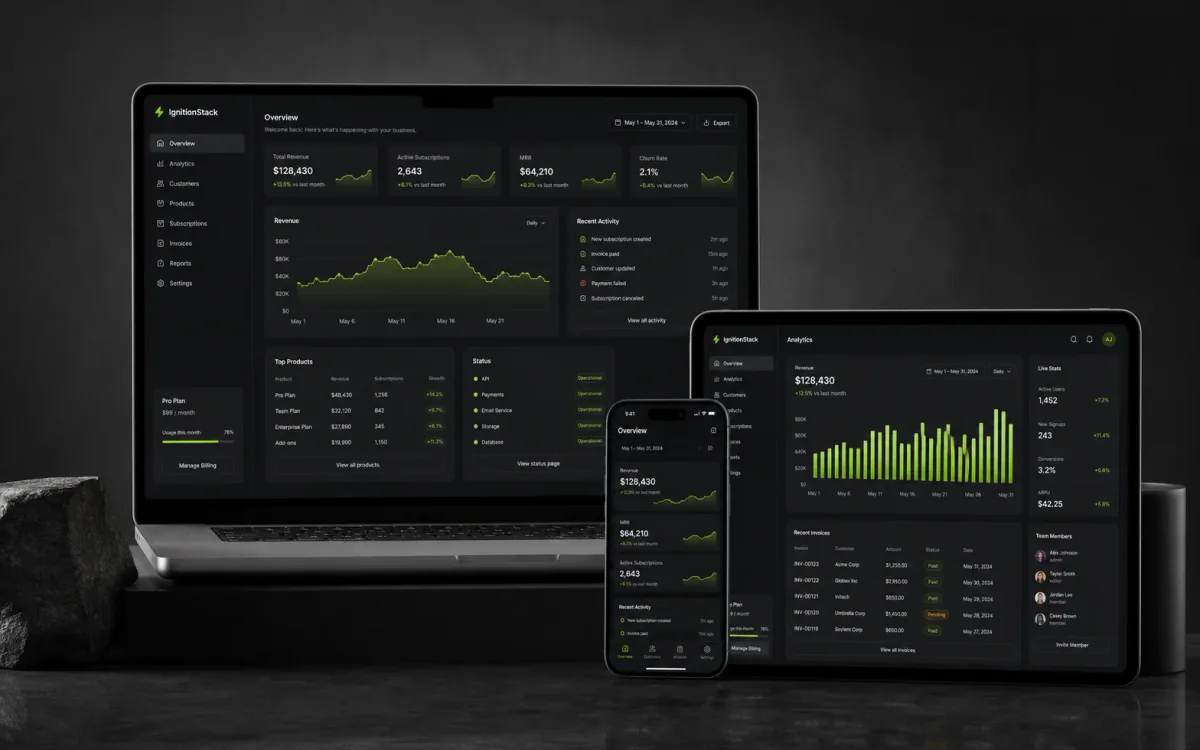
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
Fine-tuning learns behavior; RAG provides context. In 2026, the choice isn't binary—it's architectural. Explore deep metrics, PEFT/LoRA code, and hybrid patterns.
Otimizar prompts tem limite. Quando você precisa de lógica condicional, múltiplas chamadas LLM e ferramentas externas, prompts viram spaghetti. Agents são a evolução.
Harness virou uma das ideias mais importantes do desenvolvimento com AI em 2026. Este guia mostra o que é um agent harness, por que ele importa, como implementar guardrails e um LLM Evaluation Harness em TypeScript e quando essa abordagem funciona melhor do que um fluxo de Spec-Driven Development rígido.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.