
Anderson LimaSoftware Engineer & Architect
1 de outubro de 2026
21 min de leitura
2 visualizações
Um brief verificável para sair da lógica do ticket sem fingir autonomia ou resultados

O ticket dizia: “Adicionar um chatbot para agilizar o suporte”. A equipe entregou um widget bem construído. Abre rápido, passa nos testes e registra conversas. Na segunda-feira, o agente continua lendo cada solicitação, tentando descobrir a qual fila ela pertence e procurando alguém disponível. O gestor pergunta por que a demora na atribuição permanece. O desenvolvedor responde que o chatbot foi entregue conforme o ticket. Ambos dizem a verdade.
Essa cena é demonstrativa. Não descreve um cliente do Lemon nem um produto em operação. Serve para expor uma lacuna: software correto pode deixar intacto o problema que motivou sua construção. A pergunta de produto começa antes da stack: que decisão permitiria atribuir um ticket à pessoa certa mais cedo, sem aumentar erros ou transferir custo oculto ao suporte?
Minha tese: Product Engineering começa quando uma pessoa de engenharia assume, junto com PM, design, suporte e negócio, responsabilidade por formular o problema, escolher uma intervenção e observar suas consequências. Isso não exige abandonar profundidade técnica nem acumular todas as funções. Exige uma fronteira de decisão explícita. Um título novo, sem acesso a usuários, critérios e autoridade, não produz essa fronteira.
Vamos construir o primeiro artefato do DeskPilot, um produto didático de triagem assistida para suporte B2B. Neste capítulo ele ainda não tem cliente, entrevistas, receita, aplicação em produção ou benefício comprovado. A saída é um brief v0 que qualquer equipe pode contestar e um checker offline que detecta campos essenciais ausentes. O capítulo seguinte investigará se o problema e o segmento propostos sobrevivem ao contato com usuários reais.
“Adicionar chatbot” é uma especificação de entrega. Ela não identifica quem sofre, qual comportamento muda nem como saberemos se houve melhora. Para iniciar, escreva duas alternativas concorrentes:
| Proposta | O que muda | Como poderia falhar |
|---|---|---|
| Sem IA: formulário com campos obrigatórios, categorias fixas e fila revisada por agente | Entrada menos ambígua; regras conhecidas | Campos ruins atrasam o cliente; regras envelhecem |
| Com IA: sugerir categoria e resumo para revisão do agente | Agente pode compreender mais cedo tickets longos | Sugestão errada pode induzir atribuição incorreta |
Em ambos os casos, o resultado de interesse é tempo até atribuição correta, medido desde a chegada até a primeira atribuição confirmada como correta por uma regra de revisão definida antes do teste. A hipótese inicial é refutável: “Num piloto autorizado com tickets elegíveis de uma equipe B2B, triagem assistida e revisada por humano reduz a mediana desse tempo frente ao fluxo sem IA, sem elevar reatribuições ou incidentes de tenant.” O brief v0 propõe 20% de redução relativa da mediana ao longo de duas semanas como meta didática de experimento, não resultado observado nem critério já aprovado para piloto. Volume, sazonalidade, qualidade do baseline e custo aceitável de erro ainda precisam ser discutidos com suporte e owner antes de fixar qualquer limiar operacional.
Uma feature entregue é verificável por deploy, teste e aceite técnico. Adoção exige observar se agentes a usam no trabalho real, em quais casos, e por quê. Resultado exige comparação da medida de interesse com baseline e efeitos adversos. “O modelo produziu uma categoria válida” verifica um contrato de dados. “O agente aceitou a sugestão” mostra comportamento. Nenhum dos dois demonstra que o cliente recebeu resposta melhor. Essa separação muda arquitetura: registramos sugestão, revisão, atribuição e correção como eventos distintos, sujeitos a permissão e retenção definidas.
“Product Engineer” não é uma promoção automática de “software engineer”. São recortes de responsabilidade que variam por organização. Um engenheiro de software pode dominar confiabilidade, dados ou infraestrutura e influenciar produto profundamente. Um fullstack cobre camadas técnicas. Product Engineer costuma participar mais diretamente da formulação da experiência, da escolha do que construir e da observação do uso. O handbook da PostHog, consultado em 27/09/2026, descreve essa prática dentro da PostHog; não estabelece uma definição universal nem prova que um cargo é superior.
| Papel | Contribuição típica ao problema de triagem | Decisão que deve ser combinada, não presumida |
|---|---|---|
| Software engineer | Segurança, integridade dos estados, APIs, operação | Quais trade-offs técnicos cabem na janela de entrega |
| Fullstack engineer | Fluxo completo entre interface, backend e dados | Onde simplificar sem ocultar falha no backend |
| Product Engineer | Liga problema, protótipo, instrumento de medida e iteração | Qual experimento técnico ajuda a aprender |
| Product Designer | Pesquisa e desenho da interação, compreensão de erros e carga cognitiva | Como o agente percebe, revisa e rejeita sugestões |
| Product Manager | Prioridade, valor, viabilidade e alinhamento de estratégia | Qual outcome merece recursos e quando parar |
| Growth engineer | Experimentos de aquisição, ativação ou expansão quando pertinentes | Se o funil é de fato o gargalo, com consentimento e medida adequados |
Uma pessoa pode cobrir mais de uma coluna em equipe pequena. Isso não torna dispensável a competência dos demais nem transfere autoridade por osmose. O modelo de Marty Cagan para equipes orientadas a outcome descreve colaboração entre produto, design e engenharia; o próprio autor avisa que sua nomenclatura não é padrão. Use o modelo para perguntar quem decide e quem responde pelas consequências, não para classificar pessoas como “menos produto”.
AI-native também precisa de duas camadas. Na primeira, IA ajuda a desenvolver: esboçar código, gerar variações de testes, resumir documentação. O engenheiro ainda define requisito, revisa diff, testa limites e assume operação. Na segunda, IA aparece na experiência do usuário: o DeskPilot pode sugerir uma categoria e um resumo. Nesse caso, os erros atingem o trabalho do agente e potencialmente o cliente final; revisão humana e validação pelo backend passam a integrar o produto. O relatório DORA 2025 sobre desenvolvimento assistido por IA, consultado em 27/09/2026, é contexto de pesquisa sobre adoção e efeitos organizacionais, não evidência de que este experimento funcionará ou de que um indivíduo será promovido.
DeskPilot é uma hipótese de triagem para equipes de suporte B2B, não um mercado validado. O usuário direto é o agente que lê o ticket, consulta contexto autorizado e decide se aceita a sugestão. O comprador potencial é o gestor de suporte, que precisa justificar custo, qualidade e integração com o fluxo da equipe. O afetado é o cliente final que espera encaminhamento e resposta. O mesmo atraso tem custos diferentes para cada um.
| Pessoa | Desejo provável a testar | Risco criado por uma solução apressada | Evidência que falta |
|---|---|---|---|
| Agente de suporte | Encontrar fila certa sem perder controle | Revisar sugestão opaca demora mais; automação reduz autonomia | Observação do fluxo, tempo por etapa, entrevistas autorizadas |
| Gestor de suporte | Reduzir espera e retrabalho sob custo previsível | Cobrança e manutenção superam benefício; métrica vira meta manipulável | Volumes, custo total, política de qualidade, critérios de piloto |
| Cliente final | Resolver demanda com precisão e privacidade | Ticket vai rápido à fila errada; dados sensíveis são expostos | Feedback consentido, reatribuições e amostra revisada |
“Provável” importa. Não entrevistamos essas pessoas. O mapa é uma lista de perguntas, não descoberta concluída. Velocidade pode conflitar com precisão: uma atribuição rápida e errada cria mais uma transferência. A autonomia do agente pode conflitar com padronização desejada pelo gestor. Mais contexto pode melhorar sugestão e, ao mesmo tempo, elevar custo de processamento e exposição de dados. O brief precisa mostrar essas tensões antes que uma demo elegante as esconda.
O recorte inicial também é uma escolha reversível: começar com uma única equipe de suporte B2B, um canal de entrada autorizado e tickets que possam ser tratados sem dados especialmente sensíveis. Não há tamanho de mercado conhecido. A alternativa atual ainda precisa ser observada; para o exercício assumimos uma fila manual como fixture de continuidade sintética, sujeita a correção após a primeira investigação. Se a equipe já usa regras eficientes, talvez não exista oportunidade para IA.
O brief é curto porque deve caber numa conversa com quem opera o suporte. Curto não significa vago. Uma versão concreta está em examples/product-brief.md; o mapa de interesses em examples/stakeholder-map.md; decisões e condições de revisão em examples/decision-log.md. Os arquivos usam dados sintéticos e um checker local. Nenhuma linha equivale a entrevista real.
| Campo | Versão inicial, sujeita a descoberta |
|---|---|
| Público | Usuário: agente de suporte B2B. Comprador potencial: gestor. Afetado: cliente final. |
| Situação | Ticket chega por canal autorizado; agente precisa determinar categoria e responsável. |
| Problema | Tempo até atribuição correta pode ser alto; frequência, causas e custo ainda não medidos. |
| Alternativa atual | Fila manual presumida para exercício. Verificar no fluxo real antes de desenhar produto. |
| Alternativa sem IA | Campos estruturados, categorias fixas, regras de encaminhamento e revisão humana. |
| Hipótese | Sugestão de categoria e resumo, revisada por agente, pode reduzir mediana do tempo sem elevar reatribuição ou dano ao cliente. |
| Evidência faltante | Volume por canal, timestamps confiáveis, regra de “correta”, baseline, entrevistas/observação autorizadas, taxa de reatribuição, custo por caso, política de dados. |
| Responsável final | Owner do piloto a designar com suporte e produto antes de usar dados reais; o autor do protótipo não se autonomeia. |
| Riscos | PII, sugestão incorreta, viés de aceitação, esforço de revisão, vazamento entre tenants, custo recorrente. |
| Não objetivos | Responder ao cliente automaticamente, mudar SLA, decidir prioridade, cobrar, implantar em produção ou alegar PMF. |
| Decisão reversível | Testar protótipo offline com fixtures; se piloto for aprovado, liberar sugestões somente para grupo consentido com desligamento imediato. |
Campos ausentes são falhas de decisão. Se o brief diz “usuário: suporte” e omite comprador/afetado, uma equipe pode otimizar segundos na interface enquanto transfere risco ao cliente. Se diz “usar IA” sem alternativa sem IA, não há comparação honesta. Se não nomeia owner, ninguém sabe quem interrompe o piloto quando surgem erros. O script examples/check-brief.mjs deve aceitar a fixture completa e rejeitar uma versão sem esses contratos. Ele verifica estrutura e separação entre hipótese e evidência; não valida se a hipótese é verdadeira, nem se alguém autorizou uso de dados. Consulte verification.md para comandos e resultado efetivamente executados.
Uma versão copiável do núcleo do brief pode ser esta. Os valores são hipóteses do tutorial:
Problema: tempo até atribuição correta possivelmente alto; baseline desconhecido.
Usuário: agente de suporte. Comprador potencial: gestor. Afetado: cliente final.
Sem IA: campos estruturados + regras de fila + revisão humana.
Com IA: categoria e resumo sugeridos; agente confirma ou rejeita.
Outcome: mediana do tempo até atribuição correta por ticket elegível.
Guardrails: proporção de reatribuições, erros graves e carga de revisão.
Evidência faltante: volume, timestamps, baseline, entrevistas e consentimento.
Owner: a designar com suporte e produto antes de piloto real.
Rollback: desativar sugestão; preservar fluxo manual e log mínimo redigido.
Mesmo esse bloco precisa de condições antes de virar teste. “Atribuição correta” deve ser definida por quem opera e auditada em amostra; ticket sem atribuição até o corte de observação continua no denominador de elegíveis e aparece na proporção de pendentes. A mediana descritiva dos tickets atribuídos usa apenas tempos observados e informa esse denominador menor; sozinha, pode parecer melhor quando casos difíceis seguem pendentes. Para decidir, a equipe deve acompanhar também a proporção corretamente atribuída até um prazo fixado antes do piloto, ou usar análise de tempo até evento com censura explícita. Falta saber se o timestamp registra chegada real ou importação atrasada, se tickets complexos se concentram num turno e se uma reatribuição é erro ou parte normal do atendimento. O brief obriga a nomear ignorância útil.
O primeiro incremento não precisa ser um chatbot. Para aprender se o brief captura o problema, bastam fixtures de tickets sintéticos, um fluxo manual descrito, exemplos de sugestões opcionais e um checker determinístico. Essa escolha economiza integração antes de saber se a dor existe. Ela também preserva uma alternativa sem IA capaz de ganhar no teste.
No toy offline, examples/check-brief.mjs lê o documento e falha se faltar papel, hipótese refutável, owner, alternativa sem IA, evidências ausentes ou rollback. Um teste negativo deliberado demonstra que o checker não aceita um brief ornamental. A implementação não mede tempo de atendimento. Isso é uma lacuna explícita, não um defeito escondido. Futuros incrementos podem usar TypeScript, Node.js LTS, PostgreSQL e interface web simples como stack didática, com versões fixadas na sessão que construir o app. Escolher essas ferramentas hoje não valida a oportunidade.
Num piloto autorizado, o contrato seria mais exigente. Regras determinísticas do backend controlariam tenant, autorização, SLA, estados e atribuição. IA apenas sugeriria categoria e resumo com base em texto permitido. O agente veria a origem, poderia corrigir ou rejeitar e confirmaria a ação. O backend validaria qualquer comando, independentemente do que a interface ou modelo disser. Não haveria resposta externa automática, cobrança real nem deleção de dados de terceiros. PII seria minimizada; logs, redigidos; retenção e acesso, aprovados antes de ingestão. Um prompt não é controle de isolamento entre tenants.
Cada efeito precisa de dono, permissão, evidência e reversão. Alterar categoria exige permissão do agente, evento auditável sem texto sensível e retorno ao valor anterior quando viável. Abrir um piloto exige consentimento da organização, owner operacional e botão de desligamento. Mesmo uma interface “somente sugestão” tem efeito: pode induzir decisão errada. A pessoa que opera precisa poder perceber incerteza e manter o caminho manual.
Não temos evidência de que uma arquitetura com modelo seja necessária. Primeiro, compare uma taxonomia simples e campos melhores com o fluxo atual. Se a maior parte do atraso vier de falta de agente disponível, nenhuma classificação automática resolve o gargalo. Se o problema estiver na definição de filas, melhorar a regra pode superar o modelo com menor custo e risco. Essa possibilidade deve permanecer aberta até observarmos o trabalho.
Uma equipe de tickets recebe demandas fechadas. Uma equipe de produto tende a receber um problema e negociar solução. A distinção ajuda, mas organizações reais misturam os dois modos. É possível começar discovery em uma equipe de tickets sem fingir que recebeu mandato para mudar política, falar com clientes ou gastar orçamento.
Na equipe de tickets, proponha uma conversa curta com quem prioriza e quem opera suporte: “Posso gastar uma janela definida para mapear fluxo e comparar uma alternativa sem IA antes de estimar o chatbot? Preciso de acesso supervisionado a agentes, sem dados sensíveis, e retorno na sexta. Trago brief e incertezas; a decisão de prioridade continua com você.” O acordo deve registrar tempo de investigação, pessoas autorizadas, dados permitidos, limite de gasto, decisão que você pode tomar sozinho e quem aprova piloto. Se não houver acesso a usuários, trabalhe com fluxo documentado e marque a evidência como ausente. Não substitua entrevista por imaginação.
Na equipe de produto, PM, designer, engenharia e suporte podem formular juntos a hipótese e os guardrails. Engenharia pode decidir implementação reversível e viabilidade; design, como agente identifica e corrige erro; PM, prioridade e coerência com estratégia; suporte, adequação à operação e escalonamento. O owner do piloto responde pelo go/no-go depois de ouvir essas perspectivas. O contrato não deve diluir responsabilidade até ninguém poder interromper o experimento. Em ambos os contextos, combine uma agenda de feedback: revisão do brief antes de construir, observação após cada rodada, decisão escrita de continuar, alterar ou parar.
Um contrato mínimo de autonomia responde: qual problema podemos investigar; quais dados e usuários podemos acessar; quais decisões são nossas; quais exigem aprovação; que efeito está proibido; quem decide conflito; em que data revisitamos. Ele protege tanto a equipe quanto o engenheiro. “Seja mais dono” sem essas respostas geralmente aumenta cobrança sem ampliar capacidade de agir.
Sintoma: alguém recebe o título de Product Engineer, mas só descobre demandas após priorização e não pode conversar com suporte. Causa: mudança de nomenclatura sem contrato de acesso, decisão e responsabilidade. Resposta: negociar uma pequena janela de descoberta, um interlocutor operacional e um limite claro de decisão. Registre recusas e alternativas. Se a organização não autorizar, avalie trabalho dentro da fronteira disponível; não assuma resultados fora dela. O custo para o usuário é uma interface construída a partir de suposições que ninguém pode corrigir.
Sintoma: time compara modelos e custos de tokens antes de observar por que tickets aguardam. Causa: demo de tecnologia vira definição de problema. Resposta: mapear fluxo e baseline, testar formulário/regras e descrever condição em que IA seria melhor. Talvez a espera seja causada por escala de trabalho ou política de fila. Se for, classificador nenhum a remove. Para o cliente final, automação irrelevante pode tornar a experiência mais opaca.
Sintoma: “100% dos tickets classificados” vira sucesso, mesmo com mais reatribuições. Causa: output é barato de contar; correção e efeito adverso exigem observação. Resposta: separar contrato técnico, adoção e outcome no painel; definir denominador e guardrails antes do piloto; revisar amostra de erros. A equipe pode concluir que o protótipo funciona tecnicamente e que não melhorou serviço. Essa conclusão evita custo recorrente desnecessário.
Sintoma: engenharia muda categorias e fluxo sem envolver agentes, gestor, design, privacidade ou quem atende reclamações. Causa: “ownership” interpretado como licença para absorver a decisão alheia. Resposta: mapear afetados, pedir revisão antes do efeito, nomear owner final e canal de escalonamento. Uma sugestão incorreta afeta agente e cliente; uma retenção longa afeta risco da empresa; uma nova taxa afeta comprador. Ouvir não elimina discordância, mas torna trade-offs visíveis.
Antes de medir benefício, defina unidade (ticket elegível), denominador (todos os tickets elegíveis recebidos no canal e janela), corte de observação (prazo fixo após chegada para cada ticket), método (eventos de chegada, primeira atribuição, confirmação/correção por amostra), segmentos (tipo e complexidade) e limites (sazonalidade, diferença entre agentes, registros ausentes). Registre quantos continuaram sem atribuição correta no corte; reporte sua proporção sobre todos os elegíveis. A mediana dos tempos concluídos usa somente tickets com evento observado e declara quantos entraram nesse cálculo. Registre custo de revisão do agente e casos em que a sugestão foi ignorada. Sem essas duas leituras, uma mediana menor pode refletir tickets mais fáceis.
Compare três condições quando viável: fluxo atual observado, alternativa sem IA e sugestão com IA mais revisão. Uma comparação sequencial pequena pode ensinar, mas não controla todas as diferenças. Não chame correlação de causalidade. Defina, antes, que evidência faria parar: erros de atribuição relevantes, exposição de dados, queda de confiança dos agentes, custo total incompatível ou ausência de melhora após janela suficiente. A meta didática provisória de 20% em duas semanas no brief não é critério aprovado; limiares operacionais exigem baseline e acordo local.
Para o brief offline, o critério é menor: os arquivos existem, a fixture válida passa, a incompleta falha, e não há campos que apresentem hipótese como evidência. Esse teste demonstra disciplina de decisão, não valor comercial. O passo seguinte é observar algumas interações autorizadas e atualizar o documento, inclusive se o problema inicial estiver errado.
O custo de uma sugestão inclui integração, processamento, revisão humana, monitoramento, incidentes, treinamento e oportunidade perdida. A alternativa sem IA tem custo de manutenção das regras, mas pode ser mais barata e previsível. Estime com dados locais; não publique retorno financeiro derivado de fixture. A decisão de continuar deve considerar o serviço prestado ao cliente, não apenas preço por chamada.
Tickets podem conter nomes, contratos, senhas ou detalhes de negócio. Mesmo uma prova de conceito deve usar dados sintéticos até existir base autorizada para tratamento. Para piloto real: minimizar texto enviado, restringir tenant e papéis no backend, redigir logs, estabelecer retenção, consentimento e procedimento de exclusão com responsáveis. Não alegamos certificação ou conformidade legal. A revisão de jurídico/privacidade pertence a quem tem essa função. Se um provedor externo for considerado, documente fluxo de dados e contrato antes do envio.
Reversibilidade é funcionalidade: manter o fluxo manual; habilitar a sugestão por grupo; desativá-la sem quebrar estados; preservar evidência mínima para investigar erro; evitar migração que obrigue todos a usar modelo. O custo de voltar deve caber na mesma reunião que aprovou avançar. Uma feature que só pode ser desligada por deploy arriscado reduz autonomia operacional justamente quando mais importa.
verification.md?Básico — reescreva um ticket. Pegue “adicionar chatbot” e produza duas frases: problema observável e hipótese refutável. Inclua usuário, medida e um guardrail. Critério: uma pessoa de suporte consegue dizer que observação refutaria a proposta. Solução comentada: “Atribuições podem demorar porque agentes precisam interpretar texto livre; vamos comparar mediana até atribuição correta e reatribuições com fluxo atual.” Ainda falta baseline; isso é honestidade, não incompletude a esconder.
Intermediário — negocie autonomia. Escreva um pedido de 30 minutos de observação autorizada, uma janela de revisão do brief e uma lista de decisões reservadas ao owner. Critério: quem recebe sabe exatamente que tempo, dados e pessoas seriam envolvidos, e pode aceitar uma parte sem aceitar o piloto. Solução comentada: pedir acesso supervisionado a uma fila sem dados sensíveis para observar etapas, devolver achados até sexta e deixar mudança de SLA, gasto e implantação com responsáveis existentes. Se o acesso for negado, registrar lacuna e trabalhar com documentação.
Avançado — desenhe a comparação. Defina eventos, denominador, três condições e regra de parada para DeskPilot. Critério: tickets sem atribuição não somem; erros têm severidade; diferença de complexidade é relatada; nenhuma porcentagem fictícia aparece. Solução comentada: registrar chegada, atribuição, confirmação e reatribuição; comparar baseline observado, formulário/regras e sugestão revisada em janelas acordadas; segmentar por tipo; parar diante de exposição de dados ou erro grave. Aceitação da sugestão é diagnóstico, não outcome.
Outcome é mudança observada para usuário ou negócio, com efeitos adversos considerados. Output é entrega produzida. Baseline é medida do fluxo existente, com método e janela. Guardrail é indicador ou limite que evita otimizar uma medida à custa de dano. Tenant é a fronteira de dados de uma organização numa aplicação compartilhada. Rollback é o procedimento de voltar ao estado seguro, não a esperança de que nada falhe.
O primeiro resultado do Product Engineer aqui não é código impressionante: é uma decisão que pode ser negada com evidência. O DeskPilot saiu do ponto zero com um problema candidato, pessoas distintas, comparação possível e limites escritos. Ainda faltam clientes, entrevistas e baseline. No capítulo 02 previsto desta série, a próxima tarefa será verificar quem sofre a demora, como trabalha hoje e se esse recorte merece um produto. Até lá, o brief deve permanecer v0.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis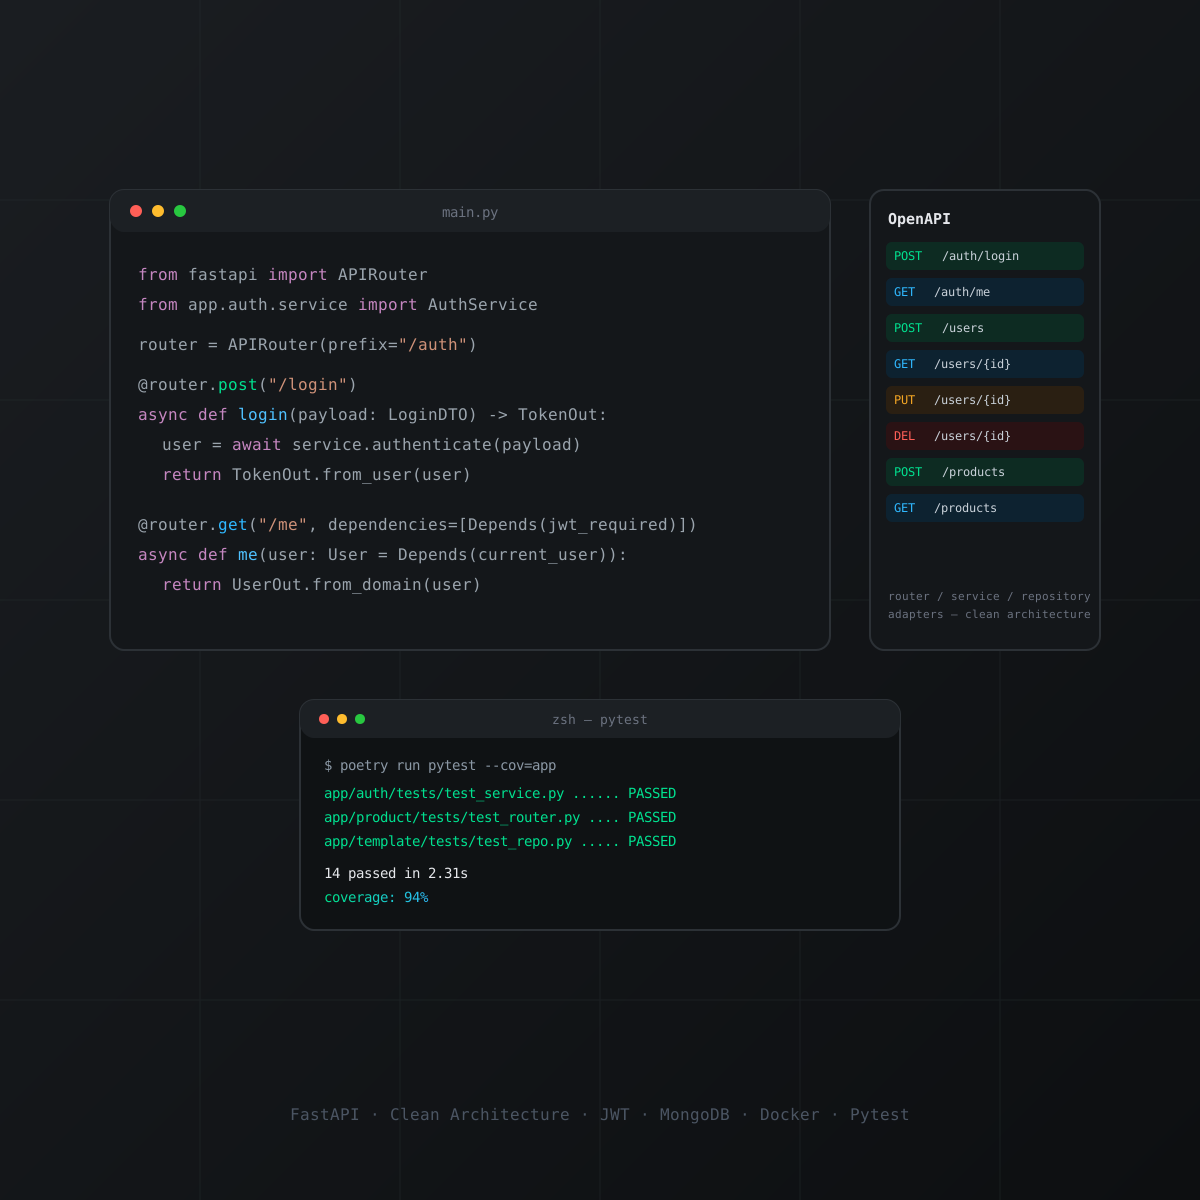
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto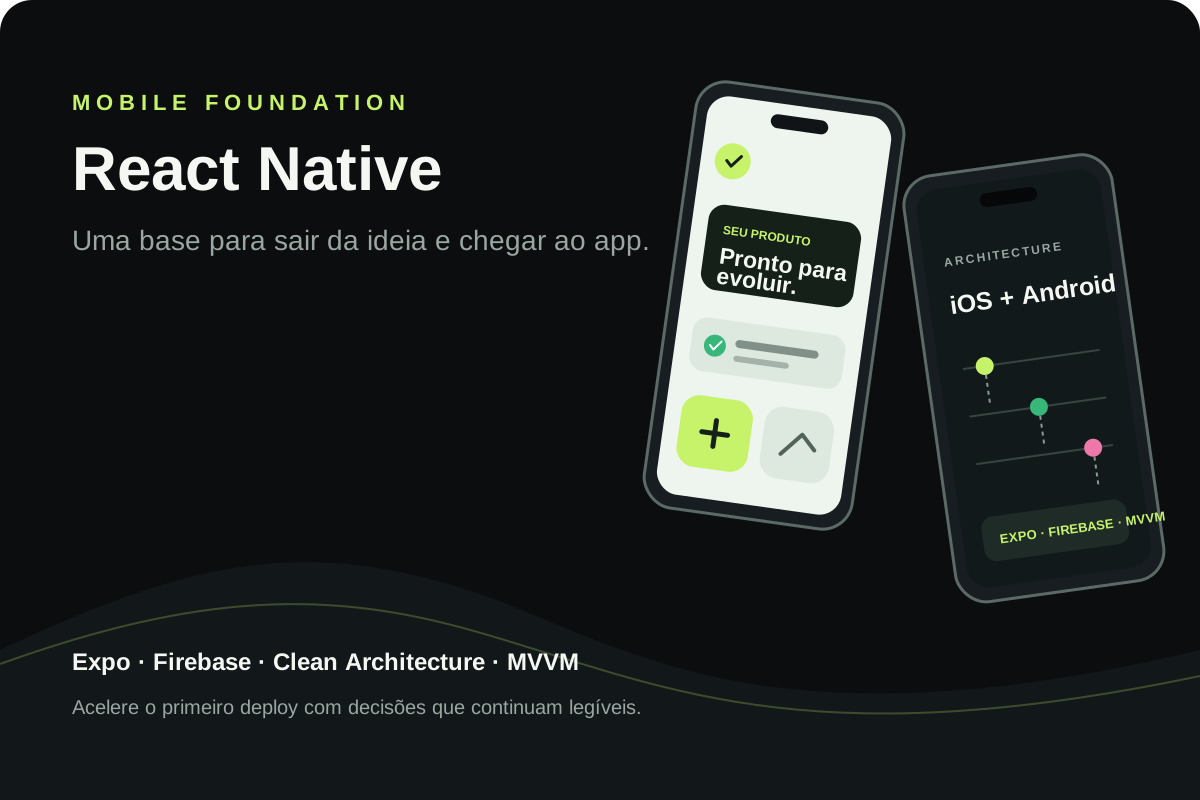
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Um roteiro de entrevistas, uma árvore de oportunidades e um teste de disposição a pagar para decidir se o DeskPilot merece ser construído, usando apenas evidência sintética rotulada.

Uma demo de triagem impecável, gravada numa sexta-feira, evapora na segunda: nada tinha sido persistido. A partir desse incidente, uma fatia vertical completa do DeskPilot — importar, revisar,…
An interview guide, an opportunity solution tree, and a willingness-to-pay test to decide whether DeskPilot deserves to be built, using only labeled synthetic evidence.
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.