
Anderson LimaSoftware Engineer & Consultant
4 de outubro de 2026
16 min de leitura
6 visualizações
English summary: The “death of the senior developer” is better understood as the end of a narrow definition of seniority. This operational guide explains how senior engineers can work with AI agents while keeping human ownership, review, incident response, and measurable evidence.
Published: January 2026
Reading time: 15 minutes
Keywords: #EngenhariaSênior #AgentesDeIA #ArquiteturaDeSoftware #CodeReview #RespostaAIncidentes
Slug: death-of-senior-dev-done
Se um agente consegue produzir um rascunho de código em segundos, a provocação do título deixa de ser “a IA vai acabar com o desenvolvedor sênior?” e passa a ser: qual trabalho continua exigindo julgamento, contexto e responsabilidade?
O desenvolvedor sênior não desaparece quando a implementação fica mais barata. O que muda é a unidade de valor: escrever código continua importante, mas já não é uma evidência suficiente de senioridade. O trabalho sênior passa a incluir a definição do problema, o desenho das restrições, a escolha do nível de autonomia, a revisão da solução e a responsabilidade pelo comportamento do sistema em produção.
Este é um guia operacional, não um manifesto de substituição. “Arquiteto de IA” pode descrever uma capacidade útil; não precisa ser um novo cargo, nem uma licença para retirar pessoas das decisões difíceis.
O manifesto legado acertava ao desafiar uma definição estreita de senioridade baseada em sintaxe, memória de APIs e volume de código. Mas exagerava ao tratar a mudança como uma extinção: frameworks continuam exigindo conhecimento, código gerado ainda precisa ser entendido e nem todo problema se beneficia de um agente.
A distinção mais útil é entre um workflow com passos definidos e um agente que escolhe dinamicamente os próximos passos. A recomendação da Anthropic em “Building Effective Agents” é começar pela solução mais simples e aumentar a complexidade somente quando houver uma necessidade demonstrável. Um script, uma busca bem feita ou uma revisão humana curta podem ser melhores do que um loop autônomo.
Também não há base para prometer ganho universal de produtividade. Um experimento randomizado da METR, publicado em julho de 2025, observou 16 desenvolvedores experientes em 246 tarefas de repositórios que conheciam e encontrou aumento médio de 19% no tempo quando as ferramentas de IA do período foram permitidas. O resultado é uma fotografia de um contexto específico, não uma lei sobre toda IA: a própria METR passou a atualizar o desenho do experimento e alertou para limitações de interpretação em 2026, como descrito em seu relato de atualização.
A conclusão prática é menos dramática e mais útil: agentes precisam de avaliação local. A pergunta não é se a ferramenta parece rápida, mas se o fluxo entrega melhor resultado depois de contar revisão, retrabalho, incidentes e tempo de coordenação.
“Implemente a feature” não informa objetivo, invariantes, dados sensíveis, compatibilidade, critérios de aceite ou o que está fora do escopo. Um agente pode preencher as lacunas com uma solução plausível e ainda assim errar o produto.
O contrato mínimo deve registrar objetivo, entradas, saídas, restrições, evidências esperadas e condição de parada. Se o time não consegue revisar esse contrato, também não consegue revisar a delegação.
Dar acesso ao repositório, ao banco ou à produção não cria responsabilidade. Só aumenta o raio de impacto de uma decisão mal compreendida. O agente pode operar uma ferramenta; uma pessoa ou um time precisa responder pela autorização, pelo resultado e pela reversão.
Um diff pequeno pode alterar autorização, cobrança ou migração de dados. Um diff grande pode apenas atualizar código gerado com testes fortes. Linhas produzidas, tokens consumidos e quantidade de arquivos não são métricas de qualidade.
Revisão sênior pergunta: a mudança implementa a intenção correta? preserva invariantes? expõe dados? é observável? pode ser revertida? O status verde dos testes é evidência importante, mas não responde a todas essas perguntas.
Um agente pode repetir uma chamada, interpretar uma resposta errada como sucesso ou continuar depois que o contexto mudou. Conceder autonomia sem limite de tempo, orçamento, escopo e aprovação transforma um fluxo assistido em uma superfície operacional difícil de controlar.
Antes de automatizar, defina o que o sistema pode fazer, o que precisa de aprovação e como interromper e desfazer a ação.
A mudança não é trocar “codar” por “escrever prompts”. É mover parte do trabalho para as bordas que tornam a implementação confiável.
| Camada | Pergunta do trabalho sênior | Evidência esperada |
|---|---|---|
| Problema | Qual resultado merece ser perseguido? | objetivo, usuário afetado e critério de sucesso |
| Arquitetura | Quais limites não podem ser violados? | ADR, invariantes, contratos e trade-offs |
| Contexto | O agente recebeu informação suficiente e segura? | fontes, escopo, versão e classificação de dados |
| Implementação | O patch é correto, legível e compatível? | diff, testes, análise estática e revisão |
| Operação | Como detectamos e revertemos uma falha? | métricas, logs, alerta e procedimento de rollback |
| Aprendizado | Como o próximo ciclo fica melhor? | incidente, avaliação, ajuste de regra ou de ferramenta |
O profissional experiente ainda precisa saber implementar. A diferença é que sua contribuição não termina quando o código compila: ela inclui tornar a decisão compreensível, verificável e sustentável por outras pessoas.
Algumas tarefas podem ser delegadas; a prestação de contas não é transferida para o modelo.
O objetivo não é proteger cada linha de código como se fosse artesanal. É garantir que decisões irreversíveis, ambíguas ou de alto impacto tenham um responsável identificável.
Um agente confiável não é apenas um modelo com um prompt maior. É um componente dentro de um harness — o conjunto de contexto, ferramentas, permissões, ambiente, verificação e observabilidade que limita e avalia sua atuação.
Forneça o objetivo, os arquivos relevantes, contratos, decisões arquiteturais, regras de segurança, exemplos válidos e critérios de sucesso. Contexto demais aumenta ruído; contexto de menos incentiva suposições. Registre a fonte e a versão dos documentos importantes.
Comece com leitura, busca e testes. Adicione escrita, abertura de pull request, acesso a serviços ou chamadas externas somente quando o caso justificar. Uma integração MCP pode organizar a superfície de ferramentas, mas não substitui autorização, isolamento ou revisão.
Use menor privilégio: repositório e diretório delimitados, credenciais separadas, comandos permitidos explicitamente e aprovação antes de efeitos externos. O padrão deve ser negar produção e dados sensíveis, não presumir que o agente sabe quando parar.
Prefira sandbox ou staging com dependências reproduzíveis e dados não sensíveis. A mesma mudança que parece segura em um repositório vazio pode ter outro risco em um monólito antigo ou em um sistema com migrações irreversíveis.
Defina o conjunto de evidências antes da execução: testes unitários, integração, tipos, lint, contratos, análise de segurança, avaliação de comportamento ou inspeção manual. “O agente disse que passou” não é evidência; o comando e o resultado observável são.
Guarde um identificador de execução, objetivo, ferramentas chamadas, mudanças propostas, falhas, aprovações, versões relevantes e resultado final. O registro deve ser suficiente para reproduzir a decisão sem armazenar segredos ou dados que o time não precisa reter.
O guia prático da OpenAI para agentes trata guardrails em camadas e intervenção humana como partes da operação, especialmente no início da implantação e em ações de maior risco. Isso é uma boa regra de engenharia mesmo quando o fornecedor do modelo é outro.
O exemplo abaixo não chama um modelo. Ele mostra uma fronteira que qualquer agente deve respeitar: proposta sem dono, evidência ou aprovação adequada não avança. Salve como decision-gate.mjs e execute com node decision-gate.mjs.
const proposal = {
  risk: "medium",
  touchesProduction: false,
  testsPassed: true,
  evidence: ["unit", "typecheck"],
  owner: "team-payments",
};

function decide(change) {
  if (!change.owner) {
    return { status: "stop", reason: "missing owner" };
  }

  if (change.touchesProduction || change.risk === "high") {
    return { status: "human_review", reason: "high-impact change" };
  }

  if (!change.testsPassed || change.evidence.length === 0) {
    return { status: "stop", reason: "missing verification" };
  }

  return { status: "ready_for_review", reason: "minimum evidence present" };
}

console.log(decide(proposal));
O resultado esperado é ready_for_review. O gate não prova segurança, correção de negócio ou qualidade de arquitetura; ele apenas impede que requisitos mínimos fiquem implícitos. Em produção, substitua os booleanos por verificações reais e mantenha a decisão final com o revisor responsável.
| Artefato ou decisão | Agente pode fazer | Dono humano | Gate de aceitação |
|---|---|---|---|
| Objetivo e critérios de aceite | organizar perguntas e apontar lacunas | product owner e tech lead | intenção aprovada antes do patch |
| Desenho e trade-offs | propor alternativas e riscos | senior/staff engineer | ADR ou decisão registrada |
| Patch de código | implementar em escopo limitado | autor e owner do componente | diff revisado e testes executados |
| Segurança e dados | localizar padrões suspeitos | security/data owner | política e revisão de risco |
| Merge e release | preparar a mudança | revisor e release owner | checks verdes e aprovação explícita |
| Operação | sugerir diagnóstico e mitigação | on-call e incident commander | ação reversível e comunicação |
Uma revisão eficaz separa pelo menos seis perguntas:
O agente pode preparar a revisão, resumir o diff e sugerir testes. Ele não deve ser o único aprovador de uma mudança que afeta usuários, dinheiro, segurança ou disponibilidade.
O desenho da automação deve incluir o dia em que ela falhar. Um procedimento simples para um incidente envolvendo agente é:
Esse fluxo segue a lógica operacional de gerenciamento de incidentes do Google SRE e de postmortems sem culpabilização: restaurar o serviço é apenas uma parte; o sistema precisa aprender com a falha.
Use a opção menos autônoma que resolva o problema. A autonomia é uma consequência de evidência, não o objetivo inicial.
| Situação | Arquitetura preferida | Autonomia inicial | Gate humano | Evidência mínima |
|---|---|---|---|---|
| Formatação, geração de arquivo ou transformação previsível | script ou workflow determinístico | alta após testes | revisão por amostragem | saída idêntica ao contrato |
| Patch pequeno e de baixo risco | agente único com ferramentas limitadas | preparar diff, sem merge | owner revisa intenção e diff | testes, tipos e inspeção |
| Bug ambíguo em código conhecido | agente de investigação em modo leitura | explorar e propor hipóteses | senior escolhe diagnóstico e patch | reprodução, hipótese testada e logs |
| Mudança em vários serviços sem efeito imediato | workflow com etapas explícitas | executar somente em sandbox | aprovação entre etapas | contratos, integração e plano de rollback |
| Produção, cobrança, dados pessoais ou segurança | pessoa conduzindo com agente assistivo | leitura e simulação | aprovação explícita antes do efeito | evidência técnica, risco e reversibilidade |
| Tarefa aberta com decisões de caminho | agente com orçamento e parada | limitada por passos, tempo e escopo | revisão periódica | evals de sucesso, falha e escalonamento |
| Paralelismo entre domínios realmente independentes | multiagente ou workers especializados | somente após baseline | owner do orquestrador | ganho medido maior que custo de coordenação |
Se os passos são conhecidos, um workflow costuma ser mais fácil de testar. Se o caminho depende de investigação em um ambiente variável, um agente pode ajudar. Se a consequência é irreversível ou regulada, mantenha a decisão com uma pessoa e use a IA para reduzir trabalho preparatório.
Não comece com “autonomia total”. Suba a escada somente quando a etapa anterior tiver dono e evidência.
Escolha uma tarefa repetitiva e observável, como classificar falhas de testes ou preparar um resumo de mudança. Meça como o time trabalha hoje, incluindo retrabalho.
Escreva objetivo, entradas, saídas, limites, dados proibidos, critérios de sucesso e condição de parada. O owner do resultado aprova esse contrato.
Transforme o contrato em instruções reutilizáveis: contexto necessário, passos, exemplos, anti-exemplos, ferramentas permitidas e formato da evidência. Atualize a skill quando uma falha se repetir.
Dê a um agente uma tarefa delimitada, começando em modo leitura ou com patch local. Registre suas hipóteses e faça a entrega terminar em revisão, não em merge silencioso.
Conecte verificações automáticas e ferramentas externas apenas quando elas tiverem uma interface clara, permissões mínimas e logs. Um hook pode bloquear uma condição; um servidor MCP pode expor uma operação; nenhum dos dois define sozinho quem aprova o risco.
Defina orçamento de passos, tempo, chamadas, arquivos alteráveis e tentativas. Exija aprovação para efeitos externos e uma parada automática para repetição, incerteza ou falha de verificação.
Monte casos reais, casos adversariais, regressões e critérios de escalonamento humano. Compare com o baseline: qualidade, tempo total, rework, incidentes, custo e satisfação do usuário. Se a avaliação não detectar uma falha conhecida, o sistema ainda não está pronto para mais autonomia.
O sucesso de um fluxo agentivo não é a quantidade de código produzido nem o número de chamadas ao modelo. Escolha uma métrica de resultado e algumas métricas de risco:
Meça antes e depois no mesmo tipo de tarefa, documente o período e separe percepção de resultado observado. Se o agente economiza dez minutos de digitação, mas cria uma hora de revisão insegura, a unidade correta é o fluxo inteiro.
Também existem limites legítimos: contexto confidencial pode não ser apropriado para um provedor externo; uma política regulatória pode exigir aprovação humana; um sistema crítico pode não tolerar tentativa e erro; e uma tarefa simples pode ser resolvida mais barato por um script. Recusar autonomia é uma decisão de arquitetura, não um fracasso de adoção.
A provocação permanece: se “sênior” significava apenas digitar implementação com mais velocidade, essa definição perdeu força. Mas a profissão não termina aí. O trabalho sênior se desloca para formular problemas, desenhar restrições, escolher arquiteturas, revisar comportamento, proteger usuários, operar sistemas e desenvolver outras pessoas.
Agentes podem ampliar esse trabalho quando têm contexto, limites e feedback. Também podem aumentar o custo de coordenação quando são adicionados sem um problema claro. A pergunta operacional não é “como faço a IA fazer tudo?”, e sim: qual decisão estou delegando, qual evidência exigirei e quem responderá se o resultado estiver errado?
É nesse ponto que o “arquiteto de IA” deixa de ser um slogan. Ele é, na prática, o engenheiro sênior que trata agentes como componentes de um sistema: úteis, observáveis, limitados e sempre subordinados a ownership humano claro.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto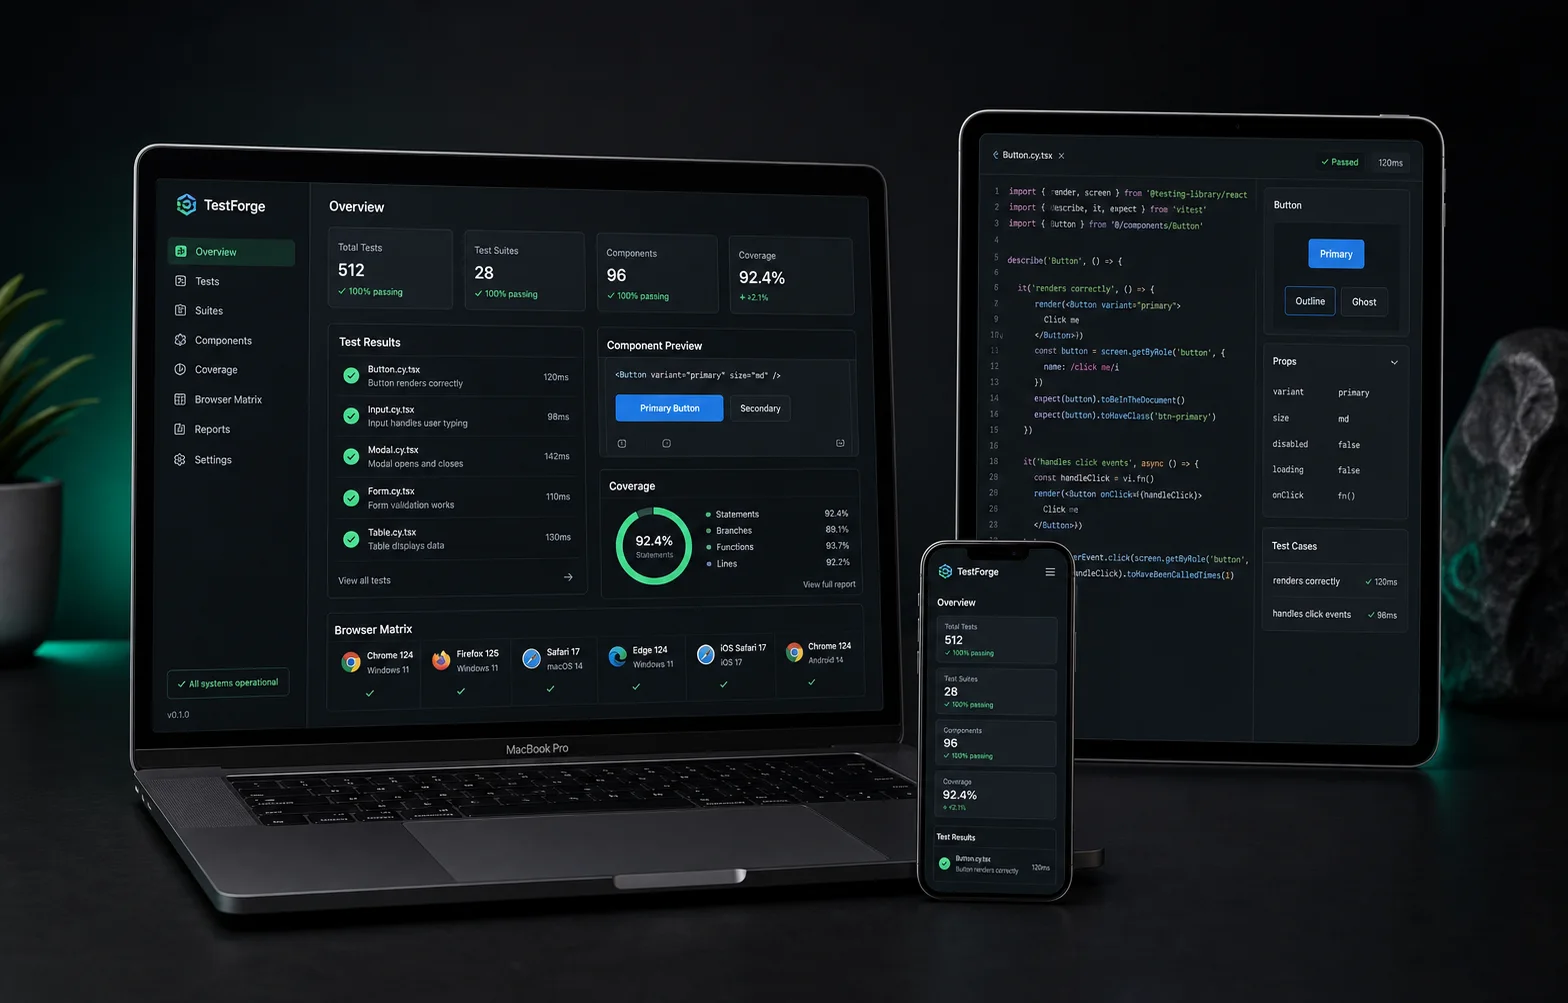
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
React nasceu para resolver a camada de interface, não para definir a aplicação inteira. Isso explica o surgimento de Next.js, Remix, Vite e todo o ecossistema em volta do React. Este artigo mostra por que essa distinção entre biblioteca e framework continua relevante, quais trade-offs ela cria e quando faz sentido usar React puro ou um meta-framework.
# Monólito Modular vs. Microsserviços: Como Escolher sem Pagar Cedo pela Distribuição English summary: A practical comparison of modular monoliths and microservices, with module
# Por Que Seus Agentes de IA Continuam Falhando (E Como Consertar) Você gastou 3 meses construindo agentes de IA. Funcionaram lindamente nas demos. Em produção, são um desastre. A
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.