Anderson LimaSoftware Engineer & Architect
4 de outubro de 2026
17 min de leitura
242 visualizações
Um manifesto operacional para engenharia com IA
English summary: AI-native teams redesign how work crosses boundaries: context, decision rights, evaluation, and human accountability become explicit so autonomy can grow without hiding risk.
Published: July 2026
Reading time: 16 minutes
Keywords: #AINative #EngineeringLeadership #SoftwareEngineering #TeamDesign #Evals
Na segunda semana após liberar um assistente de código, a equipe já entrega mais rápido — e não consegue explicar por quê. Tickets continuam ambíguos. O contexto está em conversas privadas. Pull requests cresceram. A revisão virou uma fila de pessoas tentando detectar, por intuição, o que a máquina pode ter entendido errado.
A tensão é esta: aumentar a autonomia antes de redesenhar o trabalho não elimina coordenação; só esconde seu custo em retrabalho, decisões sem dono e incidentes difíceis de explicar.
Tese: uma equipe AI-native não é uma equipe com mais agentes. É uma equipe em que contexto, limites, evidência e direito de decidir são explícitos o suficiente para delegar trabalho sem delegar a responsabilidade humana.
Isso não supõe que pessoas “sumiram” do processo. Pelo contrário: muda onde o julgamento humano é mais valioso. Menos tempo procurando convenções implícitas ou aprovando tarefas mecânicas; mais tempo definindo o problema, questionando premissas, decidindo exceções e cuidando do sistema sociotécnico que torna o trabalho confiável.
Antes de discutir plataforma, modelo ou organograma, rode este ritual em uma tarefa pequena e reversível. Um bug com teste reproduzível é melhor que uma migração ou uma iniciativa estratégica.
Copie este cartão para a issue ou para o início do PR:
## Cartão de delegação

**Resultado observável:** sessão expirada retorna 401 sem executar o handler.
**Fontes autorizadas:** `docs/auth.md`, `src/auth/`, `tests/auth/`.
**Não mudar:** contrato público de `signToken`; dados de produção; dependências.
**Autonomia:** pode ler, testar e editar a branch; não pode fazer merge ou deploy.
**Decisão e revisão:** Ana decide ambiguidade de produto; Bruno revisa segurança.
**Evidência de pronto:** testes de válido, expirado e malformado passam; diff pequeno; CI verde.
**Pare e escale se:** a documentação divergir, o contrato público mudar ou o teste exigir dado real.
Esse ritual parece burocracia quando a tarefa é trivial. Na prática, ele substitui burocracia tardia: uma hora de revisão, uma conversa de “mas eu achei que…” e um rollback que ninguém havia previsto. Também produz um artefato que ajuda a próxima pessoa, humana ou não, a começar com menos adivinhação.
IA assistida, aumentada e nativa não são sinônimos.
| Estágio | Prática observável | Onde a decisão mora | Risco característico |
|---|---|---|---|
| AI-assisted | Pessoa usa autocomplete, busca ou rascunho | No indivíduo | Aceitar sugestão sem compreender efeito |
| AI-augmented | Modelo prepara testes, refactor ou PR dentro do fluxo existente | No time, com gates manuais | Revisão recebe diffs grandes e pouco explicados |
| AI-native | O trabalho tem contrato de contexto, eval, política de autonomia e dono | Em interfaces explícitas do sistema de trabalho | Automatizar além da evidência disponível |
AI-native não é uma identidade para anunciar. É uma propriedade de um fluxo. Um time pode ter autonomia governada para corrigir testes e ainda exigir controle estrito para pagamentos. Essa desigualdade é saudável: autonomia não é um prêmio; é uma decisão de risco.
O que permanece é a obrigação de engenharia: entender o sistema, proteger usuários, manter software e responder por consequências. O que muda é que a equipe passa a projetar como esse entendimento atravessa pessoas, ferramentas, agentes e turnos de trabalho.
Um prompt bem escrito não compensa uma organização em que a decisão certa está espalhada entre Slack, memória de uma pessoa e uma planilha sem dono. Contexto útil não é despejar documentos no modelo; é declarar qual fonte tem autoridade, qual está fresca e o que fazer quando elas discordam.
A Anthropic trata context engineering como a curadoria contínua da informação disponível para o agente, não apenas a redação de instruções.[^1] Para equipes, a consequência é simples: contexto é uma interface mantida, como uma API. Tem consumidor, dono, versão e comportamento de erro.
Uma boa interface de contexto responde a cinco perguntas:
O menor conjunto de informação de alto sinal costuma vencer um “prompt enciclopédia”. Contexto demais também eleva carga cognitiva: o revisor precisa separar o que é regra, histórico, hipótese e ruído; o agente recebe mais oportunidades de combinar instruções conflitantes. A solução não é esconder complexidade. É indexá-la, preservar links para a fonte e carregar detalhes quando a tarefa pede.
Imagine uma pessoa nova, competente, que pode ler repositórios e executar comandos, mas não conhece os acordos não escritos da equipe. Você não a torna confiável entregando acesso irrestrito e dizendo “use bom senso”. Você oferece um objetivo, exemplos canônicos, ferramentas com escopo, um par para revisão e uma forma segura de dizer “não sei”.
É a mesma disciplina necessária para sistemas com IA — sem reduzir pessoas a modelos. A analogia serve para expor a lacuna: se a nova pessoa só consegue agir porque alguém experiente fica por perto o tempo todo, a equipe ainda não construiu uma interface de trabalho; construiu dependência.
Segurança psicológica entra aqui como requisito operacional. Uma equipe que pune quem interrompe uma tarefa para apontar contexto ausente cria o comportamento mais perigoso: aparentar certeza. “Não sei qual contrato vale” deve disparar ajuda e decisão, não constrangimento. Isso protege a qualidade do sistema e reduz a carga mental de ter de parecer autossuficiente.
Um experimento de brinquedo pode usar um prompt, um repositório pequeno e uma demonstração manual. Ele é útil para aprender onde o modelo ajuda. Não é prova de que um fluxo está pronto para produção.
| Elemento | Brinquedo | Produção |
|---|---|---|
| Contexto | Um exemplo escolhido a dedo | Fontes versionadas, frescor e tratamento de conflito |
| Ferramentas | Acesso amplo em ambiente descartável | Privilégio mínimo, sandbox, logs e revogação |
| Qualidade | Demonstração que parece correta | Evals de capacidade e regressão, amostras e investigação de falhas |
| Decisão | Uma pessoa acompanha tudo | Rights explícitos, revisão proporcional e caminho de escalonamento |
| Falha | Recomeçar é barato | Rollback, comunicação, incidente e correção do processo |
O salto entre as colunas não é comprar um modelo melhor. É construir o harness ao redor: contexto, ferramentas, permissões, ambiente, verificação e observabilidade. Nas definições da Anthropic, a avaliação mede o agente junto de seu harness, porque ferramentas e ambiente alteram o comportamento tanto quanto o modelo.[^2]
Uma mesma pessoa pode ocupar vários papéis em um time pequeno. O erro é deixar esses papéis invisíveis.
| Papel | Decide ou mantém | Interface com o resto do time |
|---|---|---|
| Dono do resultado | problema, impacto e critério de aceite | aprova o cartão de delegação e exceções de escopo |
| Dono do contexto | fontes, decisões e data de validade | publica fontes autorizadas e conflitos conhecidos |
| Dono do eval | casos, grader e análise de falha | transforma falhas recorrentes em regressões |
| Executor | plano, execução e registro de evidência | apresenta diff, limites encontrados e incertezas |
| Revisor/owner do sistema | risco técnico, segurança, dados e rollback | aprova mudanças na sua zona de responsabilidade |
| Líder de engenharia | política, capacidade e trade-offs entre fluxos | protege tempo para manter contexto, evals e aprendizagem |
O agente não ocupa nenhuma dessas cadeiras. Ele pode ser um executor de ação permitida, não o responsável pelo resultado. “O agente fez” nunca explica um postmortem; “o sistema permitia essa ação, o owner era X e este controle falhou” permite aprender.
Ownership sem direito de decisão vira um título decorativo. Para cada fluxo, escreva quatro direitos:
Revisão e aprovação devem seguir o risco, não a vaidade de controlar cada tecla. Uma correção de teste em sandbox pode seguir automaticamente até um PR. Um merge em componente de autenticação exige o owner apropriado. Mudança em produção, dados pessoais, pagamentos ou comunicação externa precisa de uma confirmação humana explícita no último efeito. O guia da OpenAI sobre prompt injection recomenda limitar o impacto mesmo quando uma manipulação consegue influenciar o sistema.[^3]
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis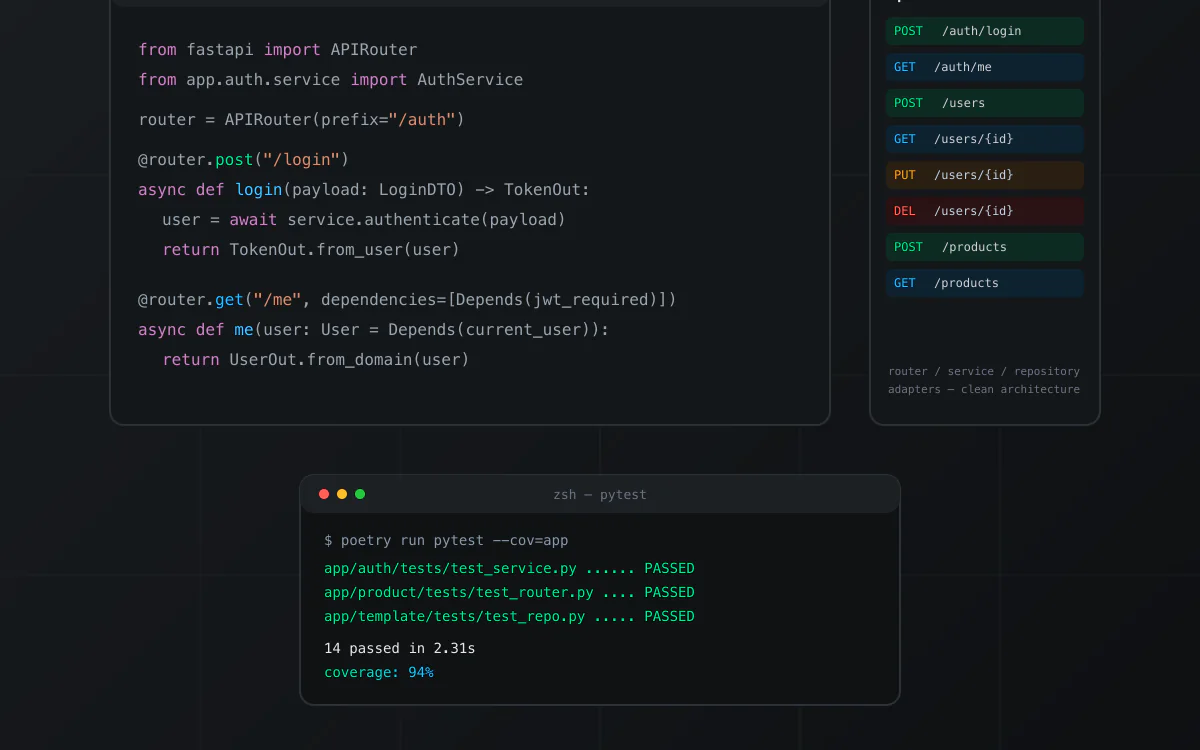
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto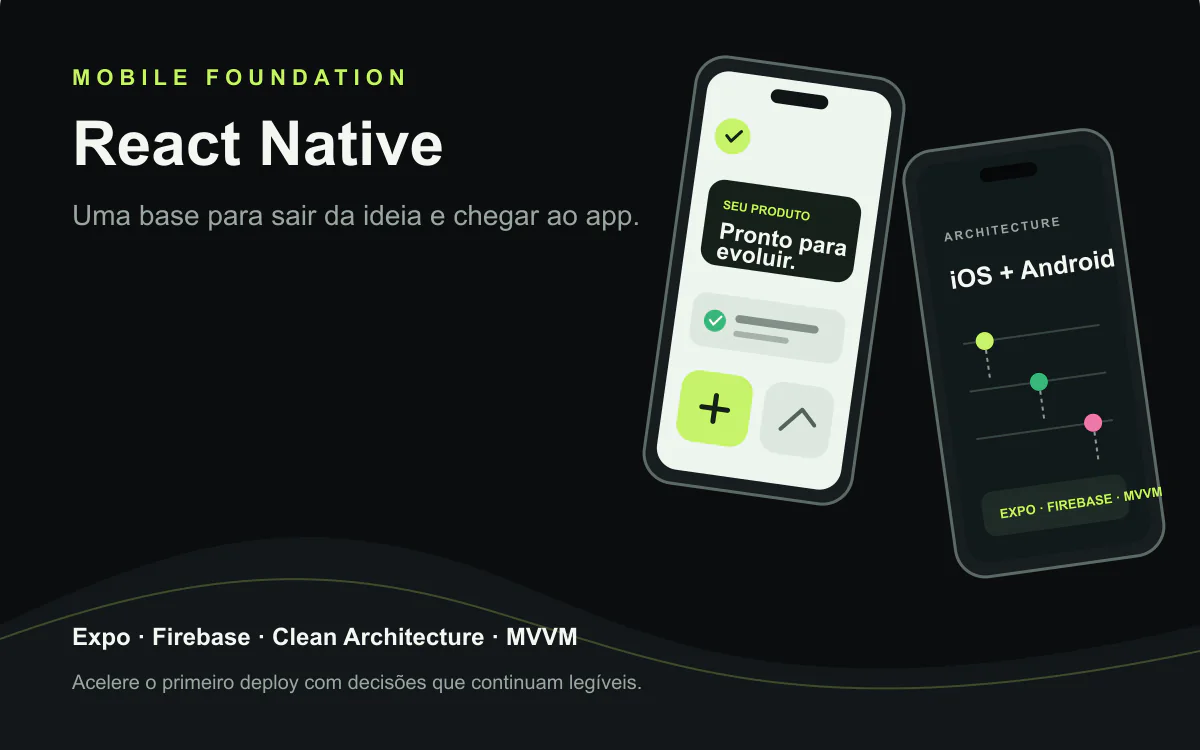
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto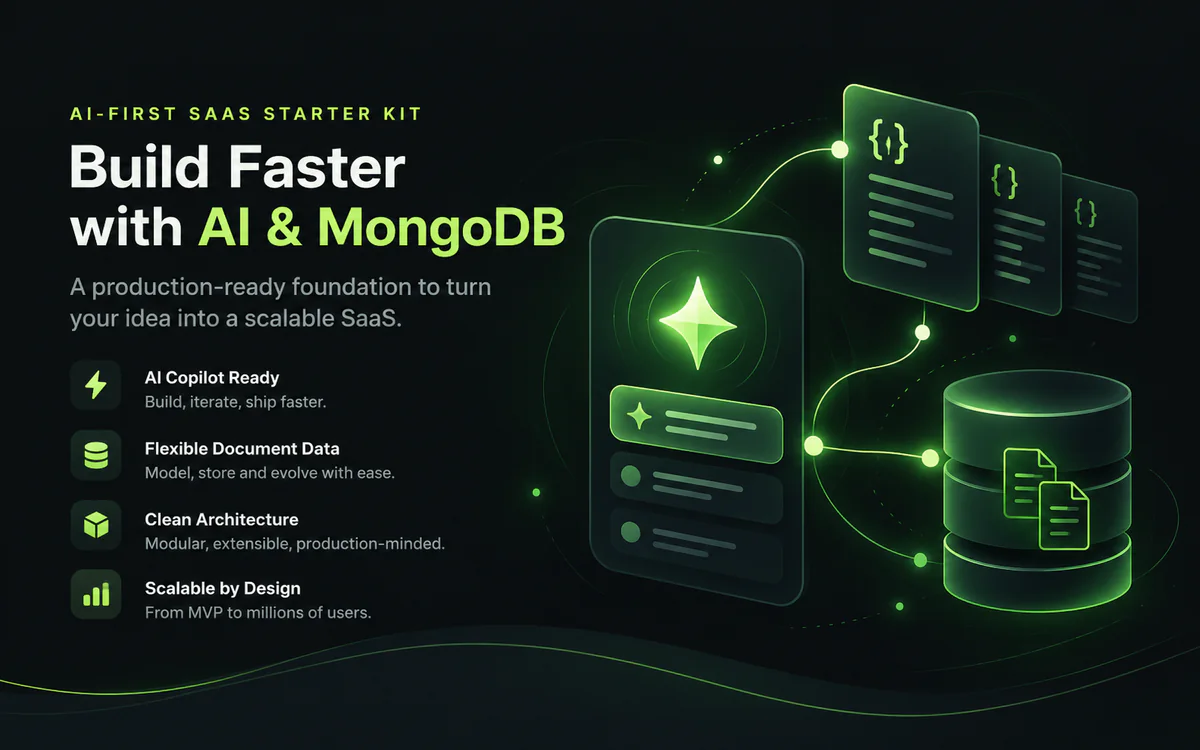
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
--- title: "Papéis e Novas Skills no Time AI-Native: Do Senior Engineer ao AI Systems Designer" subtitle: "Como a engenharia de software se reorganiza em torno de loops de agentes,
English summary: AI-native organizations need a measurement operating system, not an AI-usage leaderboard. This article starts with a minimal outcome event and dashboard, then conn
--- title: "QA e DevOps AI-Native: Evals em Produção, Testes Probabilísticos e IaC Gerada por IA" subtitle: "O que muda em qualidade, integração contínua e observabilidade quando o
Checklist prático para validar segurança, custos, avaliações e observabilidade antes de colocar seu app com IA em produção.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
Use esta matriz antes de “liberar um agente”. Se qualquer célula estiver pouco clara, reduza o escopo ou mantenha a tarefa manual.
| Pergunta | Baixo risco: automatize com guardrails | Médio risco: proponha e revise | Alto risco: humano decide e confirma |
|---|---|---|---|
| Efeito é reversível? | Diff, branch, teste, rascunho | PR, feature flag, alteração limitada | Produção, exclusão, pagamento, mensagem enviada |
| Consequência de errar? | Local e detectável | Afeta componente ou cliente limitado | Segurança, dinheiro, dados ou reputação |
| Evidência é repetível? | Teste/validador forte | Parte automatizada, parte amostrada | Não há sinal confiável antes do efeito |
| Contexto é estável? | Fonte única e atual | Há exceções conhecidas | Conflitos, política em mudança, caso novo |
| Reversão é rápida? | Minutos, sem dados perdidos | Requer coordenação | Irreversível ou com dano difícil de reparar |
A resposta não é permanente. Um fluxo pode subir de faixa quando falhas, custo de revisão e sinais de produção sustentam a mudança. Também deve descer quando uma regressão, mudança de domínio ou incidente remove essa confiança.
Sintoma: mais PRs entram, mas tempo até a revisão, retrabalho e tamanho dos diffs aumentam.
Diagnóstico: a geração foi acelerada, mas especificação, divisão de trabalho e revisão continuam sendo gargalos. A equipe transferiu carga cognitiva para quem revisa.
Intervenção: limite o tamanho do lote, peça plano antes do diff e revise contra critérios de aceite. Meça tempo até primeira revisão e taxa de mudanças pós-review, não linhas produzidas.
Sintoma: respostas citam muitos documentos e ainda tomam decisões incompatíveis.
Diagnóstico: falta uma ordem de autoridade ou um dono para resolver conflito; mais contexto apenas amplifica ambiguidade.
Intervenção: declare fonte de verdade, data de revisão e condição de parada. Converta perguntas repetidas em decisão curta, versionada e ligada à tarefa.
Sintoma: um agente executa ação fora do propósito, usa credencial ampla ou chega perto de um efeito externo sem confirmação.
Diagnóstico: a política foi escrita como recomendação, não como fronteira técnica. A equipe confiou em instrução onde precisava de permissão, sandbox ou confirmação.
Intervenção: reduza credenciais, separe leitura de escrita, registre tool calls e mova a confirmação para imediatamente antes do efeito. Teste permissão negada como caso de eval.
Sintoma: a suíte passa, mas incidentes, reclamações ou trabalho manual reaparecem em produção.
Diagnóstico: os casos medem uma versão estreita do problema, o grader confunde artefato com resultado, ou o ambiente de avaliação não representa a fronteira real.
Intervenção: investigue transcrições e estado final, não só a resposta textual. Transforme o incidente em caso de regressão; inclua entrada malformada, contexto incompleto, ferramenta indisponível e conflito de instruções.
Uma eval é uma tarefa com entrada, critério de sucesso e lógica de julgamento. Em agentes de múltiplas etapas, a transcrição importa: ela mostra ferramentas, estado intermediário e caminhos que a resposta final pode esconder.1
Mantenha duas coleções pequenas e vivas:
Não premie “percentual de autonomia”, quantidade de tokens, PRs ou linhas geradas. Esses indicadores podem melhorar enquanto o time perde qualidade. Prefira um painel equilibrado:
| Dimensão | Sinal | Proteção contra interpretação errada |
|---|---|---|
| Resultado | sucesso do caso de uso, defeitos escapados | compare trabalho semelhante e ouça usuários |
| Fluxo | lead time, espera por revisão, retrabalho | não atribua toda variação à IA |
| Qualidade | regressões, reversões, cobertura de fronteira | investigue casos, não apenas percentual |
| Economia | custo por tarefa, latência, tempo humano | inclua manutenção de eval e contexto |
| Saúde do time | carga de revisão, concentração de conhecimento, onboarding | trate silêncio e sobrecarga como risco operacional |
Pesquisas DORA são úteis como lente para observar entrega e estabilidade como resultados do sistema; elas não provam, isoladamente, o efeito de uma ferramenta de IA.2 Esse cuidado evita uma métrica perigosa: “fizemos mais rápido” quando apenas empurramos a conta para produção ou para uma pessoa exausta.
Quando um fluxo assistido por IA falhar, retire temporariamente a autonomia daquela classe de ação. Preserve logs, versão de contexto, ferramenta, permissões, entradas e evidências da revisão. Depois faça uma análise sem culpa, mas com responsabilidade clara.
Perguntas úteis para a revisão:
O objetivo não é produzir um documento ritualístico. É garantir que uma falha deixe o sistema menos propenso a repeti-la. O material do Google SRE sobre incident management enfatiza papéis, comunicação e aprendizado estruturado durante a resposta.3 Para este contexto, isso significa que o incidente não é “erro do modelo”: é evidência sobre o desenho do fluxo.
Onboarding AI-native não é uma aula de prompt. É uma prática guiada de responsabilidade distribuída. No primeiro dia, a pessoa acompanha um cartão de delegação real. Na primeira semana, executa um fluxo reversível em sandbox e registra contexto ausente. No primeiro mês, adiciona uma regressão derivada de falha real e participa de uma revisão de autonomia.
As competências evoluem:
Isso reduz a carga cognitiva apenas quando o sistema também remove escolhas inúteis. Se a pessoa precisa memorizar dez ferramentas, três formatos de prompt e exceções escondidas, a nova camada só aumenta exaustão. Prefira defaults seguros, poucas interfaces previsíveis e uma rota clara de escalonamento.
Não use IA como resposta automática quando o problema ainda não tem objetivo estável, quando a única evidência exige acesso a dados sensíveis sem isolamento, quando não existe rollback aceitável ou quando o volume é baixo demais para pagar a manutenção do fluxo. Também não force adoção em uma equipe já sobrecarregada de revisão: primeiro reduza dívida de contexto, riscos e filas.
Manual não significa atrasado. Para uma decisão rara, irreversível e altamente contextual, a melhor automação pode ser preparar uma análise e preservar a confirmação humana. O critério não é demonstrar modernidade; é melhorar o resultado líquido sem deslocar risco para usuários ou colegas.
Depois de algumas semanas, uma equipe está evoluindo quando consegue mostrar, em trabalho real:
O objetivo não é delegar tudo. É desenhar um sistema em que pessoas e modelos possam contribuir sem que a velocidade destrua entendimento, accountability ou cuidado. Comece com um fluxo estreito, mantenha a autonomia proporcional à evidência e deixe cada falha melhorar a próxima decisão.
A fonte define tarefa, trial, grader, transcrição, outcome, harness e suíte de avaliação. Os exemplos de governança aqui adaptam essas definições para engenharia de software. ↩
A referência DORA é usada para orientar a leitura sistêmica de desempenho e estabilidade, não para afirmar causalidade entre IA e produtividade. ↩
A referência do Google SRE informa princípios de resposta a incidentes; a aplicação a fluxos assistidos por IA é uma adaptação editorial. ↩