Anderson LimaSoftware Engineer & Architect
4 de outubro de 2026
16 min de leitura
55 visualizações
Observabilidade de Agents no Claude Code: prove o que o loop realmente fez
English summary: A practical guide to observing Claude Code agents with events, traces, costs, latency, evidence, evals, privacy controls, and an operational dashboard that explains what happened instead of merely counting activity.
Published: August 2026
Reading time: 18 min
Keywords: Claude Code, observabilidade de agents, OpenTelemetry, tracing, evals, custo de IA, auditoria, privacidade
Exemplo concreto: uma trace útil mostra qual evidência levou o agent a parar, além do número de tools chamadas.
```ts const evidence = { sessionId, toolName, durationMs, outcome, evidenceId, }; ```
Um agent terminou a tarefa, alterou oito arquivos, rodou 23 tools e disse que tudo estava validado.
Isso não prova quase nada.
Talvez ele tenha escolhido uma ferramenta errada, repetido uma busca seis vezes, esperado autorização por 40 segundos, gasto a maior parte do tempo num teste que falhou, usado um subagent que não retornou evidência ou concluído "validado" sem executar o check que importava. Um dashboard que só mostra sessões, tokens e linhas alteradas transforma esse incidente em uma planilha agradável. Não explica a decisão. Não permite reproduzir o caminho. Não dá a um responsável condições de aprovar a autonomia seguinte.
Minha tese é simples: observabilidade de agent não é medir atividade; é preservar evidência suficiente para reconstruir uma decisão, atribuir seu custo e verificar seu resultado sem registrar mais dados do que o necessário.
Para Claude Code, a base existe. A documentação atual descreve exportação de métricas e eventos por OpenTelemetry; suporte de traces ainda em beta para detalhar uma interação, chamadas ao modelo, invocações de tools e hooks. Mas o produto emite dados brutos. Correlação entre sessões, baseline, alertas, retenção, ownership e decisão operacional continuam sendo trabalho do time. Verifique a versão instalada e a documentação antes de ativar recursos beta ou campos detalhados: esse contrato muda com o produto.
Uma referência primária para o contrato de telemetria é a especificação do OpenTelemetry.
Observabilidade é a capacidade de responder, com evidência, perguntas que não estavam pré-programadas no dashboard:
Isso não é o mesmo que telemetria de produto. Contar sessões, PRs, tokens ou linhas alteradas ajuda a dimensionar adoção, mas não prova correção. Tampouco é uma gravação integral do raciocínio privado do modelo. Tentar capturar cada prompt, resposta, arquivo e resultado de tool cria um passivo de segurança, uma conta de armazenamento e um conjunto de dados difícil de governar.
Também não é uma licença para criar um "score de produtividade" do desenvolvedor. Muitos tokens podem indicar investigação cuidadosa, contexto ruim ou um loop ineficiente; poucas tools podem indicar uma solução elegante ou uma omissão. A unidade de valor não é volume. É uma tarefa cujo contrato foi cumprido com evidência proporcional ao risco.
Há situações em que um workflow linear é melhor. Se o trabalho é "formatar arquivos alterados e rodar linter", instrumente o job de CI e mantenha o caminho determinístico. Use um agent quando a sequência de investigação, ferramentas ou hipóteses realmente depende do estado encontrado. A observabilidade deve revelar essa diferença, não disfarçar automação fixa como autonomia.
O time acompanha custo diário, tokens e número de sessões. Um dia o custo dobra. Ninguém sabe se veio de um modelo novo, de um MCP lento, de uma skill gigante, de retries da API ou de cinco subagents concorrentes.
Totais são a última camada, não a primeira. Todo ponto agregável precisa manter uma ligação para a interação, a sessão, a tarefa e, quando houver, a trilha de delegação. Em Claude Code, use o identificador de sessão como eixo; eventos também trazem um contador de sequência para ordenar eventos dentro da sessão. Sem essa cadeia, você vê tendência, mas não causa.
Uma resposta de 55 segundos pode conter 4 segundos de modelo, 38 segundos de consulta externa e 13 segundos esperando autorização humana. Registrar apenas a chamada ao LLM culpa o componente errado.
O recorte útil é a interação inteira: prompt recebido, request ao modelo, decisão de tool, espera de permissão, execução, resultado, hook e verificação. A documentação de observabilidade do Agent SDK descreve exatamente essa hierarquia: uma interação contém requests ao LLM, tools e hooks; a delegação a subagents pode aparecer aninhada na trilha do agente principal. É essa topologia que permite dizer se o problema é capacidade, integração, política ou processo.
O comando de uso da sessão pode mostrar tokens, duração de API, duração de parede e uma estimativa local de custo. É útil para depuração, não para contabilidade. A própria Anthropic avisa que a estimativa local pode divergir da cobrança e que a fonte autoritativa é o Console ou o provedor de nuvem.
O erro é tentar resolver governança financeira com uma única métrica. Você precisa de duas visões: custo operacional aproximado por sessão para encontrar desperdício rápido e custo faturado pelo provedor para fechamento. Quando houver subagents, atribua custo ao trabalho delegado e ao agente principal; contar apenas a mensagem final reduz artificialmente a despesa real.
Ativar detalhes de tools pode ser importante para investigar uma escrita indevida, mas argumentos de Bash, caminhos, conteúdo de MCP e resultados de tools podem carregar segredo, dados de cliente ou propriedade intelectual. A mesma telemetria que melhora auditoria pode ampliar o raio de exposição.
Comece com metadados: tipo de tool, resultado, duração, decisão de permissão, código de erro, origem da política e hash de correlação. Aumente para detalhe de parâmetros somente em fluxos aprovados, com redaction, acesso restrito, prazo de retenção e owner nomeado. Cardinalidade é outro risco: nomes de arquivos, prompts e IDs de tenants não pertencem a métricas. Eventos ou traces com acesso controlado são o lugar certo quando o detalhe for necessário.
Um agent não é uma linha do gráfico. É um harness que combina contexto, modelo, tools, ambiente, permissões e verificação.
| Camada | Pergunta operacional | Evidência mínima |
|---|---|---|
| Contexto | Com quais instruções, skills e arquivos ele começou? | versão do projeto, skill/agent ativado, hash de configuração |
| Decisão | O que ele tentou fazer e por quê? | objetivo, etapa, estado da decisão, hipótese curta |
| Tool | O que foi solicitado e o que aconteceu? | tipo, status, duração, tentativa, classe de erro |
| Permissão | Quem autorizou, bloqueou ou negou? | modo, origem da política, decisão e aprovador quando houver |
| Ambiente | Onde a ação correu? | repo/ambiente lógico, provider, modelo, versão do CLI |
| Verificação | O resultado resistiu a um check? | comando/check, status, artefato ou link de evidência |
| Governança | Quanto custou e quem responde pelo fluxo? | tokens, custo estimado, centro de custo, owner |
O Claude Code exporta métricas como uso de tokens e custo, sessões, commits, PRs e decisões de ferramentas; também exporta eventos para prompts, lifecycle de tools, hooks, MCP, compactação e conclusão de subagents. Isso é um bom alicerce, não um dashboard pronto. A regra prática é não inventar uma taxonomia paralela até compreender os eventos nativos: normalize-os no collector e só então acrescente campos próprios que atendam uma pergunta real.
Uma tool call responde "o que executou". Não responde "que alternativa foi descartada". Para tarefas de risco médio ou alto, introduza um evento de decisão pequeno, estruturado e redigido:
| Campo | Exemplo | Regra |
|---|---|---|
decision.kind | choose_read_only_query | vocabulário enumerado |
decision.reason | confirmar hipótese por release | sem copiar dados sensíveis |
decision.risk | low, medium, high | definido pelo contrato |
decision.evidence_ref | git:ab12cd | referência, não conteúdo |
decision.owner | payments-platform | time, não pessoa individual |
approval.required | true | explícito antes da tool |
Não force o modelo a produzir uma explicação longa de cadeia de pensamento. Esse não é o objetivo e piora privacidade e custo. Registre uma justificativa curta e operacional, ligada à evidência que uma pessoa pode inspecionar.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis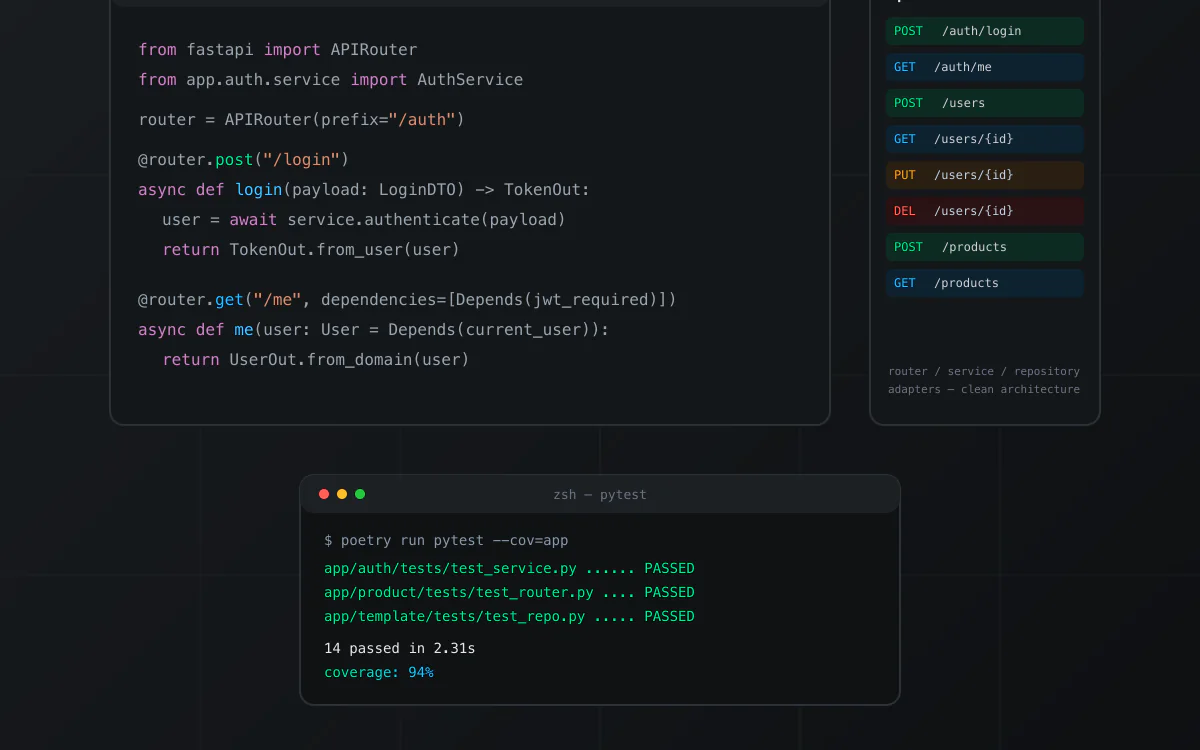
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto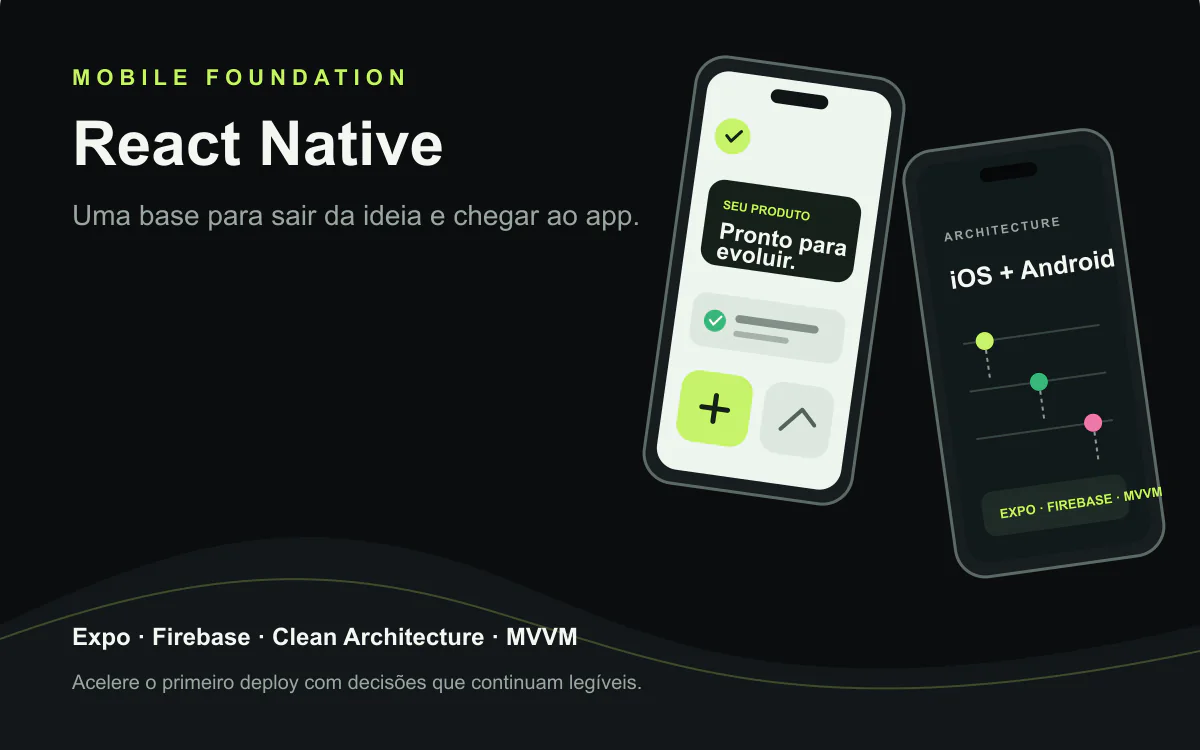
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto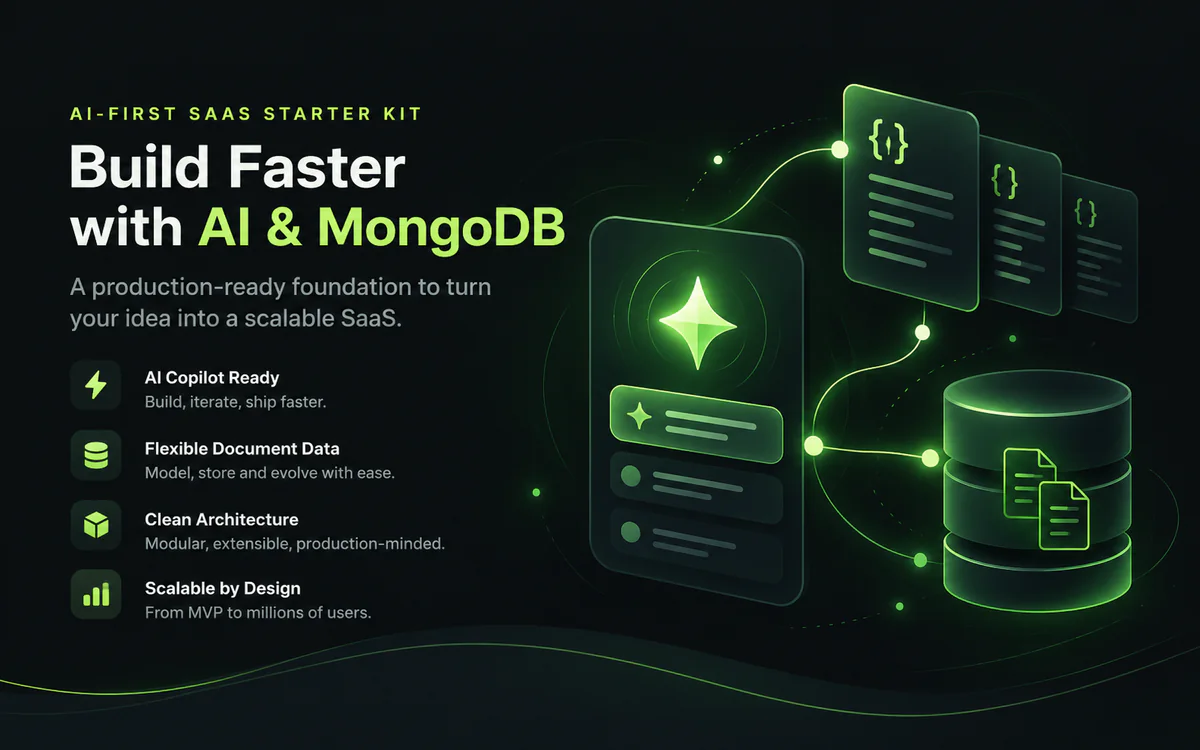
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produto
nextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produto
nextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares
# Subagents ou Agent Teams no Claude Code: como paralelizar sem criar caos English summary: A practical guide to choosing Claude Code subagents or experimental agent teams, defin
# Permissões do Claude Code: como desenhar autonomia sem abrir a produção English summary: A practical framework for using Claude Code permissions, settings, allow/deny rules, ho
# Como Criar um Agent de Code Review com Claude Code que Encontra Risco Real English summary: A practical, security-minded guide to building a Claude Code review agent that inspe
Checklist prático para validar segurança, custos, avaliações e observabilidade antes de colocar seu app com IA em produção.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.
O erro clássico é ligar uma plataforma de observabilidade antes de saber o que o agent deve provar. Suba em camadas.
Defina o job em uma frase: "investigar um erro de checkout e produzir até três hipóteses, sem modificar produção". Dê a ele um ID de tarefa e um contrato de saída. Sem objetivo observável, qualquer métrica será vaidade.
No arquivo de instruções do projeto, declare ferramentas permitidas, limites, checks obrigatórios e condições de escalonamento. Por exemplo: leitura de logs e Git permitida; escrita em produção bloqueada; toda hipótese deve apontar release, erro e próximo check. O contrato transforma "agiu bem" em critérios revisáveis.
Uma skill encapsula o playbook que se repete. Observe ativação, versão e resultado da skill, não o texto integral da instrução. Quando a taxa de evidência cai depois de uma mudança de skill, você tem um ponto de investigação concreto.
O subagent ganha escopo, tools mínimas e contexto isolado. Registre o tipo de agent, o agente que delegou, duração, tokens e estado final. Não use a conclusão do subagent como evidência suficiente: ela precisa apontar artefatos verificáveis.
Hooks são o ponto certo para controles determinísticos e coleta de eventos ao redor de ações sensíveis. MCP conecta contexto externo, mas cada servidor acrescenta disponibilidade, credenciais, custo e superfície de prompt injection. Instrumente conexão, falha, tool remota, latência, scope de permissão e origem do servidor; nunca trate "MCP conectado" como sinônimo de confiança.
Transforme autonomia em uma matriz de risco. Leitura local pode ser automática. Escrita em branch pode pedir revisão posterior. Escrita em ambiente compartilhado deve pedir aprovação. Produção e dados regulados exigem política externa ao modelo, credenciais com menor privilégio e evidência de quem aprovou. Uma barra de autonomia é menos útil que essa matriz.
Por fim, avalie o loop. Congele um conjunto de cenários: bug conhecido, ferramenta indisponível, permissão negada, evidência conflitante, dado sensível e custo excedido. Para cada cenário, declare resultado esperado, evidência obrigatória, limite de ferramentas, limite de tempo e decisão humana esperada. A telemetria de produção mostra o que ocorreu; evals mostram se o comportamento continua aceitável antes de ampliar o alcance.
O fragmento abaixo é para um arquivo de settings gerenciado da organização ou do projeto, conforme a política do seu ambiente. Ele envia logs de eventos para um OpenTelemetry Collector próprio, preserva os detalhes de tool desativados por padrão e evita colocar credenciais no repositório. Para uma URL HTTPS que exija autenticação, injete o header por secret manager ou configuração gerenciada, não no arquivo versionado.
{
  "env": {
    "CLAUDE_CODE_ENABLE_TELEMETRY": "1",
    "OTEL_LOGS_EXPORTER": "otlp",
    "OTEL_LOG_TOOL_DETAILS": "0",
    "OTEL_EXPORTER_OTLP_LOGS_PROTOCOL": "http/protobuf",
    "OTEL_EXPORTER_OTLP_LOGS_ENDPOINT": "https://otel-collector.internal.example:4318/v1/logs"
  }
}
Após aplicar a configuração no escopo correto, inicie uma sessão nova, envie um prompt inofensivo e procure o evento de prompt no backend. Se ele não chegar, rode o CLI com debug e investigue o erro de exportação. Só depois habilite detalhes para uma janela de auditoria delimitada:
{
  "env": {
    "OTEL_LOG_TOOL_DETAILS": "1"
  }
}
Antes dessa segunda mudança, responda por escrito:
O exemplo não configura o collector, autenticação, TLS, redaction nem alertas. Esses itens pertencem à plataforma de observabilidade e precisam ser testados no seu ambiente. Em versões recentes, o Claude Code também suporta traces beta para uma interação e suas tools; trate a flag beta como experimento controlado, não como dependência crítica de auditoria.
Um dashboard bom responde a uma pergunta de plantão em menos de dois minutos. Eu dividiria a tela em quatro painéis, todos filtráveis por período, projeto, modelo, versão de configuração e owner:
Evite colocar prompts e resultados completos no painel padrão. Exiba um link protegido para o trace, com redaction e controle de acesso, quando uma investigação exigir. Também evite ranking de pessoas. O owner deve ser o time responsável pelo harness, pela integração e pelo orçamento — não um mecanismo de vigilância individual.
| Decisão | Opção conservadora | Quando ampliar | Trade-off |
|---|---|---|---|
| Detalhe de tools | tipo, duração e status | incidente aprovado | menos diagnósticos imediatos, menor exposição |
| Traces | eventos correlacionados | tracing beta em piloto | maior precisão, maior dependência de versão |
| Custo | estimativa por sessão | reconciliação com billing | agilidade versus exatidão financeira |
| Autonomia | leitura e análise | escrita reversível após eval | velocidade versus blast radius |
| Retenção | janela curta | obrigação legal documentada | menor histórico versus menor risco |
Dados de observabilidade são dados de produção. Classifique-os antes do rollout. A documentação de uso de dados do Claude Code informa que métricas operacionais enviadas à Anthropic não incluem código, prompts ou caminhos de arquivos; ela também descreve controles de opt-out e o armazenamento local de transcrições. Isso não remove a sua responsabilidade sobre o collector próprio, MCPs de terceiros, prompts enviados ao modelo e logs detalhados que sua empresa resolver guardar.
Faça pelo menos estas separações:
Essa divisão evita o vácuo comum: a plataforma coleta tudo, segurança não sabe, finanças vê uma fatura tarde e o time de produto assume que "o agent estava validado".
Para ações sensíveis, o gate precisa ser externo ao texto do prompt. Use regras de permissão, hooks que bloqueiem comandos e credenciais de escopo mínimo. Registre a decisão de bloqueio como sucesso de segurança, não como erro do agent. Para MCP, inventarie servidor, versão, origem, permissões concedidas e responsável; conteúdo externo deve ser tratado como não confiável mesmo quando vem de uma ferramenta aprovada.
Não feche esta iniciativa porque o dashboard carregou. Rode uma prova de campo controlada:
O sinal mais valioso é uma investigação real que termine mais rápida e com menos suposição: alguém abre uma tarefa cara ou lenta, navega até a decisão, vê a tool e a evidência associada, entende a política aplicada e toma uma ação de engenharia. Se a plataforma só permite admirar gráficos, ela ainda não observou o agent.
O teste de maturidade de um agent não é quantas tools ele tem, nem quão convincente é sua resposta final. É a capacidade do time de responder: qual foi o objetivo, o que aconteceu, qual decisão foi tomada, qual política limitou o caminho, quanto custou e o que prova que o resultado é aceitável.
Claude Code oferece uma matéria-prima útil para isso por meio de métricas, eventos e, em beta, traces OpenTelemetry. A parte difícil continua sendo engenharia: escolher os campos mínimos, proteger o que é sensível, ligar custo a valor, tornar verification obrigatório e atribuir ownership. Faça isso antes de subir a autonomia. Um loop que você consegue explicar, auditar e parar é muito mais valioso do que um loop que apenas parece ocupado.