
Anderson LimaSoftware Engineer & Architect
1 de outubro de 2026
20 min de leitura
11 visualizações
Retry de uma chamada de LLM não prova que uma operação distribuída aconteceu uma única vez

Um worker do RelayOps termina de extrair os campos de uma fatura, monta o resultado e cai antes de confirmar (ack) a fila. A fila, como toda fila que promete não perder trabalho, não sabe se o worker morreu antes ou depois de terminar - só sabe que não recebeu confirmação. Ela reentrega o mesmo job. Um segundo worker (ou o mesmo, reiniciado) pega o job, extrai de novo, e sem mais nada além disso cria uma segunda revisão para o mesmo documento. O operador que revisa fila vê duas entradas onde deveria ver uma. Este incidente é sintético; não descreve cliente, execução em produção ou carga real.
A causa não é a queda do worker - quedas de processo são esperadas em qualquer sistema que rode por tempo suficiente. A causa é tratar "a chamada de extração terminou" como sinônimo de "o efeito de negócio aconteceu exatamente uma vez". São coisas diferentes. Uma fila que reentrega só garante at-least-once delivery (entrega pelo menos uma vez): ela nunca descarta um job silenciosamente, o que significa que ela pode, e eventualmente vai, entregar o mesmo job mais de uma vez. Exactly-once (exatamente uma vez) como propriedade fim-a-fim de um sistema distribuído com efeitos externos não existe de graça - o que existe é at-least-once na entrega combinado com idempotência no efeito, de modo que entregar duas vezes produza o mesmo resultado observável de entregar uma vez. Retry de uma chamada de LLM resolve disponibilidade da chamada. Não resolve, sozinho, se a revisão foi criada uma ou duas vezes.
O capítulo 3 fechou com um control plane para agentes: policy.mjs exigindo maxSteps e deadlineMs na construção, um tool registry com contratos explícitos (idempotent, requiresHumanApproval, argsSchema) e um workflow determinístico classify → extract → validate → review-handoff rodando ao lado de um agent runner limitado, ambos sobre o mesmo ledger de auditoria herdado do capítulo 2. Este capítulo não estende esse control plane - ele constrói a camada que fica abaixo de onde esse control plane roda: o que acontece quando o processo que executa qualquer um desses dois caminhos (workflow fixo ou agent runner) morre no meio de um passo. Nenhum contrato de store.mjs, state.mjs ou policy.mjs foi alterado, porque nenhum deles é reimportado aqui; a fila e o outbox deste capítulo são novos módulos que assumem a mesma disciplina de tenant explícito, não uma extensão dos anteriores.
Antes de qualquer diagrama, o núcleo deste capítulo cabe em uma função que falha de propósito:
export function buildIdempotencyKey({ tenantId, documentId, operationVersion }) {
  assertTenantId(tenantId); // lança se tenantId não bater com /^[a-z][a-z0-9-]{1,32}$/
  if (typeof documentId !== 'string' || documentId.length === 0) {
    throw new Error('documentId is required for an idempotency key');
  }
  if (!(Number.isInteger(operationVersion) && operationVersion >= 1)) {
    throw new Error('operationVersion must be an integer >= 1');
  }
  return `${tenantId}:${documentId}:v${operationVersion}`;
}
A chave é tenant, documento e versão da operação, nessa ordem, sempre. Não existe caminho de código que monte uma chave só a partir de documentId - o que é a defesa estrutural contra a Falha 4 mais adiante: um documentId que colide entre dois tenants (um identificador curto, um UUID reaproveitado por engano, uma migração que reindexou documentos) nunca vira a mesma chave de idempotência, porque o tenant está embutido na chave, não checado depois como uma regra separada que alguém pode esquecer de aplicar.
O segundo pedaço do núcleo é o que acontece quando a mesma chave aparece de novo com um payload diferente:
const existing = results.get(idempotencyKey);
if (existing) {
  if (existing.payloadHash !== payloadHash) {
    throw new IdempotencyConflictError(`${idempotencyKey} already committed with a different payload`);
  }
  return { result: existing.result, eventId: existing.eventId, deduped: true };
}
Mesma chave, mesmo payload: dedupe silencioso, devolve o resultado já existente. Mesma chave, payload diferente: erro explícito, nunca reuso silencioso. Essa distinção importa porque "mesmo documento, versão de operação diferente" é um evento de negócio real (reprocessamento depois de correção), enquanto "mesma chave, payload mutante" quase sempre é um bug de quem está chamando - dois lugares do código competindo pela mesma chave, ou uma versão de operação que não foi incrementada quando deveria.
O pipeline que este capítulo evolui é ingest → extract → validate → review, o mesmo desenhado desde o capítulo 1, agora com uma camada de execução que sobrevive a crash:
Quatro módulos novos carregam essa camada, e cada um resolve exatamente um problema:
queue.mjs - fila em memória com lease, heartbeat, deadline e um fencing token por lease. Cada leaseNext() incrementa um contador (fence); ack/nack/heartbeat só aceitam o token da lease atual. Se um worker "zumbi" (que achou que ainda estava com a lease, mas ela já expirou e foi redistribuída) tentar confirmar depois, a fila rejeita - sem isso, dois workers podem achar que são donos do mesmo job ao mesmo tempo.outbox.mjs - commitResultWithEvent() grava o resultado e o evento de notificação em uma única chamada síncrona. Nesta modelagem em memória, "atômico" significa que nada mais pode intercalar entre as duas escritas dentro do mesmo processo; um sistema real precisa de uma transação de banco de dados para a mesma garantia atravessando um crash de processo, e isso não foi testado aqui (ver limites mais abaixo).retry-policy.mjs - classifica todo erro em transient, permanent ou cancelled e decide retry, dead_letter ou cancel. Não existe uma quarta saída possível, o que é o argumento estrutural contra retry infinito.worker.mjs - a sequência lease → extract → commit → ack, com pontos nomeados onde um teste pode injetar uma queda de processo e depois chamar processOnce() de novo simulando um worker novo depois do restart.Um job carrega quatro marcas de tempo com significados diferentes, e confundir uma pela outra é a origem de boa parte dos bugs de fila:
visibleAt - quando o job volta a ficar disponível para ser pego. Usado tanto no enqueue inicial quanto no agendamento de retry com backoff.leaseUntil - até quando o worker atual tem exclusividade sobre o job. Passar disso não mata o worker; só diz à fila que, se ninguém confirmou até aqui, o job pode ser redistribuído.deadlineAt - teto absoluto desde a criação do job, independente de quantas tentativas restam. Um job pode ter maxAttempts de sobra e ainda assim ser cancelado se o deadline passou; retries e deadline são dois limites diferentes que atuam juntos.createdAt - usado apenas para medir idade do job (jobAgeMs), a métrica que separa "está esperando há muito tempo" de "está processando há muito tempo".Heartbeat existe para jobs longos: um worker que ainda está trabalhando estende leaseUntil periodicamente para não ser redistribuído no meio de um passo legítimo e demorado. Sem heartbeat, todo leaseMs teria que ser generoso o bastante para o pior caso, o que atrasa a detecção de workers realmente mortos.
A pergunta que outbox.mjs responde é: como persistir "o resultado da extração existe" e "um evento avisando isso foi criado" de um jeito que nunca deixe só um dos dois acontecer? A resposta clássica, documentada pela AWS como transactional outbox pattern, é gravar as duas coisas na mesma transação de banco e deixar um processo separado (o relay) ler a tabela de outbox e publicar - se a transação falha, nenhum dos dois lado acontece; se ela commita, os dois aconteceram juntos, e o relay garante a entrega do evento de forma desacoplada do sucesso da publicação em si.
Neste capítulo, "mesma transação" é simulado como uma única chamada síncrona de JavaScript sem await no meio - o que já é verdade o bastante para provar a lógica de dedupe e conflito, mas não prova o que acontece quando o processo morre a meio de um COMMIT real em disco, nem o que acontece se duas conexões de banco competem pela mesma linha. examples/pipeline-runbook.md lista explicitamente essa lacuna e o roteiro para fechá-la com PostgreSQL de verdade (não executado nesta sessão - ver seção de custo/reversibilidade). O ponto pedagógico sobrevive à simplificação: o bug que o outbox previne (perder o evento, ou publicar um evento para uma transação que fez rollback) é real e documentado independentemente da tecnologia escolhida para implementá-lo.
O cenário de abertura, testado de ponta a ponta em crash-recovery.test.mjs:
assert.throws(() => worker.processOnce(0, createCrashInjector('after_commit_before_ack')), CrashSimulated);
const resumed = worker.processOnce(5000); // "novo processo", bem depois do lease expirar
assert.equal(resumed.outcome, 'acked');
assert.equal(resumed.deduped, true, 'segundo commit precisa dedupar, não criar segundo evento');
assert.equal(extractCalls, 2, 'extração rodou duas vezes de verdade - execução at-least-once');
assert.equal(outbox.pendingRows().length, 1, 'mas só um evento foi commitado - efeito exactly-once');
Extração roda duas vezes (o worker não tem como saber que já tinha terminado antes de cair); o commit no outbox é o único lugar que sabe que aquela chave já tem resultado, então a segunda tentativa retorna o resultado existente em vez de criar um segundo evento. Uma revisão, não duas.
Nem todo erro merece retry. Um documento com schema inválido não vai passar na segunda tentativa só porque esperou trezentos milissegundos - é uma falha permanente, e retry-policy.mjs a manda direto para a DLQ na primeira tentativa, sem queimar maxAttempts em algo que não vai mudar. O motivo gravado junto do job na DLQ é um código classificado (permanent_error, max_attempts_exceeded), nunca a mensagem crua do erro - a mensagem de um parser pode conter um trecho do documento, e um painel de operação de fila não é lugar para isso vazar.
Reprocessar um job da DLQ é um comando, não uma retentativa automática: exige operatorId, cria um job novo com operationVersion + 1 (nunca ressuscita o job morto no lugar) e grava uma entrada de auditoria ligando o job antigo, o novo e quem decidiu. Isso é deliberado: se um documento precisa ser tentado de novo depois de uma correção manual, essa decisão tem nome e hora, do mesmo jeito que uma aprovação de revisão tem no capítulo 3.
Cancelamento é um terceiro balde, separado da DLQ. Um job cujo deadlineAt já passou é cancelado no momento em que alguém tenta pegá-lo (leaseNext), e cancelamento não entra no mapa de DLQ - não existe caminho de reprocessFromDlq para um job cancelado. Se um documento cancelado genuinamente precisar ser refeito, isso é uma decisão humana nova, com enqueue() explícito e versão nova, não uma ressurreição automática escondida atrás de um retry.
O Temporal resolve um problema mais amplo do que fila e outbox: durabilidade de execução, não só de mensagem. Uma Workflow Execution no Temporal roda por tempo indefinido e, ao falhar, não recomeça do zero - ela retoma via Replay, reconstruindo seu estado a partir de um Event History gravado, comparando os comandos gerados de novo contra o que já foi registrado. Isso só funciona porque o código do Workflow é determinístico por contrato: dado o mesmo Event History, ele tem que gerar os mesmos comandos toda vez que for reexecutado. Qualquer coisa não determinística - uma chamada de rede, um Date.now(), e sobretudo uma chamada de LLM, cuja resposta pode variar entre execuções mesmo com o mesmo prompt - precisa viver dentro de uma Activity, que o Temporal trata como uma caixa preta re-executável e faz o replay pular, não reexecutar.
A fila com outbox deste capítulo não tenta ser isso. Ela dura o efeito de um passo (o resultado mais o evento), não a execução inteira de um pipeline de múltiplos passos com estado de longa duração entre eles. Se o RelayOps um dia precisar de um workflow que sobrevive semanas, com passos condicionais dependentes do conteúdo do documento e retomada automática de onde parou, esse é exatamente o caso de uso que justificaria adotar um motor como o Temporal - mas essa adoção não foi feita, testada ou medida nesta sessão. O que existe aqui é a leitura da documentação oficial e uma comparação conceitual, não uma implementação.
Sintoma: um job nunca sai da fila; o log mostra a mesma chave sendo tentada centenas de vezes.
Causa: um retry sem teto de tentativas, geralmente porque alguém tratou "falha transitória" como "sempre vale tentar de novo" sem perguntar quantas vezes.
Resposta: retry-policy.mjs tem exatamente três saídas (retry, dead_letter, cancel) e a saída retry só existe enquanto attempt < maxAttempts. O teste crash-recovery.test.mjs prova isso sob falha transitória permanente: três tentativas, depois DLQ, nunca uma quarta.
Sintoma (em um sistema Temporal real, não implementado aqui): o Workflow produz comandos diferentes em execuções de replay do mesmo Event History, e o motor rejeita o replay com um erro de não-determinismo. Causa: colocar a chamada ao modelo diretamente no corpo do Workflow em vez de dentro de uma Activity - a resposta do modelo pode variar, e o Workflow precisa ser puro em relação ao seu próprio histórico. Resposta: a regra, direto da documentação oficial do Temporal, é que qualquer efeito colateral ou chamada não determinística mora em uma Activity. Como este capítulo não roda Temporal, a falha é documentada como risco de design, não reproduzida em um cluster real - fingir uma reprodução aqui seria inventar evidência.
Sintoma: o resultado existe no banco, mas ninguém foi notificado (ou o inverso: alguém foi notificado sobre uma transação que fez rollback).
Causa: gravar no banco e publicar no broker como duas chamadas separadas, sem transação compartilhada. crash-recovery.test.mjs reproduz isso com uma função naiveDualWrite deliberadamente simples:
function naiveDualWrite(db, broker, key, payload, crashInjector) {
  db.set(key, payload); // "commit no banco" - nenhuma linha de outbox, nenhum rastro durável
  crashInjector('after_db_write_before_publish');
  broker.publish(payload); // nunca alcançado se a queda cair acima
}
O teste prova exatamente o que a AWS descreve como motivação do padrão: db.has(key) é verdadeiro, broker.published.length é zero. O evento sumiu, e nada no sistema sabe que deveria existir um.
Resposta: outbox.commitResultWithEvent() grava as duas coisas juntas; uma falha no meio não deixa nenhuma das duas visível para quem chama de novo, e um sucesso deixa uma linha de outbox pendente que o relay eventualmente publica - mesmo que o processo original já tenha morrido.
Sintoma: o tenant B vê (ou sobrescreve) o resultado de um documento do tenant A porque os dois compartilham o mesmo documentId.
Causa: uma chave de idempotência construída só a partir de documentId, sem o tenant como parte da chave.
Resposta: buildIdempotencyKey exige tenantId válido antes de montar qualquer coisa - não existe um caminho de código que produza uma chave sem tenant. O teste correspondente cria dois tenants com o mesmo documentId e a mesma operationVersion e prova que as chaves, e os resultados armazenados sob elas, nunca colidem.
Os 15 testes (node --test examples/*.test.mjs, 100% verde) provam dedupe de chave e payload, isolamento entre tenants, o cenário de abertura fim-a-fim, republicação de relay absorvida pelo consumidor, o anti-padrão de dual write, DLQ com motivo redigido, teto de retries, cancelamento por deadline como beco sem saída da DLQ, e reprocesso auditado. Não provam semântica de um broker real (SQS, Kafka, RabbitMQ têm garantias e configurações próprias, algumas mais fortes que "at-least-once" sob condições específicas), atomicidade de transação PostgreSQL sob crash de processo real, durabilidade de disco depois de perda de energia, ou corrida genuína entre workers concorrentes - o simulador é single-thread e síncrono, então leaseNext() nunca compete de verdade consigo mesmo. Também não provam nada sobre um modelo real: extract() é uma função sintética fixa em todo teste.
O script examples/scripts/synthetic-metrics.mjs roda 12 documentos sintéticos e separa três números por documento: tempo de espera na fila (queueWaitMs, a única métrica que reflete lógica real de controle sob esta carga sintética), tempo de inferência (inferenceMs, constante fixa de 40ms, não uma latência medida de modelo) e tempo de espera por revisão humana (reviewWaitMs, constante fixa de 90ms, não comportamento medido de revisor). A profundidade da fila é amostrada por tick e varia de 1 a 7 no ensaio, com pico no meio do lote de doze documentos - evidência do formato da carga sintética, não uma capacidade de produção.
Custo: cada retry queima uma chamada adicional (de extração, e potencialmente de modelo); um teto de tentativas não é só sobre travar loops, é sobre limitar quanto um documento problemático pode gastar antes de virar decisão humana. Segurança: o motivo gravado na DLQ é sempre um código curto, nunca o texto do erro ou do documento - um painel de operação de fila não deveria ser um vetor de vazamento de PII. Reversibilidade: cancelamento é terminal e não tem caminho de volta automático; reprocesso de DLQ cria um job novo e versionado, nunca sobrescreve o antigo, então o histórico de decisões (inclusive as erradas) permanece auditável. A lacuna real, registrada sem retoque em examples/pipeline-runbook.md: não há limite de taxa por tenant no reprocesso de DLQ nesta implementação - um operador (ou uma automação de operador) mal configurado poderia reprocessar o mesmo documento morto repetidamente sem que o sistema o impeça.
Outra lacuna que vale registrar em vez de esconder: outbox.mjs nunca remove uma linha já publicada - ela fica marcada published, mas continua ocupando memória (ou, em uma versão com banco, uma tabela) indefinidamente. Isso é aceitável para os 15 testes deste capítulo, que rodam em milissegundos e nunca chegam perto de um volume que importe, mas é exatamente o tipo de decisão que precisa de uma política explícita de retenção antes de qualquer coisa próxima de produção - por quanto tempo uma linha publicada precisa sobreviver para uma auditoria retroativa, e quem decide quando arquivá-la ou apagá-la. Nenhuma dessas duas perguntas tem resposta neste capítulo; ambas ficam registradas como trabalho futuro, não como comportamento implícito do código.
retry, dead_letter ou cancel - nunca um estado indefinido que alguém precisa adivinhar depois.Básico - deduplicar redelivery. Critério verificável: dado um evento já processado (mesmo eventId), uma segunda chamada a consumer.handle(event) retorna { applied: false, reason: 'duplicate_event' } e consumer.appliedEvents().length permanece 1. Solução comentada: createDedupingConsumer() em examples/src/outbox.mjs guarda um Set de eventIds vistos, independente do estado do outbox - é isso que garante que mesmo uma republicação do relay (não só uma redelivery de fila) seja absorvida no ponto certo. Ver o teste 'consumer dedupes redelivered events by eventId' em examples/idempotency.test.mjs, executado de fato (não apenas descrito) como parte de node --test examples/*.test.mjs.
Intermediário - injetar crash após outbox persistida e provar retomada. Critério verificável: injetar CrashSimulated no estágio after_commit_before_ack, confirmar que o job continua com status leased e que existe exatamente uma linha pendente no outbox, avançar o relógio além do lease, chamar processOnce() de novo e confirmar outcome === 'acked' com deduped === true. Solução comentada: o teste 'intermediate exercise: inject a crash right after the outbox commit and prove resumption end to end' em examples/crash-recovery.test.mjs faz exatamente essa sequência e termina publicando o evento e confirmando que o consumidor aplicou exatamente uma vez - comando real, node --test examples/crash-recovery.test.mjs, não trecho hipotético.
Avançado - contrastar simulador com integração transacional PostgreSQL/broker. Critério verificável (não executado nesta sessão - protocolo, não resultado): substituir os Maps de outbox.mjs por duas tabelas PostgreSQL escritas dentro de uma única transação por commitResultWithEvent, com idempotency_key como UNIQUE constraint; matar o processo (kill -9) entre os INSERTs e o COMMIT em um teste real e confirmar rollback completo; substituir a chamada direta de relayPublishOnce por um broker real com SELECT ... FOR UPDATE SKIP LOCKED para impedir que duas instâncias do relay disputem a mesma linha - exatamente o cenário de concorrência que o simulador deste capítulo, single-thread, não consegue exercitar. examples/pipeline-runbook.md lista, além disso, falhas que essa integração ainda não cobriria: partição de rede durante o commit (o chamador não pode tratar um timeout como "não aconteceu" e reprocessar às cegas) e perda de mensagem por má configuração do lado do broker.
Este capítulo garantiu que um efeito aconteça uma única vez mesmo sob crash - mas não decidiu nada sobre o que um agente deveria lembrar entre execuções diferentes, nem sobre quando uma resposta anterior do modelo deveria influenciar uma decisão futura sem virar um RAG por conveniência. O capítulo 5 parte exatamente daí: que proveniência uma memória de longo prazo carrega, e quem decide se ela pode ser usada quando o orçamento de uma tarefa já passou do previsto.
Produtos gratuitos e pagos para transformar ideias em uma base que você consegue executar.
13 produtos disponíveis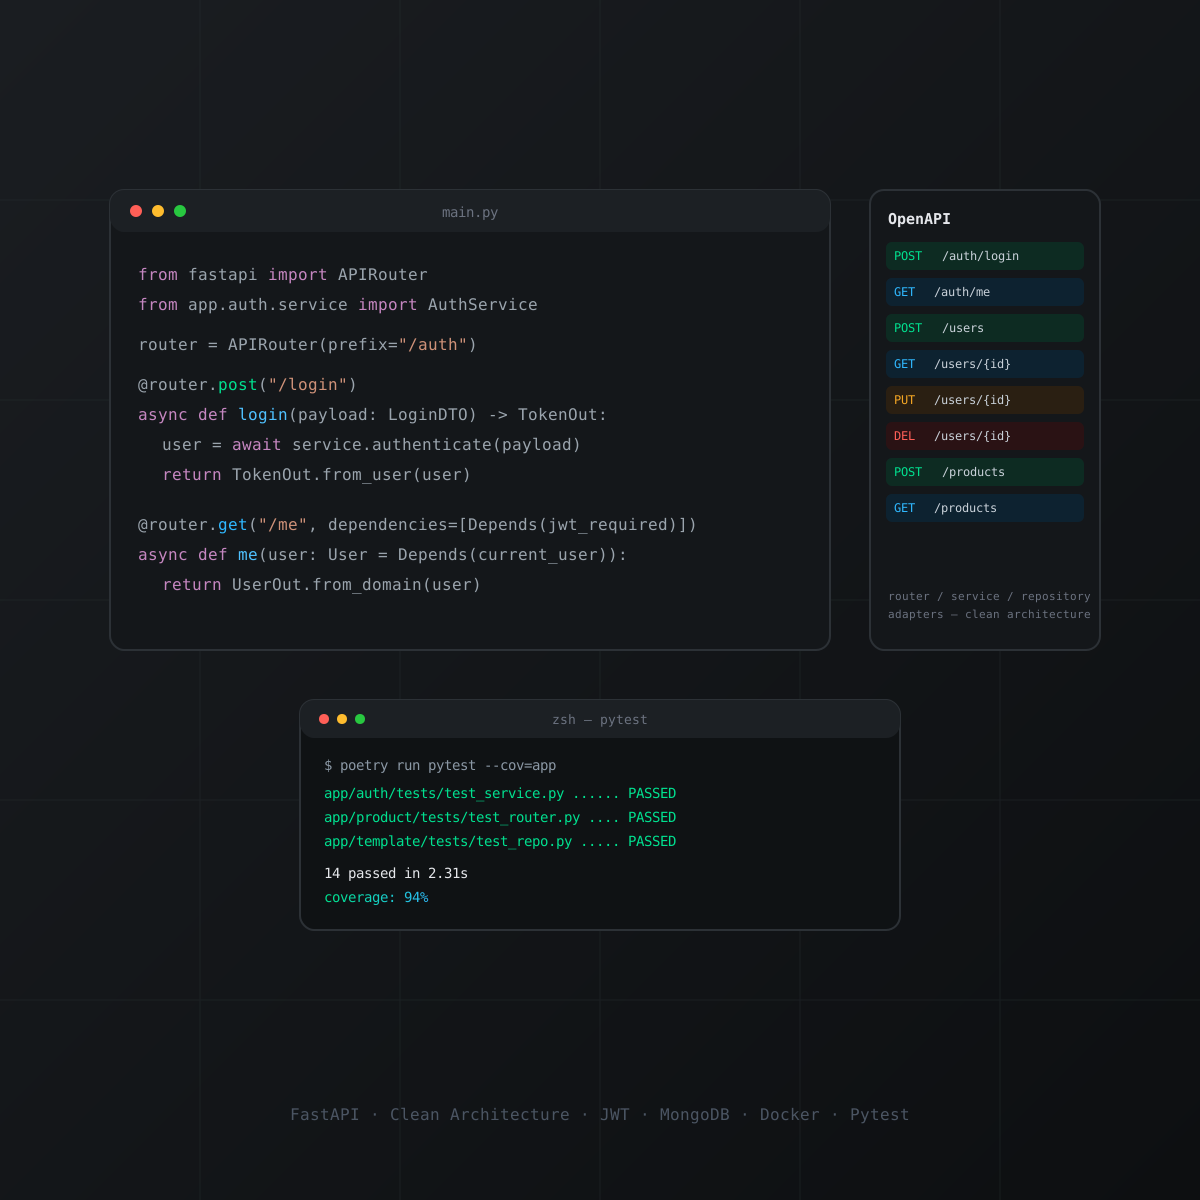
nextjs · boilerplate
Boilerplate de API em Python com FastAPI, organizado em Clean Architecture (router, service, repository e adapters por módulo). Inclui autenticação JWT com hashing bcrypt, MongoDB, testes com pytest e cobertura, Dockerfile e docker-compose para subir localmente, e documentação Swagger/OpenAPI automática. Repositório de origem privado; snapshot técnico verificado antes da publicação.
Ver produto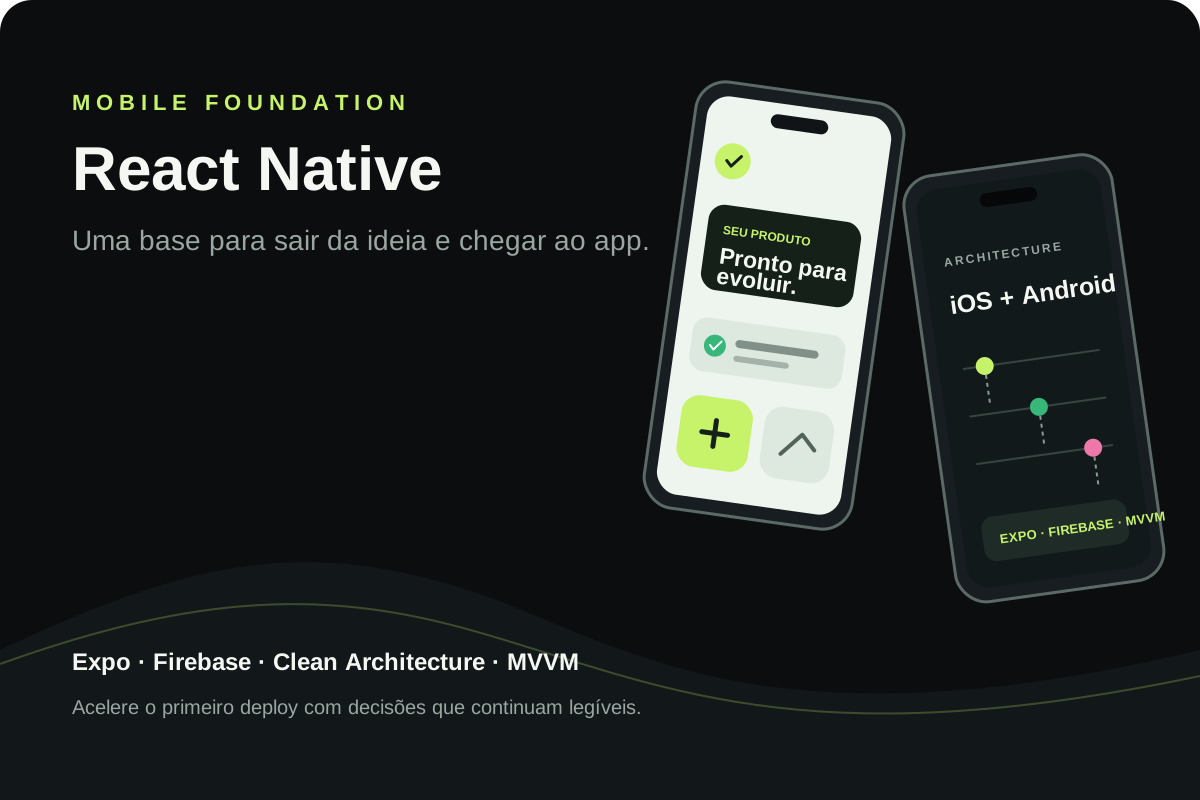
react · boilerplate
Base React Native para apps iOS e Android com Expo, Clean Architecture, MVVM, Firebase e módulos nativos. Referência técnica do VaiDeFut, com distribuição pública no Google Play e fluxo de publicação para iOS documentado.
Ver produto
nextjs · boilerplate
Kit gratuito e open source para começar com agentes de código em Claude Code, Codex, Gemini, Copilot e OpenCode. A licença MIT está confirmada no repositório público.
Ver produto
nextjs · boilerplate
Fundação AI-first white-label para lançar produtos SaaS com Next.js, chat, RAG, memória, tenants e documentação. O snapshot verificado documenta Supabase, não MongoDB; essa limitação está explícita. MongoDB, Redis e RabbitMQ exigem integração/configuração compatível.
Ver produtonextjs · boilerplate
Edição avançada da base white-label e multi-tenant AI-first para acelerar produtos com Next.js, chat, RAG, memória e documentação. O snapshot verificado ainda não comprova uma camada Ultra distinta; a oferta mantém essa limitação transparente e explicita as trocas de provider, cache e filas.
Ver produtonextjs · boilerplate
Base white-label e multi-tenant para transformar uma ideia em um SaaS AI-first com Next.js, chat, RAG, memória e segurança documentados. O snapshot verificado usa Supabase; o nome identifica o repositório de origem. Provider, cache e filas ficam explícitos; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · portfolio
Uma contribuição única para apoiar conteúdo técnico gratuito, pesquisa e a continuidade de projetos relevantes publicados por Anderson Lima. Você escolhe o valor; não é uma assinatura.
Ver produto
react · boilerplate
Starter React gratuito para criar uma suíte de testes confiável desde o primeiro commit, com Vitest, Testing Library, Playwright, Vite, TypeScript, Zustand, React Query, MirageJS e PWA. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
react · portfolio
Monorepo público em React, TypeScript e Vite para explorar uma biblioteca de componentes com linguagem visual inspirada em interfaces nativas. O README atual é enxuto e não declara uma licença SPDX; trate como preview gratuito.
Ver produto
nextjs · saas
Boilerplate SaaS AI-first com Next.js, Supabase, Stripe e provider routing para começar do primeiro prompt e acelerar o caminho até um deploy real. As adaptações de IA, banco, e-mail, cache e filas ficam explícitas; Redis e RabbitMQ são integrações configuráveis.
Ver produto
react · saas
Starter kit React + TypeScript para SaaS multi-tenant com Firebase, Atomic Design, temas, PWA, telas de produto, MirageJS e chat com Gemini extensível a outros providers. Valide requisitos de produção, custos e integrações antes de publicar.
Ver produto
react · boilerplate
Starter React público com TypeScript, Zustand, React Query, Tailwind CSS, PWA e integrações de IA documentadas. O repositório não declara uma licença SPDX; revise os termos antes de uso comercial.
Ver produto
nextjs · saas
Landing page SaaS para Next.js, TypeScript e Tailwind CSS com SEO, temas, i18n, PWA e pontos de integração para auth, Stripe e IA. Uma base clara para sair da tela vazia e adaptar sua proposta.
Ver produtoContinue explorando tópicos similares

Um deploy do RelayOps reduz erros HTTP e, na mesma semana, aumenta o número de extrações erradas aceitas como corretas. O capítulo 5 constrói dataset versionado, runners determinísticos, graders,…

Um documento pede, em texto puro, para o próprio agente exportar o arquivo do tenant e se autopromover. A defesa óbvia — instruir o modelo a recusar — roda na camada errada. O capítulo 7 constrói…

Um diagrama de microsserviços aparece antes de qualquer medição operacional. O capítulo final da série AI-native Architect usa uma simulação de tempo virtual para testar a ordem de atendimento por…
Checklist de 47 pontos para encontrar bugs, riscos de segurança e problemas de performance antes do lançamento.
Templates testados em produção, usados por desenvolvedores. Economize semanas de setup no seu próximo projeto.